
前两篇“基础知识”文章《计算机如何工作:费曼的高速档案员》和《计算机如何把 0 和 1 变成文字和图像》介绍了计算机如何执行指令,以及如何用存储的数值表示信息。而把这些信息送到另一台计算机,则是另一类问题:两台机器并不共享内存,彼此之间也不一定存在直接连接。在费曼的档案员模型中,档案员只要打开一个编号的抽屉,就能找到保存在身边的东西。但要取得远方另一台计算机上的信息,他必须发出请求并等待答复。这更像是给另一个办公室写信,而不是再打开一个抽屉。计算机本身可能早已准备好继续处理,却还没有收到答案。
互联网将不同组织运营的网络连接起来,使这样的交换成为可能。信息可以从设备最初接入的网络出发,经过其他几个网络,到达能够提供答复的服务,再沿着另一系列连接返回。理解信息经过的路径,以及负责提供答案的系统,就能解释为什么不同地区的访问体验会有差异、某些请求为什么缓慢,以及表面上互不相关的服务为什么可能同时出现故障。
从设备接入更广阔的网络
手机、笔记本电脑或其他设备首先建立本地连接,通常通过 Wi-Fi、移动网络或网线。随后,附近的网络设备将流量转发到更广阔的网络。对于家庭和办公室,互联网服务提供商(ISP)通常负责提供接入互联网的连接;移动通信运营商的网络发挥着类似作用。每家运营商都可以与其他网络交换流量,因此通信能够跨越不同组织和很远的距离,而无需在两台终端设备之间铺设一条专用的物理连接。
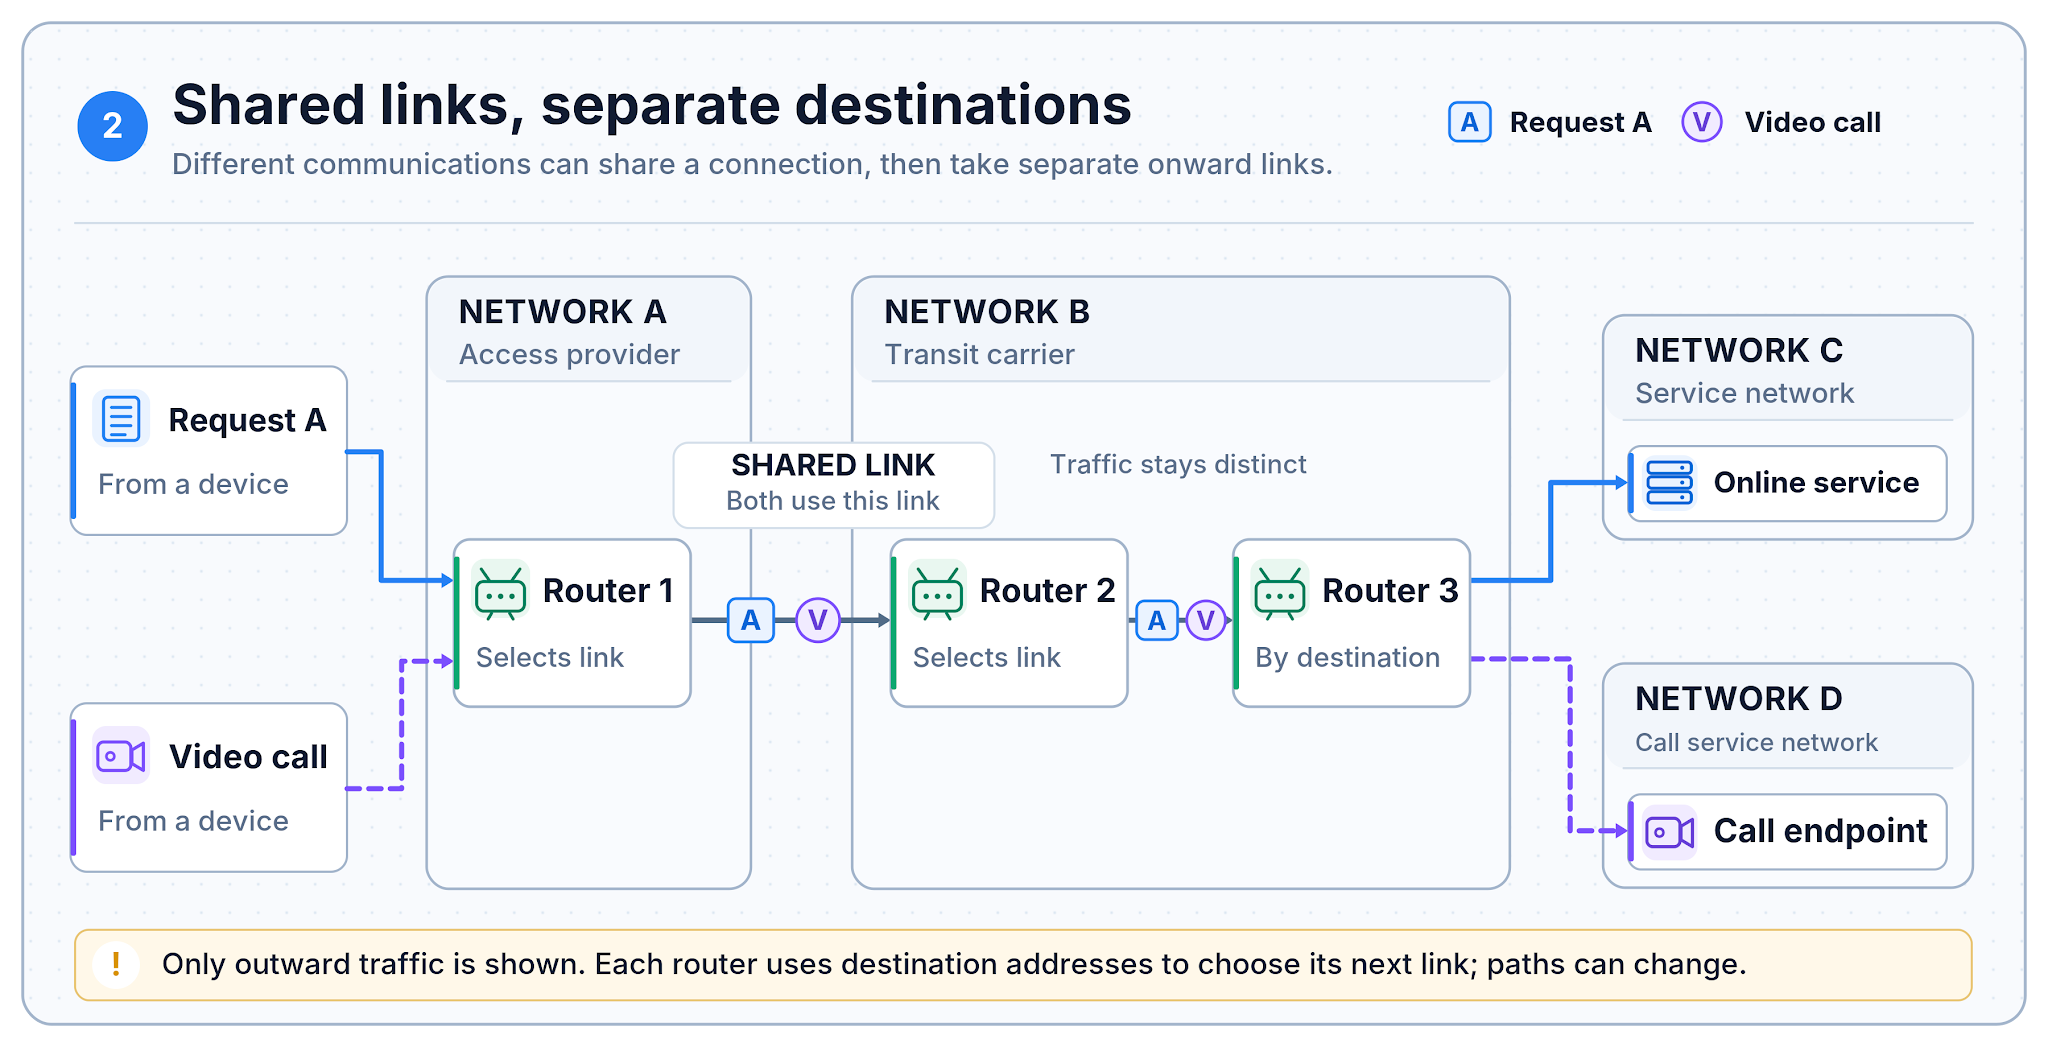
互联网之所以能达到这样的规模,是因为许多通信可以共用底层的链路和设备。视频通话、消息、文件下载和服务请求可能都经过同一段网络,共同使用其可用容量。为了确定每次传输的方向,互联网协议(IP)提供目的地址,路由器则根据这些地址选择下一步将流量送往哪里。一项服务可以对应多个地址,多台机器也可以呈现在同一个地址之后。地址使交付成为可能,却不代表唯一的物理路径或某一台特定机器。
服务名称如何变成地址
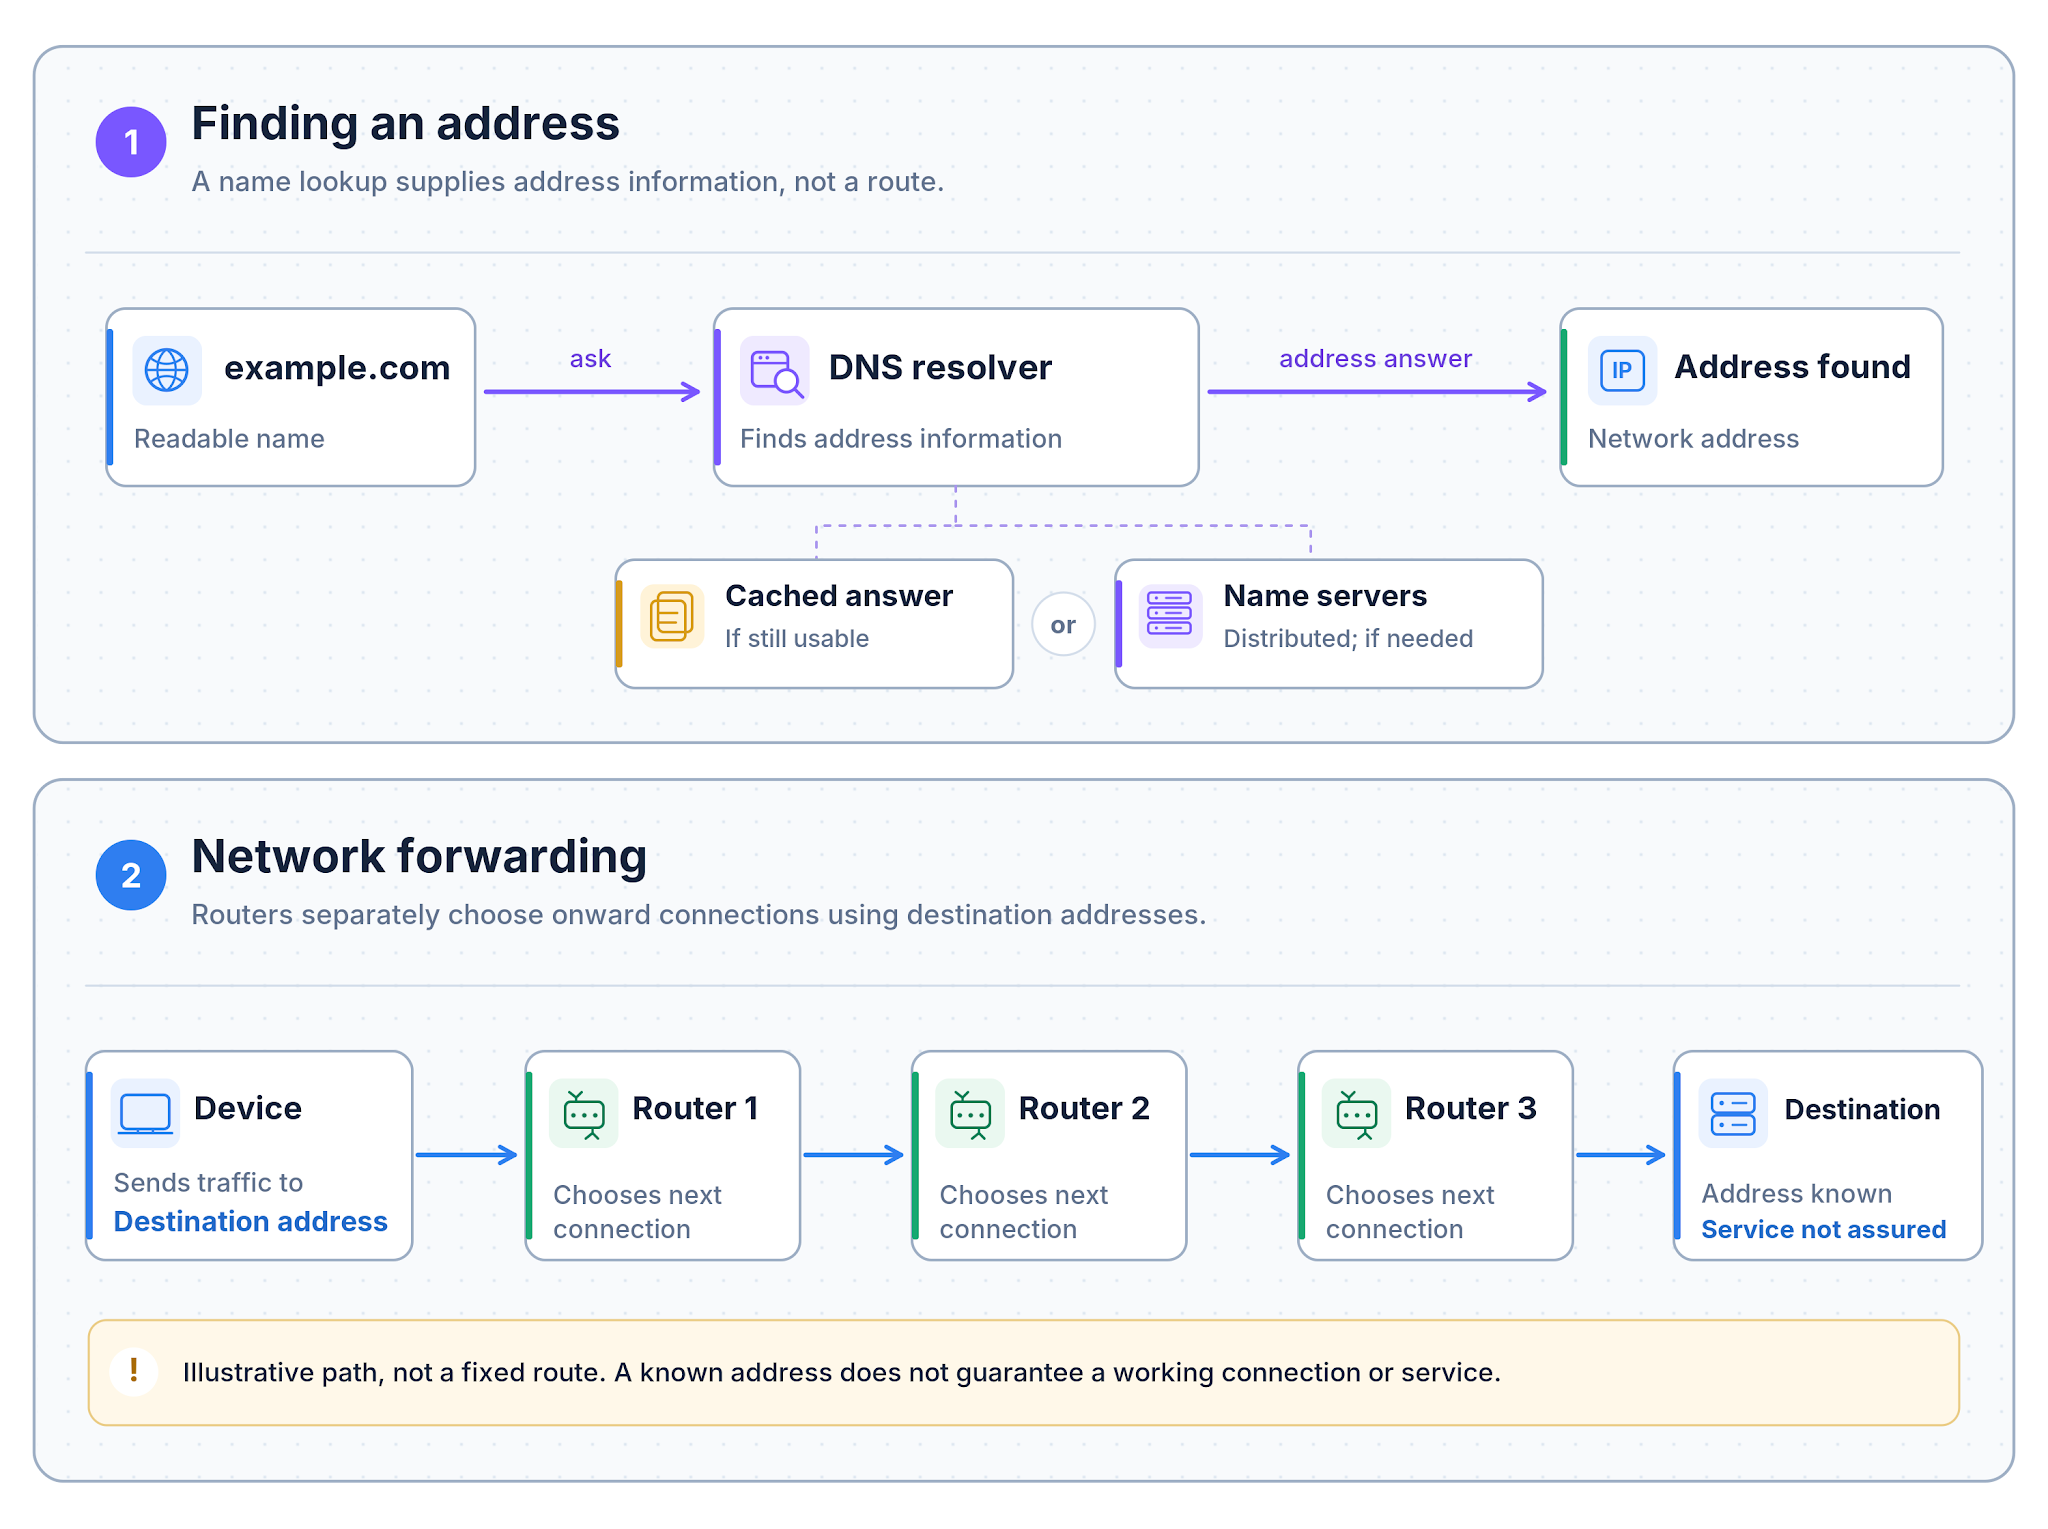
应用程序在联系 example.com 这样的具名服务之前,通常需要知道它的网络地址。域名系统(DNS)可以帮助查找地址,就像查到一间办公室的地址后才能寄信一样。所需地址可能已经保存在设备上;否则,设备可以询问 DNS 解析器。解析器可能返回缓存中的答案,也可能继续查询其他名称服务器。域名信息分散保存在许多系统中,并不存在一份囊括全世界的单一目录。一项服务可以有多个有效地址,而且这些地址会随时间变化。
如果所需答案尚未缓存,查找过程可能需要更多次网络通信,从而在应用发出真正的请求之前增加等待时间。即使目标系统本身正常,名称查询失败也可能导致用户无法通过名称访问它。找到地址仍不等于确定路线。应用获得地址后,会向该目的地发送流量;沿途各路由器根据自己的路由信息选择后续链路。名称查询既不决定流量采用哪条路径,也不保证服务一定会作出答复。
网络如何逐段转发信息
知道目的地址后,流量会先经过设备所在网络的默认网关,通常是一台路由器。网关把流量交给下一台路由器;后者依据目的地址和自己的路由信息选择后续链路。这个过程可能跨越多个组织运营的网络:本地服务提供商把流量交给另一家运营商,再由后者将流量送往目的地所属的网络。每台路由器只作出本地的转发决定,并不存在一个中央控制室,为每个请求统一安排完整旅程。即使通信来自不同设备、最终去往不同地方,也可能共用部分链路。
路由器之间的一次转发通常称为“一跳”(hop)。跳数更多,本身并不意味着延迟更长;实际经过的距离、可用链路、网络拥塞程度以及提供答复的系统所在位置也都重要。不同网络会交换路由信息,说明哪些目的地可以通过哪些相邻网络到达。一旦链路或网络发生故障,这些信息可能改变;如果存在可用的替代路径,而且运营商的策略允许,路由器就可能改走其他线路。路由更新需要时间,有些目的地则根本没有可用的替代路径。即使请求已经到达目的地,回复也可能沿着另一组路由器返回。
答案从哪里来,为什么需要等待
请求到达为目的地提供服务的基础设施后,仍需要某个系统准备答复。它可能要读取存储的信息、执行计算、检查权限,或者更新记录。提供服务的组织可以自行运营这些机器,也可以依赖托管服务提供商。因此,即使网络路径畅通,也不代表答案会及时到来。请求抵达之后,软件、存储或其他系统仍可能变慢、过载、配置错误,甚至不可用。即使是公开内容,反复从同一台远程机器获取没有变化的图片或文件,也可能浪费时间和网络容量。
适合复用的内容可以在不同地点保留副本。内容分发网络(CDN)能够直接利用缓存副本响应某些请求,而不必每次都联系原始来源,通常称为“源站”(origin)。如果没有合适的副本,分发系统可能先从另一层缓存或源站获取内容,再作出答复。登录、修改已保存的数据、查询最新信息等操作则可能需要重新处理。负责存储、处理和分发信息的系统可以属于不同组织,却对外表现为同一项服务。准备好的答案随后沿网络返回请求设备,由设备进行解释。
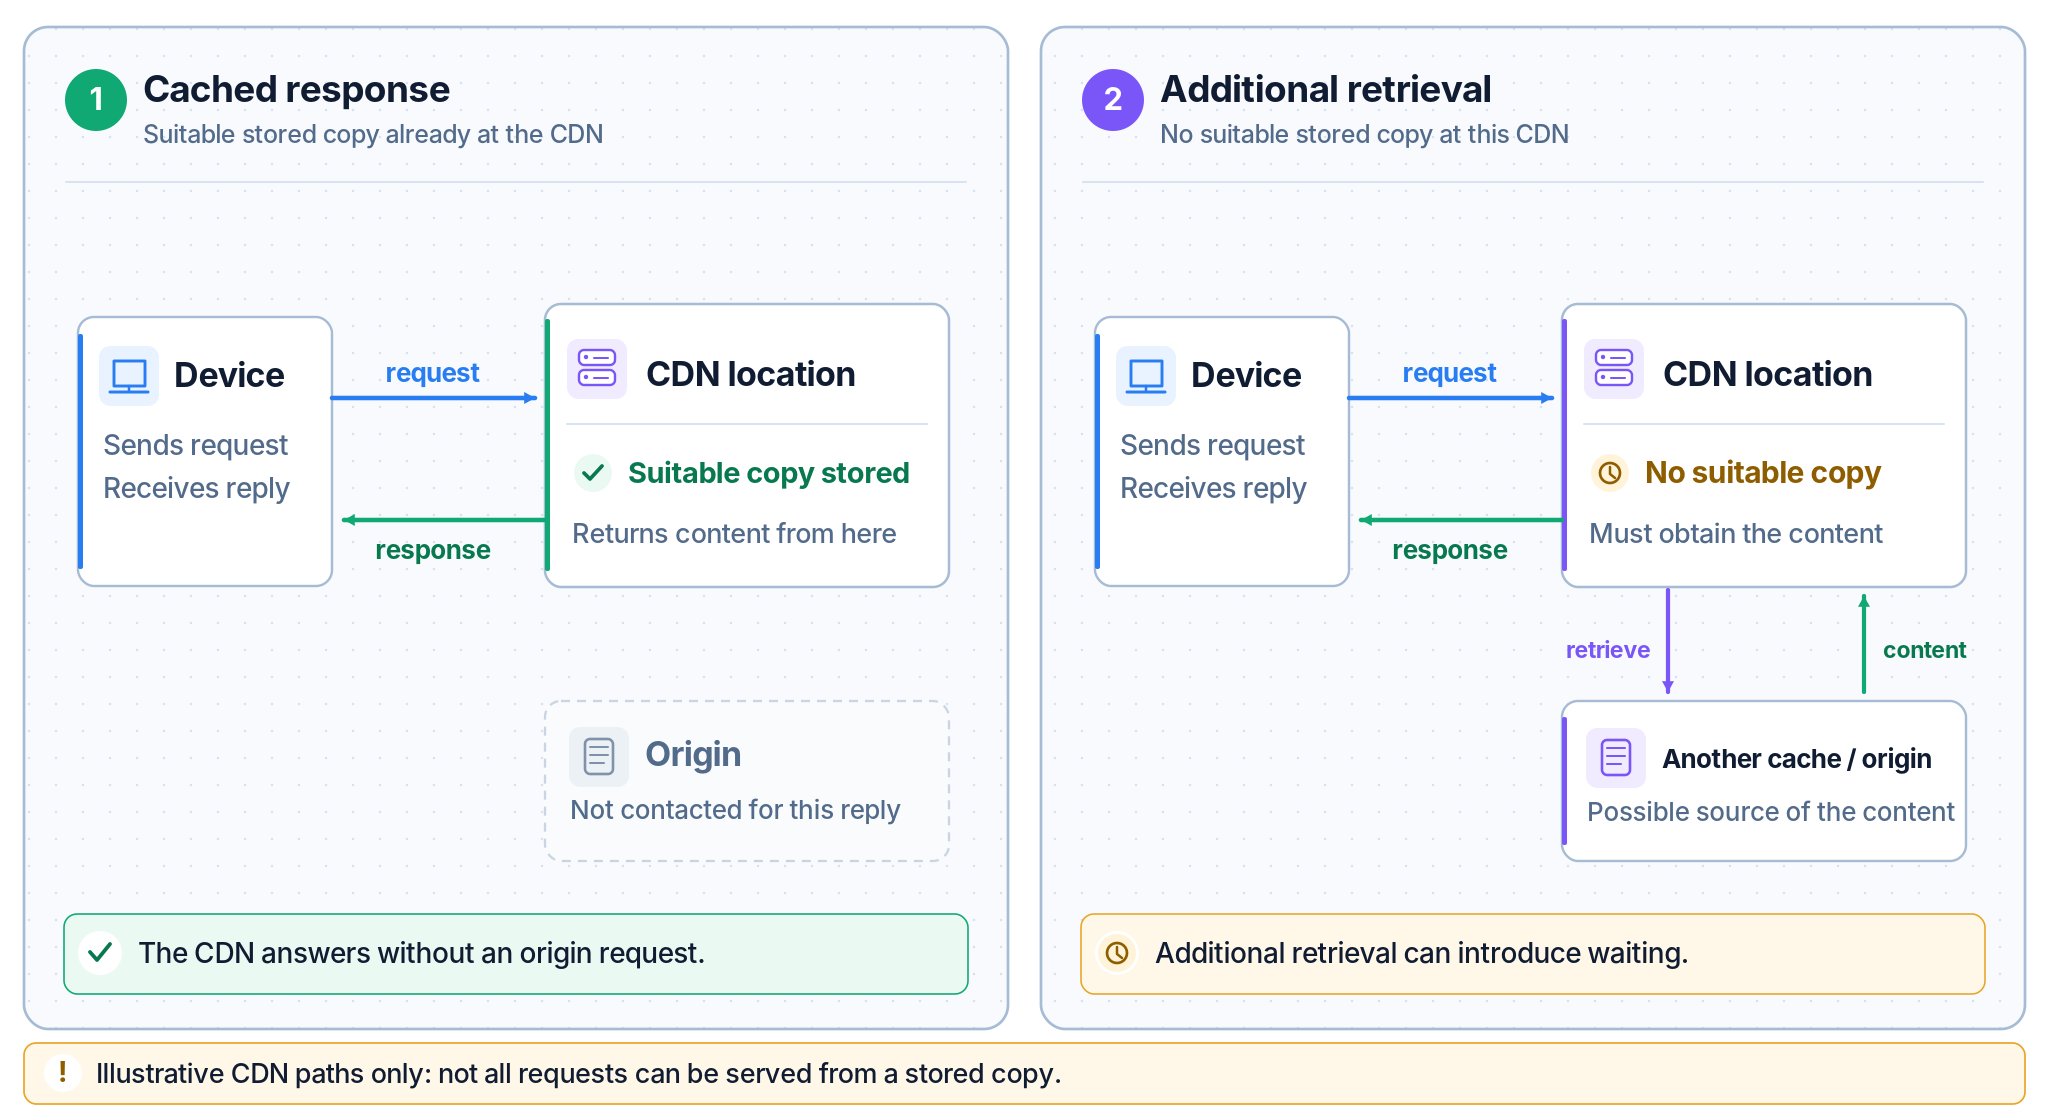
同一项服务,在一个地方可能感觉很快,在另一个地方却很迟缓。一位用户可能通过互联程度较高的网络连接到服务器或附近的 CDN 节点;另一位用户的请求则可能经过更长、更拥塞或不那么直接的链路。网络延迟描述信息在网络中传递所花费的时间。发出请求和传回回复的过程都会影响总等待时间。因此,地理位置最近的服务器不一定是网络中最快能够到达的服务器。沿途经过的路由器数量可以提供一些线索,却不能代替对实际通信耗时的测量。如果没有合适的缓存结果,名称查询也可能在请求开始前额外耗时。
交付时间还包括请求抵达后的处理过程。响应系统可能需要读取存储、生成结果、获取没有缓存的文件,或者等待另一项服务。即使连接能够高速传输大量数据,也无法消除这些环节的等待。如果答复耗时过长或始终没有到来,应用可能报告超时,也可能根据自身设计重试。因此,信息在哪里处理和保存,影响的不只是速度,还决定了请求成功所依赖的系统有哪些。当多项服务依赖同一套基础设施时,这一点尤为重要。
为什么多个服务会一起出故障
购物网站、银行应用和视频服务可能拥有不同的所有者、承担不同的功能,却依赖同一个基础设施组件。Amazon Web Services、Microsoft Azure 和 Google Cloud 等提供计算和存储服务;Cloudflare、Akamai 和 Amazon CloudFront 等则提供内容分发及其他网络服务。这些类别可能重叠,各家供应商也运营着许多彼此不同的组件。因此,知道两项服务使用同一家供应商,并不能证明它们依赖同一个技术组件,更不能据此断言某次故障的原因。关键在于:每项服务要完成某个具体操作,究竟必须依靠哪些组件。
单点故障(single point of failure,SPoF)是指一项操作必需、却没有有效替代方案的组件。它不一定是一台实体机器。一个平台可以运行在数千台计算机上,却仍依靠同一个逻辑系统进行身份检查、配置管理或访问存储信息。一旦这个系统失效,其他依然健康的机器也可能无法完成请求。地理分散只有在关键依赖足够独立时才有帮助:多个数据中心可能共用同一个控制服务,正如多个应用可能使用同一家供应商,却依赖其中不同、未受影响的组件。系统的韧性取决于设计能够承受哪些故障,而不是机器或站点有多少。
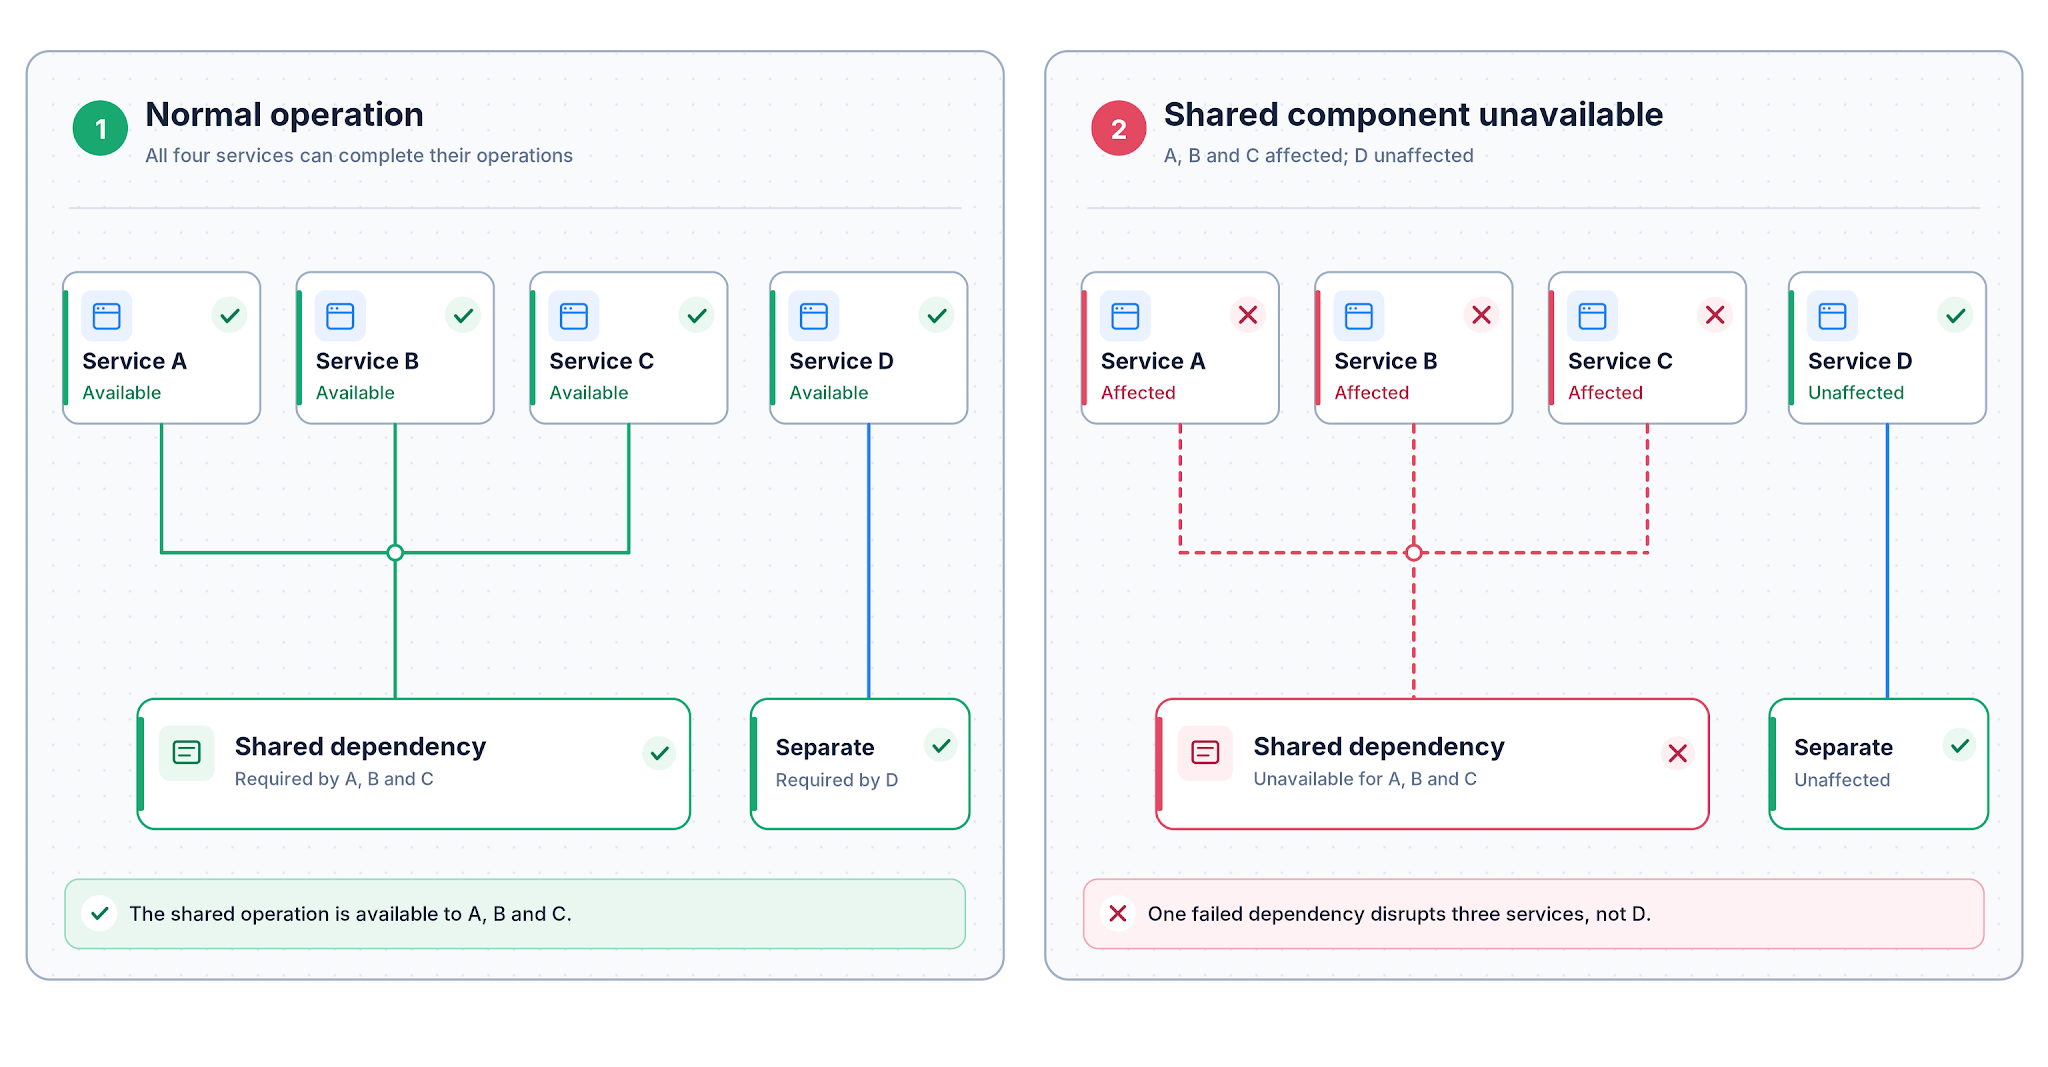
不同层面发生故障,用户看到的现象可能十分相似。接入网络可能失去通往健康服务的路径;域名解析、托管或内容分发基础设施可能停止工作;某个应用本身也可能在网络正常时出故障。因此,多个组织同时受到影响,提示可能存在共享依赖,却不能单凭现象确定失效的是哪个组件。
2026 年 10 月 20 日,一次电力事件扰乱了 Google Cloud 伦敦区域的服务;与此同时,Revolut、Lloyds 和 HSBC 的客户报告无法正常访问银行服务。Google 的初步事故报告指出,一个数据中心可用区的丧失还影响了该区域其他服务:工作负载转移到剩余基础设施,一些区域级系统却仍依赖位于不可用可用区内的组件。路透社报道将 Revolut 的服务中断与这次 Google Cloud 事件联系起来,但各家机构受到影响的具体技术故障路径,并没有得到公开证实。
类似事件也说明,单纯增加机器或备用网络路径并不足够。另一条网络路线无法修复已经失效的应用;如果所有服务器都依赖同一套控制系统,增设服务器也可能毫无帮助。备用方案只有在相关依赖真的失效时仍然可用,才算有意义。评估可靠性时,更有价值的问题是:哪些组件即使不可用,也不会阻止服务完成它本应完成的操作?
新闻应用如何获取文章
新闻应用可以具体说明软件架构如何改变故障影响的范围。它可以直接向多家出版机构获取内容,在需要时分别联系各个来源。如果其中一家不可用,只要通往其他来源的获取路径仍然正常,其他请求就仍可能成功。这并不表示各家出版机构完全独立,因为它们可能共用域名解析、托管或分发基础设施。但至少,应用没有额外引入一个必须始终可用的远程服务,来负责获取所有出版机构的新内容。
另一种新闻应用可能通过中央平台获取同样的内容,由该平台先汇集文章,再提供给应用。平台即使遍布许多服务器和地点,如果应用没有直接获取最新内容的替代路径,这项中央服务就成了每个所显示来源的必需依赖。即使出版机构仍在正常运行,中央平台的故障也可能阻断新内容的到达。两种架构的界面对读者来说或许几乎完全一样;区别在于,下一次请求要成功,究竟必须有哪些系统保持正常。
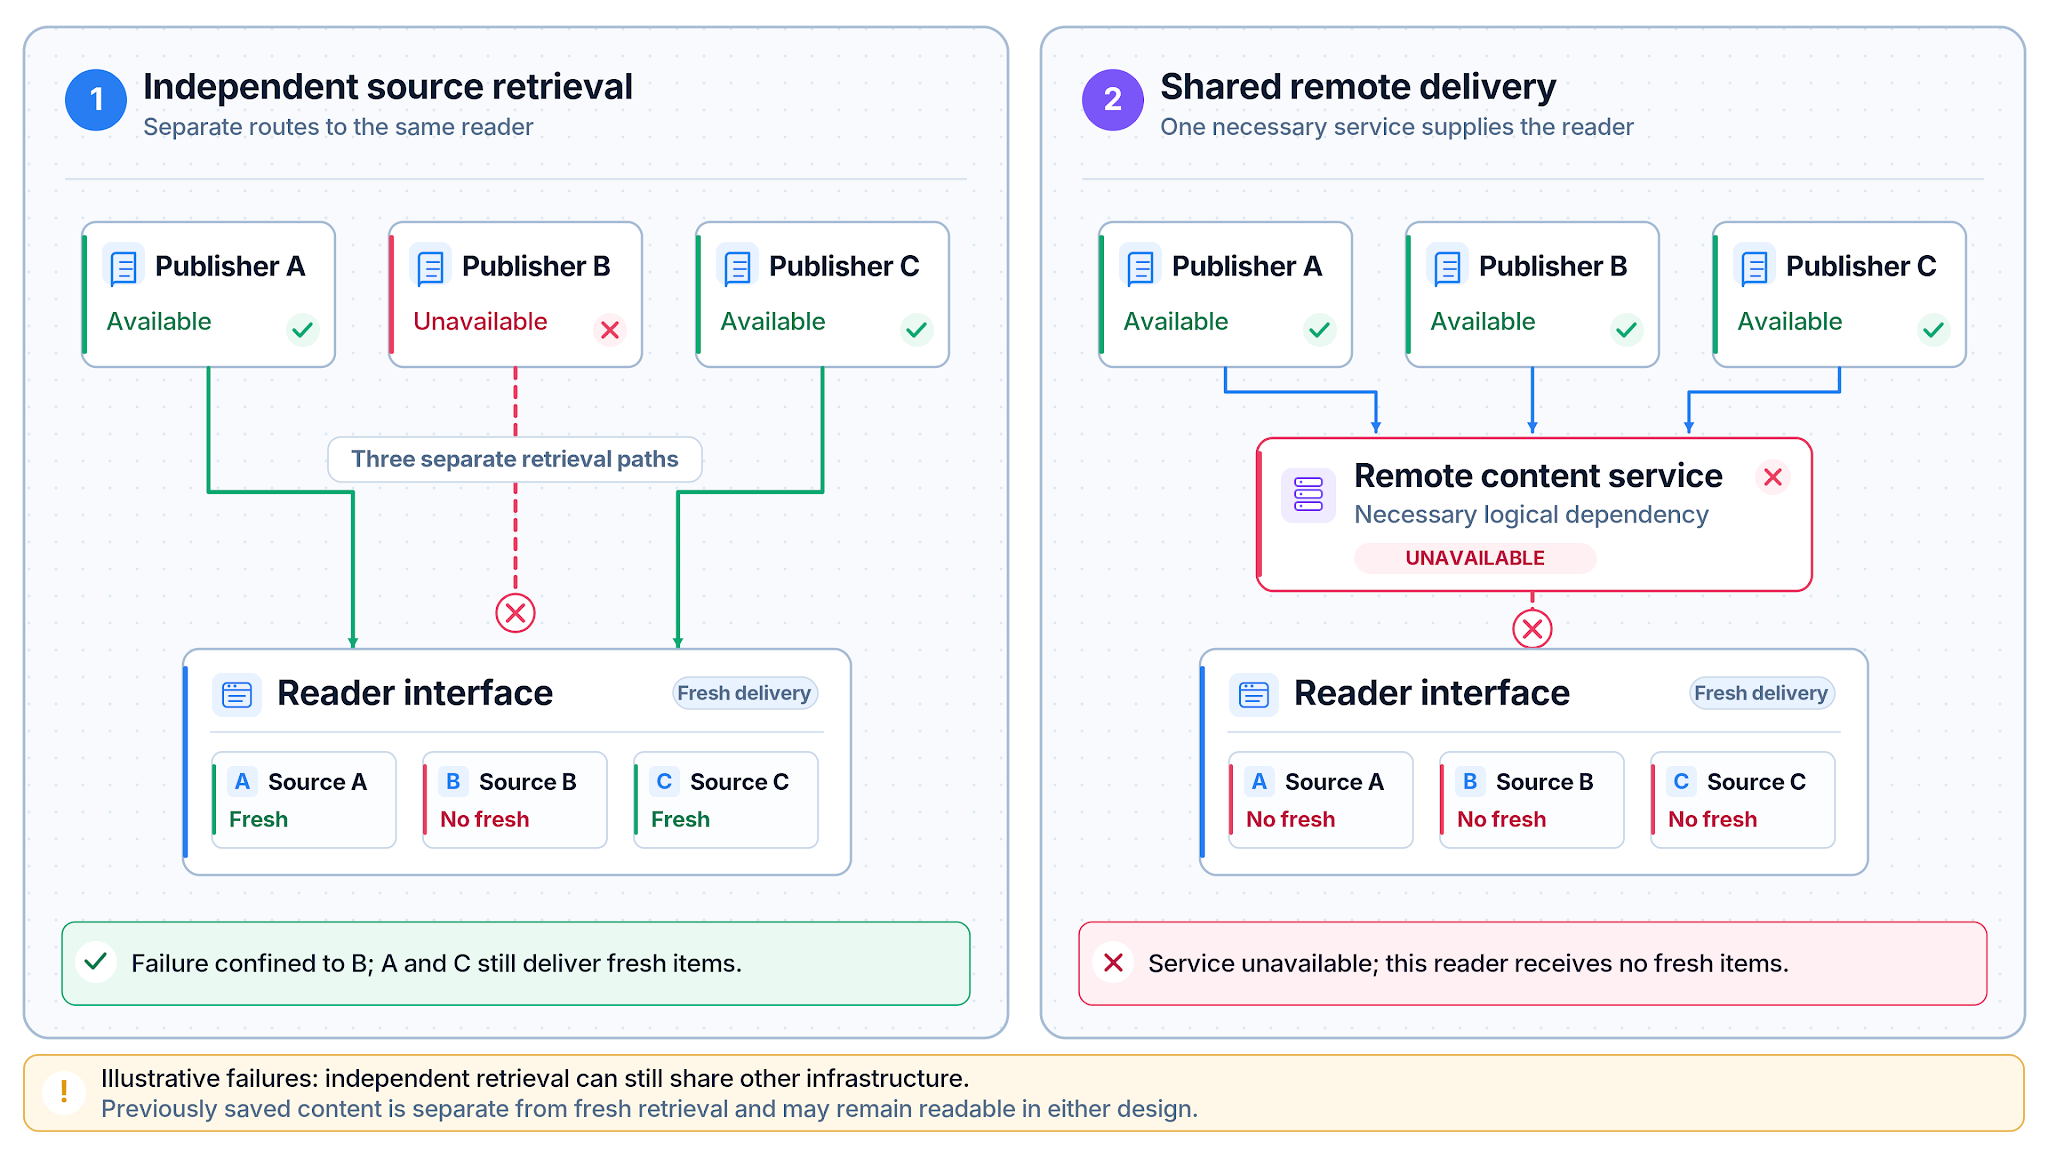
无论哪种架构发生中断,已经保存在设备上的材料仍可能可以阅读,但这并不意味着还能取得新材料。分发架构也决定了哪些参与方会处理信息。加密通常能保护信息在网络中传输的过程,限制沿途无关运营商读取内容的能力。不过,若中央分发平台终止连接或处理内容,它仍可能访问自己提供的信息。传输加密并不能判断该平台是否值得信任,或所提供的信息是否准确。这些区别同时影响可用性和数据处理方式,即使界面没有体现出来。
归根结底
互联网访问不只是设备拥有一条正常连接。每一次有用的答复,都依赖一条穿过不同组织所运营网络的路径,以及一组真正能够提供答案的系统。等待可能发生在这条链的两端,故障影响的范围则取决于哪些必需依赖被共同使用。架构中最不显眼的部分往往最为关键:多个组织可能依靠同一个重要组件,而一个应用也可能把多个独立来源集中为单一依赖。弄清答案实际来自哪里,以及什么可能阻止它到达,就能更好地理解那些看似无关的故障,也更容易判断一种设计是否可靠。
需要了解的术语
| 编号 | 术语 | 含义 |
|---|---|---|
| 1 | 单点故障(SPoF) | 某项操作必需、却没有有效替代方案的组件;它一旦失效,该操作就无法完成。 |
| 2 | 互联网服务提供商(ISP) | 为用户提供接入更广阔互联网连接的公司。 |
| 3 | 互联网协议(IP) | 为跨网络传输的信息提供目的地址的寻址体系。 |
| 4 | 内容分发网络(CDN) | 能从不同地点提供合适内容的副本,而不必每次都联系原始来源。 |
| 5 | 域名系统(DNS) | 帮助把 example.com 这样的名称转换为地址,但不负责选择网络路径。 |
参考资料
- Google Cloud Service Health(2026 年 10 月 22 日)。关于 10 月 20 日 europe-west2 区域服务中断的初步事故报告。 ↗
- Reuters(2026 年 10 月 21 日)。《Europe's financial regulators query Google over cloud outage that hit banks》。 ↗
- Synergy Research Group(2026 年 7 月 30 日)。《Q2 Cloud Market Passes $143 Billion; Highest Growth Rate in Eight Years》。2026 年第二季度全球云基础设施服务收入份额:Amazon 28%,Microsoft 20%,Google 15%。 ↗
- W3Techs(访问日期:2026 年 10 月 22 日)。《Usage statistics and market shares of reverse proxy services for websites》。衡量 Cloudflare、Amazon CloudFront、Fastly、Akamai 等服务在所观察网站上的使用情况,而非 CDN 收入或流量份额。 ↗