
फ़ाउंडेशन्स शृंखला के पिछले लेखों, «कंप्यूटर कैसे काम करते हैं: फ़ाइनमैन का बेहद तेज़ फ़ाइल क्लर्क» और «कंप्यूटर 0 और 1 को शब्दों और तस्वीरों में कैसे बदलते हैं», में बताया गया था कि कंप्यूटर निर्देशों का पालन कैसे करता है और जानकारी को संग्रहीत मानों के रूप में कैसे दर्शाता है। उस जानकारी को दूसरे कंप्यूटर तक पहुँचाने में एक अलग कठिनाई है: दोनों मशीनों की मेमरी साझा नहीं होती और उनके बीच सीधा कनेक्शन होना भी ज़रूरी नहीं है। फ़ाइनमैन के फ़ाइल क्लर्क को पास रखी जानकारी चाहिए, तो वह नंबर वाली दराज़ खोल सकता है। लेकिन दूर के किसी कंप्यूटर में रखी जानकारी के लिए उसे अनुरोध भेजकर उत्तर की प्रतीक्षा करनी पड़ेगी। यह दूसरी दराज़ खोलने के बजाय दूसरे दफ़्तर को पत्र लिखने जैसा है। कंप्यूटर अगला काम करने के लिए तैयार हो सकता है, जबकि जवाब आने में अभी काफ़ी समय बाकी हो।
इंटरनेट अलग-अलग संगठनों के चलाए हुए नेटवर्क को जोड़कर इस तरह का आदान-प्रदान संभव बनाता है। जानकारी पहले उस नेटवर्क से निकलती है जिससे उपकरण जुड़ा है, फिर कई दूसरे नेटवर्कों से गुज़रकर ऐसी सेवा तक पहुँच सकती है जो उत्तर दे सके। इसके बाद जवाब दूसरे कनेक्शनों की शृंखला से लौट सकता है। इस सफ़र और जवाब तैयार करने वाली प्रणालियों को साथ समझने से स्पष्ट होता है कि अलग-अलग स्थानों से पहुँच में फ़र्क़ क्यों पड़ता है, कुछ अनुरोध धीमे क्यों होते हैं और ऊपर से असंबंधित दिखने वाली सेवाएँ एक साथ क्यों बंद हो सकती हैं।
उपकरण से बड़े नेटवर्क तक
फ़ोन, लैपटॉप या दूसरा उपकरण सबसे पहले किसी स्थानीय कनेक्शन से जुड़ता है, अक्सर वाई-फ़ाई, मोबाइल नेटवर्क या केबल से। वहाँ से पास मौजूद नेटवर्क उपकरण डेटा ट्रैफ़िक को बड़े नेटवर्क की ओर भेजते हैं। घर और दफ़्तर के कनेक्शन में इंटरनेट सेवा प्रदाता (ISP) आम तौर पर बड़े इंटरनेट नेटवर्क तक पहुँच देता है; मोबाइल कनेक्शन में ऑपरेटर का नेटवर्क यही भूमिका निभाता है। हर प्रदाता दूसरे नेटवर्कों से डेटा का आदान-प्रदान कर सकता है। इसलिए दोनों अंतिम उपकरणों के बीच अलग से कोई सीधी भौतिक लाइन बनाए बिना संचार कई संगठनों और लंबी दूरियों से गुज़र सकता है।
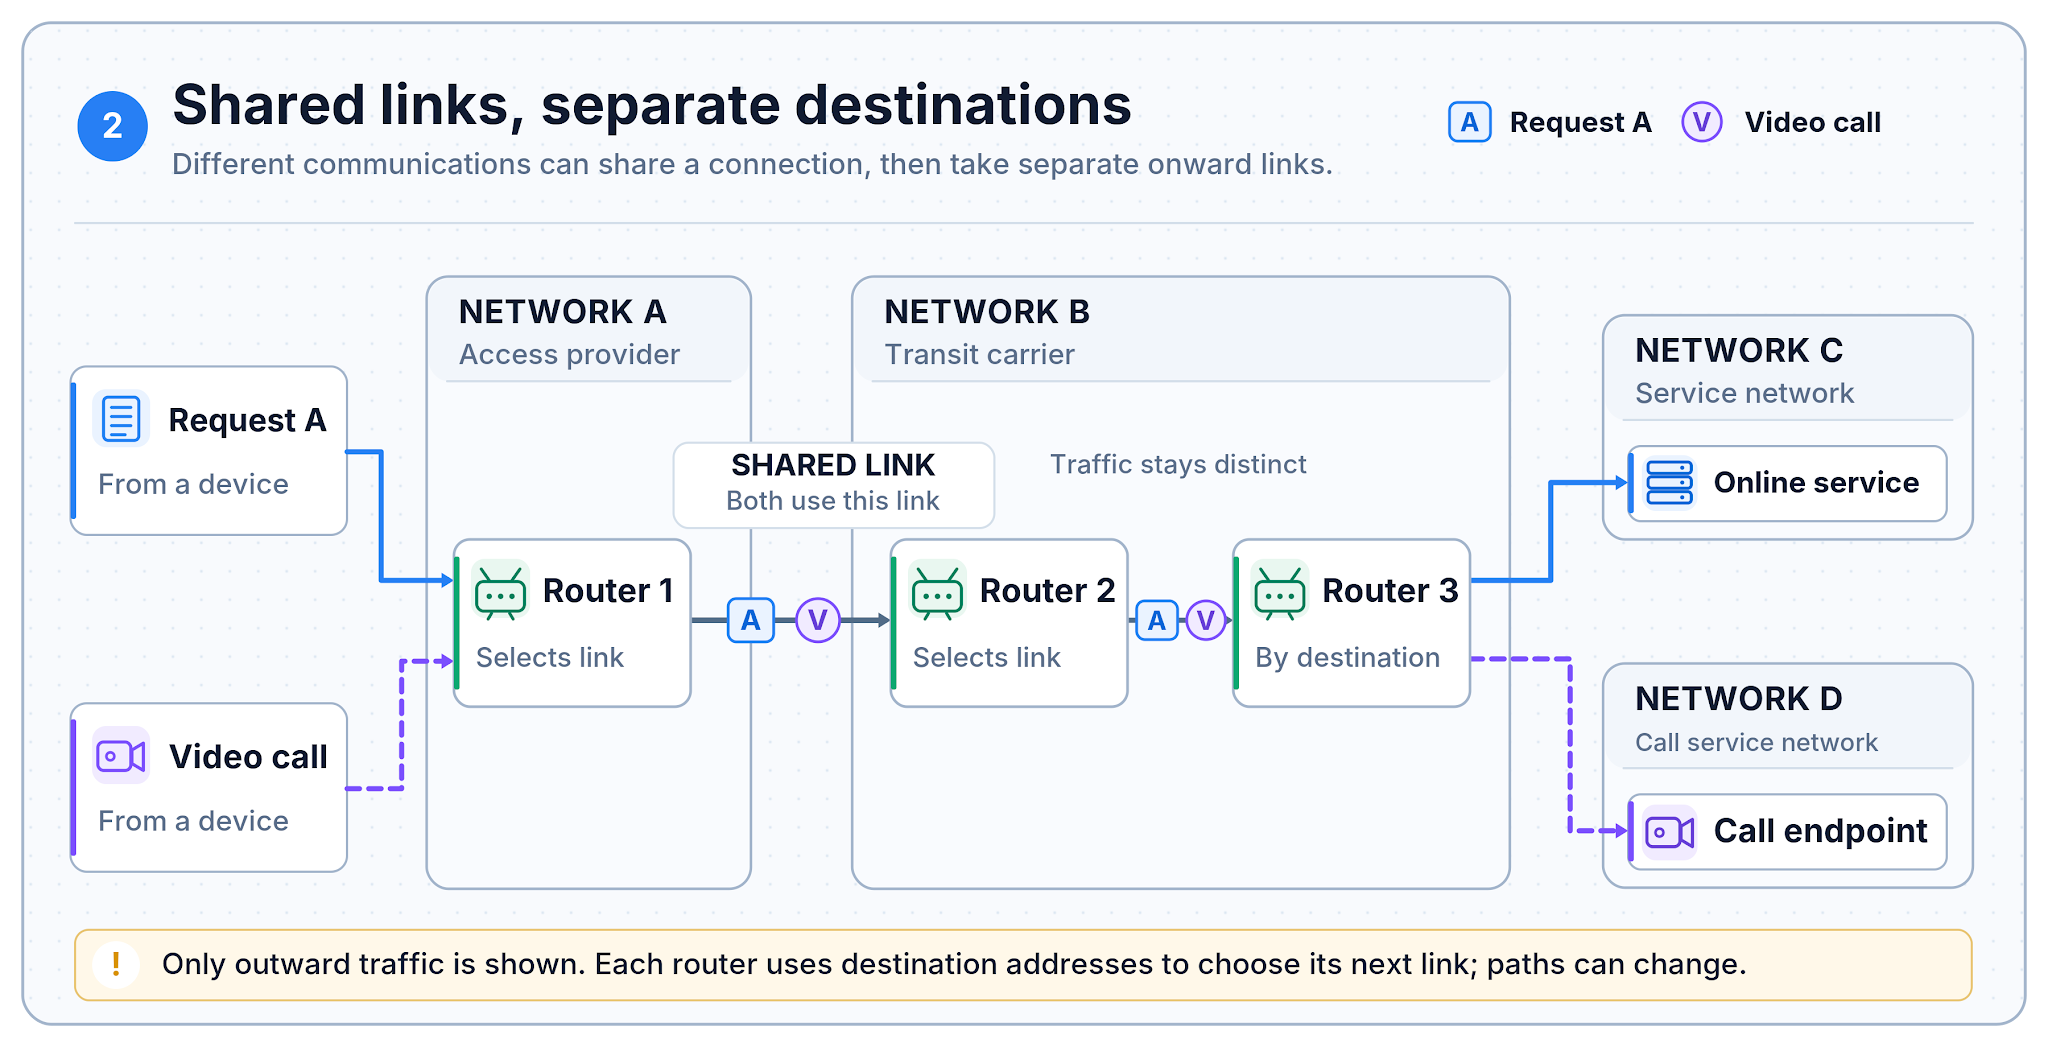
इंटरनेट इतने बड़े स्तर पर इसलिए काम कर पाता है क्योंकि बहुत-से संचार एक ही लिंक और नेटवर्क उपकरणों का इस्तेमाल कर सकते हैं। वीडियो कॉल, संदेश, फ़ाइल डाउनलोड और किसी सेवा को भेजा गया अनुरोध नेटवर्क का कुछ हिस्सा साझा कर सकते हैं और उसकी उपलब्ध क्षमता में से अपना हिस्सा लेते हैं। इंटरनेट प्रोटोकॉल (IP) गंतव्य के पते उपलब्ध कराता है और राउटर उन पतों के आधार पर तय करते हैं कि ट्रैफ़िक को आगे कहाँ भेजना है। किसी सेवा के कई पते हो सकते हैं और कई मशीनें एक ही पते के पीछे दिखाई दे सकती हैं। पता डेटा पहुँचाने में मदद करता है, लेकिन किसी एक भौतिक रास्ते या एक निश्चित मशीन की पहचान नहीं बताता।
किसी सेवा का नाम पते में कैसे बदलता है
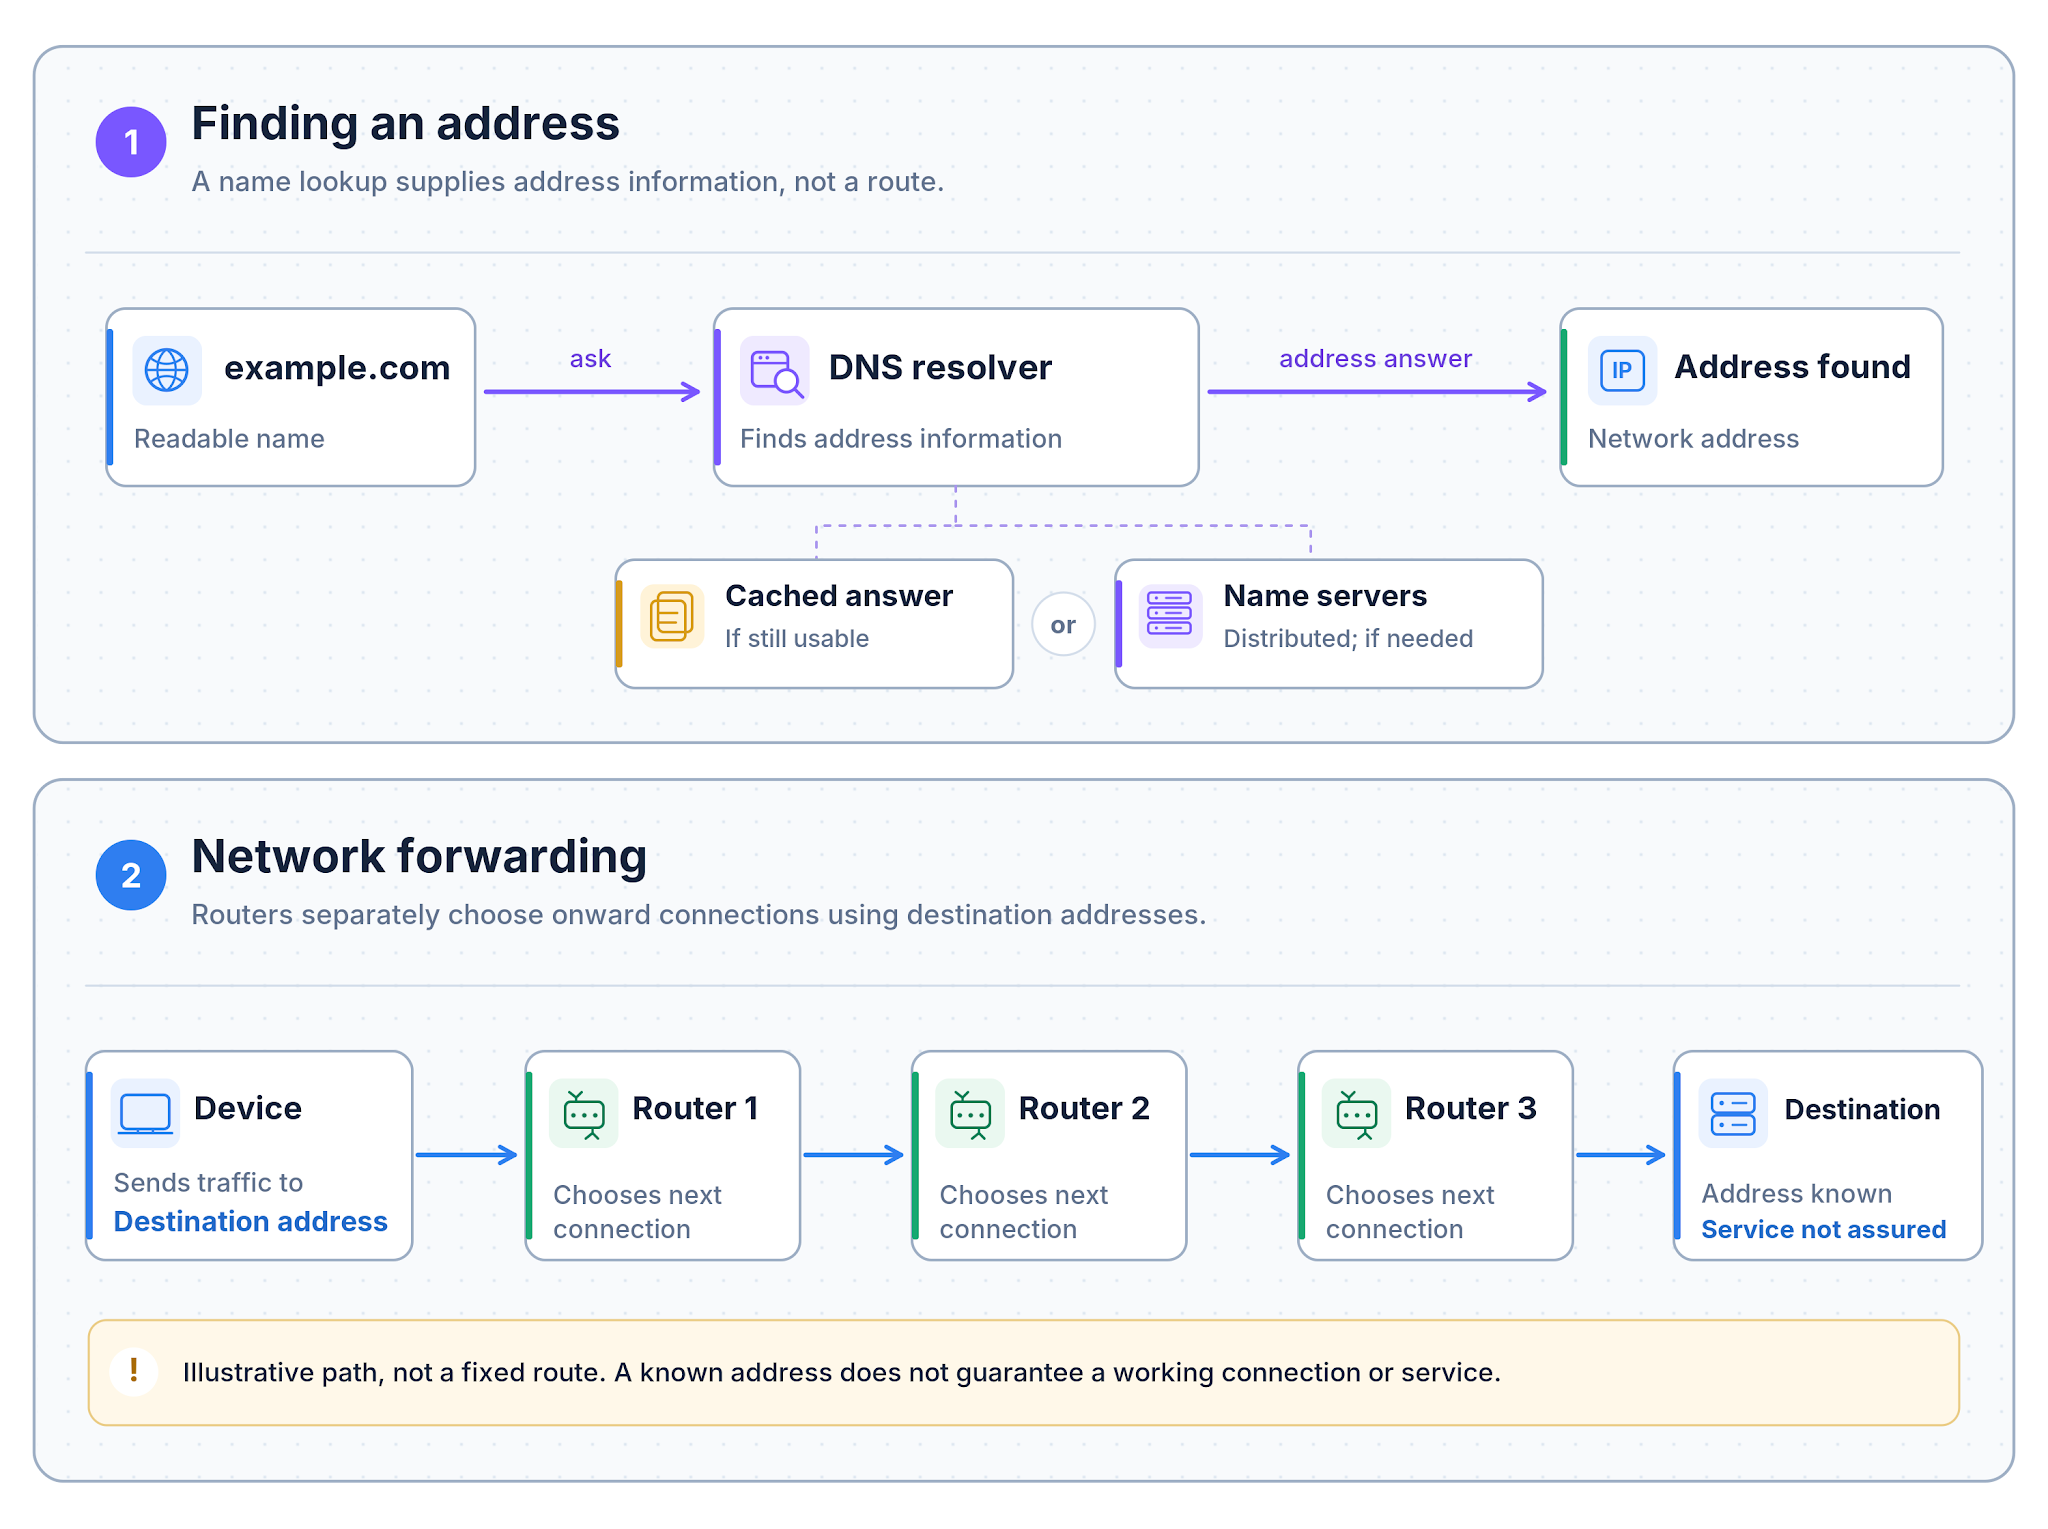
example.com जैसी नाम से पहचानी जाने वाली सेवा से संपर्क करने के लिए ऐप को आम तौर पर नेटवर्क पता चाहिए। डोमेन नेम सिस्टम (DNS) ऐसा पता खोजने में मदद करता है, जैसे किसी दफ़्तर का पता मालूम होने पर उसे पत्र भेजा जा सकता है। हो सकता है कि पता उपकरण में पहले से सेव हो। अन्यथा उपकरण किसी DNS रिज़ॉल्वर से पूछ सकता है। रिज़ॉल्वर कैश में रखा उत्तर लौटा सकता है या दूसरे नेम सर्वरों से जानकारी ले सकता है। नामों की जानकारी दुनिया भर के अनेक सिस्टमों में बँटी होती है; वह किसी एक वैश्विक निर्देशिका में नहीं रखी जाती। एक सेवा के कई मान्य पते हो सकते हैं, जो समय के साथ बदल भी सकते हैं।
ज़रूरी उत्तर कैश में न हो, तो उसे खोजने के लिए नेटवर्क पर और संदेश भेजने पड़ सकते हैं। इससे ऐप के वास्तविक अनुरोध भेजने से पहले ही देर हो सकती है। नाम की जानकारी न मिल पाने पर, गंतव्य के सिस्टम सही चल रहे हों तब भी सेवा का नाम इस्तेमाल करके उस तक पहुँचना संभव नहीं होगा। पता मिलना रास्ता मिल जाने के बराबर नहीं है। पता मिलते ही ऐप गंतव्य की ओर ट्रैफ़िक भेजता है और रास्ते का हर राउटर अपनी रूटिंग जानकारी से अगला लिंक चुनता है। DNS खोज यह तय नहीं करती कि डेटा किस रास्ते से जाएगा या सेवा जवाब देगी भी या नहीं।
नेटवर्क जानकारी को आगे कैसे भेजते हैं
गंतव्य का पता मिलने के बाद डेटा का सफ़र उपकरण के स्थानीय गेटवे से शुरू होता है, जो आम तौर पर राउटर होता है। गेटवे ट्रैफ़िक अगले राउटर को देता है, और वह गंतव्य का पता तथा अपनी रूटिंग जानकारी देखकर आगे का कनेक्शन चुनता है। इस क्रम में कई संगठनों के नेटवर्क शामिल हो सकते हैं। स्थानीय प्रदाता किसी दूसरे ऑपरेटर को ट्रैफ़िक सौंप सकता है, जो उसे गंतव्य वाले नेटवर्क के करीब ले जाता है। हर राउटर केवल अपने स्तर पर आगे भेजने का निर्णय करता है। ऐसा कोई केंद्रीय नियंत्रण कक्ष नहीं है जो हर अनुरोध का पूरा रास्ता तय करता हो। अलग स्रोतों से निकला और अलग जगहों पर जाने वाला डेटा भी रास्ते के कुछ लिंक साझा कर सकता है।
एक राउटर से अगले राउटर तक डेटा आगे भेजने के चरण को नेटवर्किंग में हॉप (hop) कहते हैं। केवल हॉप की संख्या अधिक होने से यह साबित नहीं होता कि देरी भी अधिक होगी। तय की गई दूरी, उपलब्ध लिंक, नेटवर्क पर भीड़ और उत्तर देने वाले सिस्टम की जगह भी मायने रखती है। नेटवर्क आपस में यह जानकारी साझा करते हैं कि कौन-सा गंतव्य किस पड़ोसी नेटवर्क के ज़रिए पहुँचा जा सकता है। कोई लिंक या नेटवर्क बंद हो जाए, तो यह जानकारी बदल सकती है और राउटर दूसरे रास्ते अपना सकते हैं, बशर्ते रास्ते उपलब्ध हों और ऑपरेटर की नीतियाँ उन्हें इस्तेमाल करने दें। इन रास्तों की जानकारी बदलने में समय लग सकता है; कुछ गंतव्यों के लिए कोई विकल्प होता ही नहीं। अनुरोध पहुँच जाने पर भी जवाब लौटते समय दूसरे राउटरों से होकर आ सकता है।
जवाब कहाँ से आते हैं और उनमें समय क्यों लगता है
अनुरोध गंतव्य की सेवा देने वाले इंफ़्रास्ट्रक्चर तक पहुँच जाए, तब भी किसी सिस्टम को जवाब तैयार करना होता है। उसे सेव की गई जानकारी पढ़नी पड़ सकती है, कोई गणना करनी पड़ सकती है, अनुमतियाँ जाँचनी पड़ सकती हैं या कोई रिकॉर्ड बदलना पड़ सकता है। सेवा देने वाला संगठन मशीनें स्वयं चला सकता है या होस्टिंग प्रदाता पर निर्भर हो सकता है। इसलिए नेटवर्क का रास्ता ठीक होने से समय पर जवाब मिलने की गारंटी नहीं मिलती। अनुरोध पहुँचने के बाद सॉफ़्टवेयर, स्टोरेज और अन्य सिस्टम धीमे, अत्यधिक व्यस्त, गलत कॉन्फ़िगरेशन वाले या अनुपलब्ध हो सकते हैं। सार्वजनिक सामग्री के मामले में भी वही अपरिवर्तित तस्वीर या फ़ाइल बार-बार दूर की मशीन से माँगने पर समय और नेटवर्क क्षमता व्यर्थ हो सकती है।
उपयुक्त सामग्री की प्रतियाँ अलग-अलग स्थानों पर रखी जा सकती हैं। कंटेंट डिलीवरी नेटवर्क (CDN) कुछ अनुरोधों का जवाब मूल स्रोत से संपर्क किए बिना कैश में रखी प्रति से दे सकता है। इस मूल स्रोत को आम तौर पर ऑरिजिन (origin) कहा जाता है। उपयुक्त प्रति उपलब्ध न हो, तो जवाब देने से पहले सामग्री किसी दूसरे कैश या ऑरिजिन से लानी पड़ सकती है। लॉग इन करना, संग्रहीत डेटा बदलना या ताज़ा जानकारी माँगना जैसे दूसरे कामों के लिए नई प्रोसेसिंग की ज़रूरत हो सकती है। जानकारी रखने, प्रोसेस करने और पहुँचाने वाले सिस्टम अलग-अलग संगठनों के हो सकते हैं, फिर भी बाहर से एक ही सेवा दिखाई दे सकते हैं। तैयार जवाब नेटवर्क से वापस अनुरोध करने वाले उपकरण तक आता है, जो उसका अर्थ समझता है।
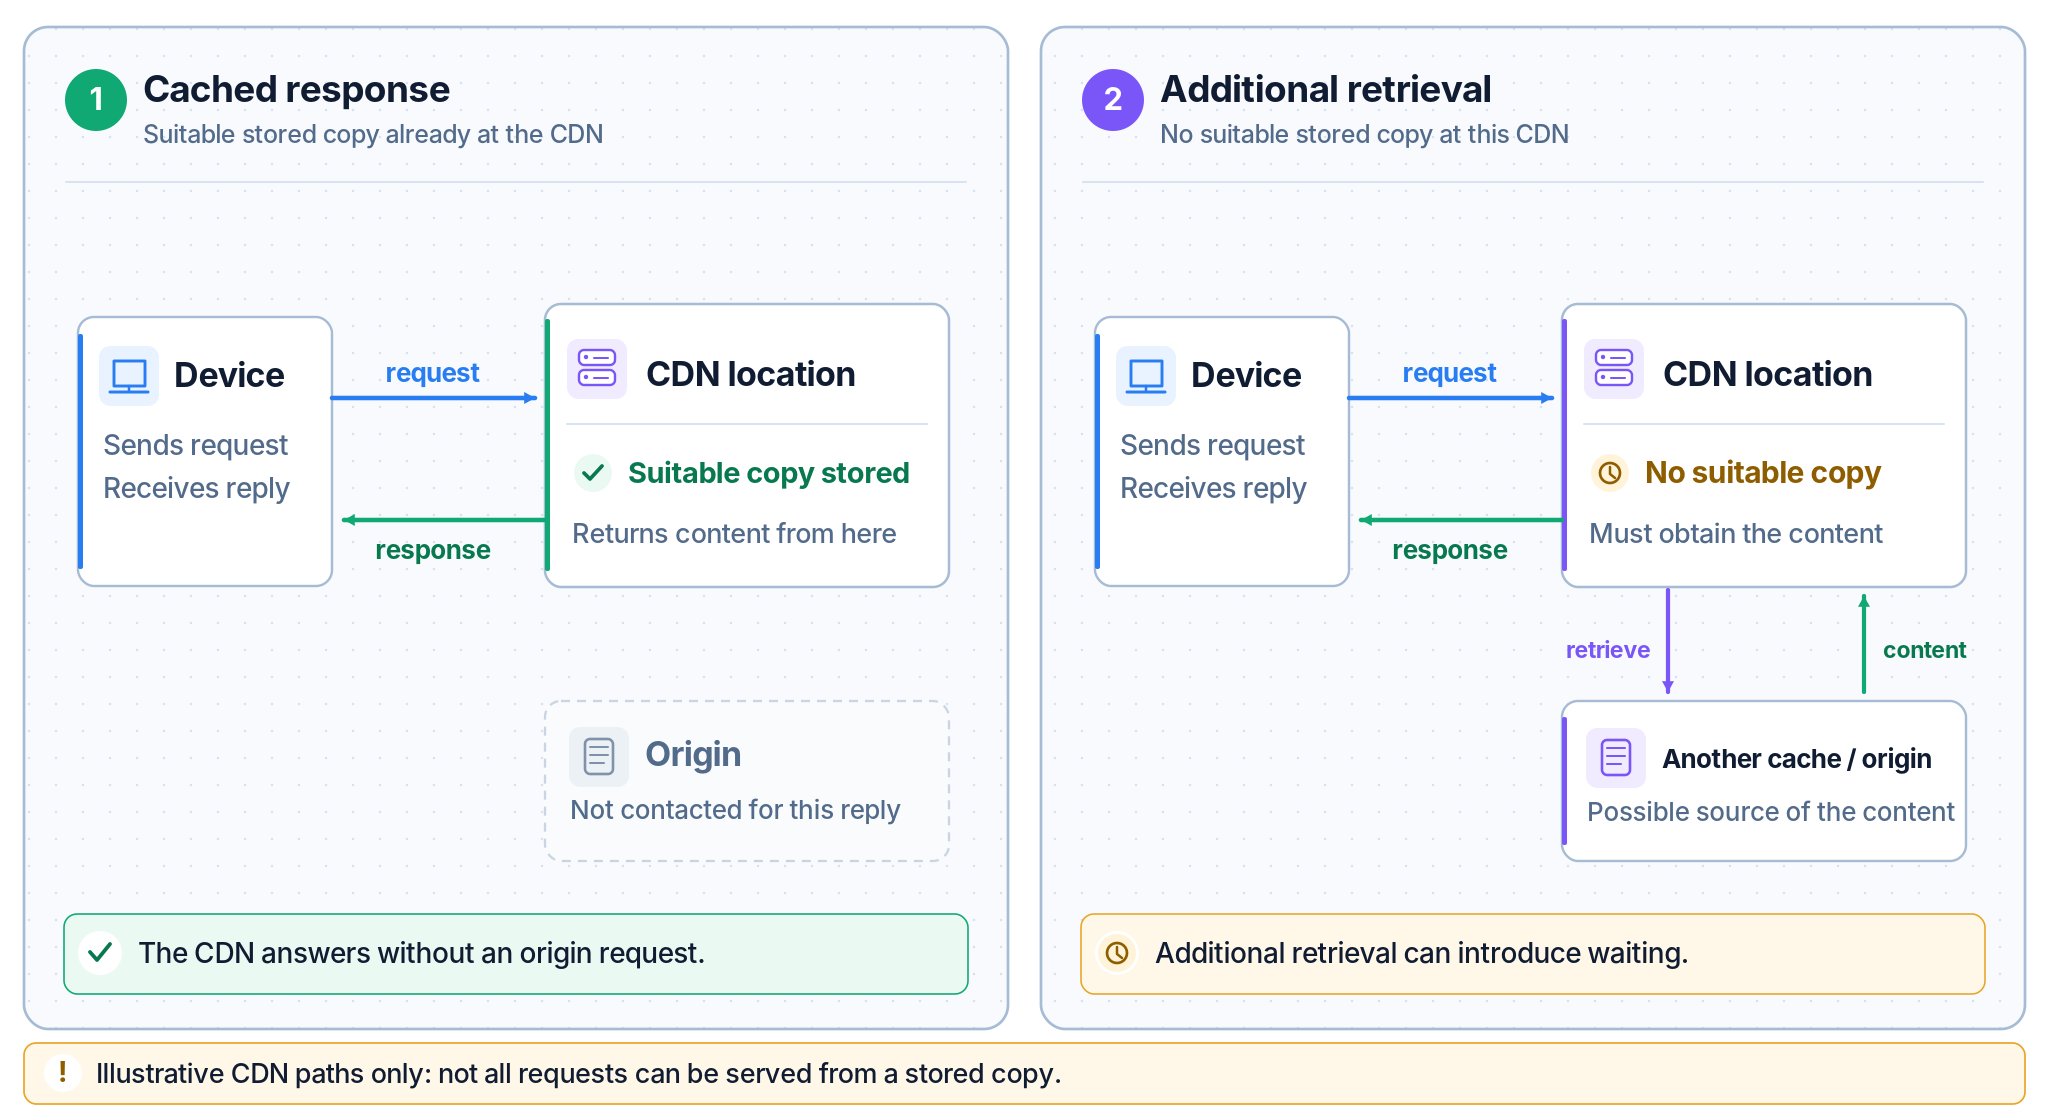
वही सेवा एक जगह तेज़ और दूसरी जगह सुस्त महसूस हो सकती है। किसी उपयोगकर्ता को अच्छी तरह जुड़े नेटवर्कों के ज़रिए सर्वर या पास के CDN केंद्र तक जल्दी पहुँच मिल सकती है। दूसरी जगह से आने वाला अनुरोध लंबे, अधिक व्यस्त या कम सीधे लिंक से होकर जा सकता है। नेटवर्क लेटेंसी उस समय को बताती है जो जानकारी को नेटवर्क में सफ़र करने में लगता है; बाहर जाता अनुरोध और लौटता जवाब, दोनों प्रतीक्षा बढ़ाते हैं। इसलिए भौगोलिक रूप से सबसे पास का सर्वर हमेशा सबसे जल्दी पहुँच में आने वाला सर्वर नहीं होता। रास्ते में आए राउटरों की संख्या सफ़र के बारे में कुछ बताती है, पर वह वास्तविक आदान-प्रदान में लगे समय का विकल्प नहीं है। उपयुक्त कैश उत्तर न होने पर नाम खोजने में अनुरोध शुरू होने से पहले अलग देरी हो सकती है।
कुल समय में अनुरोध के पहुँचने के बाद का काम भी शामिल है। जवाब देने वाला सिस्टम स्टोरेज पढ़ सकता है, कोई परिणाम बना सकता है, कैश में न मौजूद सामग्री ला सकता है या दूसरी सेवा की प्रतीक्षा कर सकता है। बहुत सारा डेटा तेज़ी से ले जाने में सक्षम कनेक्शन भी इन चरणों की देरी नहीं मिटा सकता। जवाब बहुत देर से आए या न आए, तो ऐप टाइमआउट की सूचना दे सकता है और अपने डिज़ाइन के अनुसार फिर कोशिश कर सकता है। इसलिए जानकारी कहाँ रखी और प्रोसेस की जाती है, उससे केवल गति ही नहीं बदलती; यह भी तय होता है कि अनुरोध सफल होने के लिए किन सिस्टमों का उपलब्ध रहना ज़रूरी है। कई सेवाएँ एक ही इंफ़्रास्ट्रक्चर पर निर्भर हों, तो यह बात खास तौर पर महत्वपूर्ण हो जाती है।
कई सेवाएँ एक साथ क्यों बंद हो सकती हैं
खरीदारी की वेबसाइट, बैंकिंग ऐप और वीडियो सेवा के मालिक और उद्देश्य अलग हो सकते हैं, फिर भी वे इंफ़्रास्ट्रक्चर के एक ही हिस्से पर निर्भर हो सकती हैं। Amazon Web Services, Microsoft Azure और Google Cloud जैसे प्रदाता कंप्यूटिंग और स्टोरेज देते हैं। Cloudflare, Akamai और Amazon CloudFront कंटेंट डिलीवरी और दूसरी नेटवर्क सेवाएँ उपलब्ध कराते हैं। इन श्रेणियों में कुछ काम एक जैसे भी हो सकते हैं और हर प्रदाता कई अलग-अलग घटक चलाता है। इसीलिए किसी सप्लायर का नाम सुनकर साझा तकनीकी निर्भरता या किसी विशेष खराबी का कारण साबित नहीं होता। ज़रूरी सवाल यह है कि किसी खास काम को पूरा करने के लिए प्रत्येक सेवा को वास्तव में किन घटकों की आवश्यकता है।
सिंगल पॉइंट ऑफ़ फ़ेल्योर (SPoF) ऐसा आवश्यक घटक है जिसके बिना किसी काम को पूरा करने का प्रभावी दूसरा रास्ता नहीं होता। यह ज़रूरी नहीं कि वह एक ही भौतिक मशीन हो। कोई प्लेटफ़ॉर्म हज़ारों कंप्यूटरों पर चलकर भी पहचान की जाँच, कॉन्फ़िगरेशन या संग्रहीत जानकारी तक पहुँचने के लिए एक ही तार्किक सिस्टम पर निर्भर हो सकता है। वह सिस्टम बंद हो जाए, तो बाकी स्वस्थ मशीनें भी अनुरोध पूरा नहीं कर पाएँगी। अलग-अलग भौगोलिक जगहों पर होने से तभी मदद मिलती है जब महत्वपूर्ण निर्भरताएँ भी पर्याप्त रूप से स्वतंत्र हों। कई डेटा सेंटर एक ही नियंत्रण सेवा पर निर्भर हो सकते हैं, जबकि एक प्रदाता की कई ऐप अलग घटकों का इस्तेमाल कर सकती हैं जो किसी विशेष खराबी से प्रभावित नहीं हुए। सिस्टम कितनी खराबियाँ सह सकता है, यही उसकी मज़बूती तय करता है, न कि केवल मशीनों या केंद्रों की संख्या।
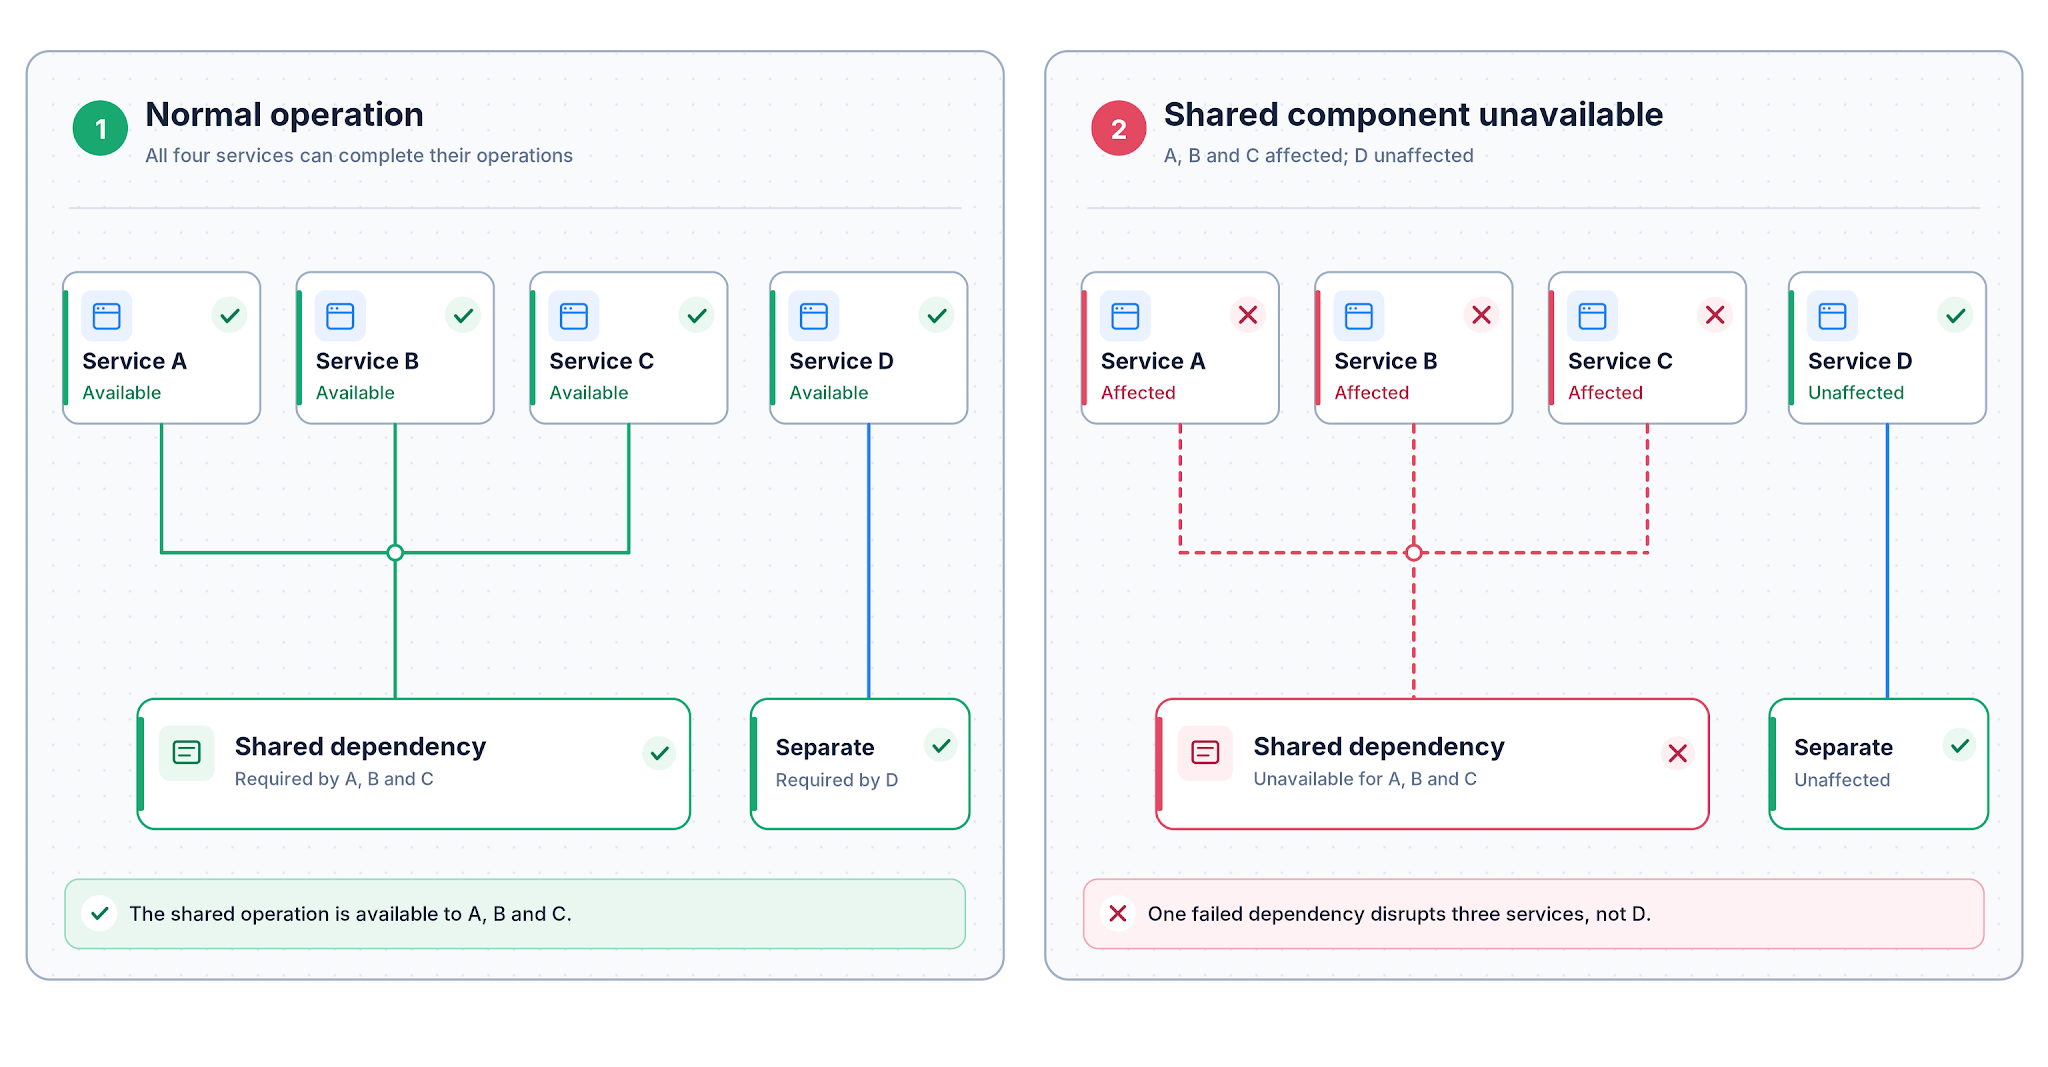
अलग स्तरों पर आई खराबियों का बाहरी असर लगभग एक जैसा दिख सकता है। पहुँच देने वाला नेटवर्क ठीक चल रही सेवाओं तक अपना रास्ता खो सकता है; नाम खोजने, होस्टिंग या कंटेंट डिलीवरी का इंफ़्रास्ट्रक्चर बंद हो सकता है; या अकेली ऐप खराब हो सकती है, जबकि उसका नेटवर्क उपलब्ध हो। इसलिए कई संगठनों पर एक साथ असर पड़ना संभावित साझा निर्भरता का संकेत है, लेकिन इससे अपने आप पता नहीं चलता कि कौन-सा घटक विफल हुआ।
20 अक्टूबर 2026 को बिजली से जुड़ी एक घटना ने लंदन क्षेत्र में Google Cloud की सेवाओं को बाधित किया। उसी दौरान Revolut, Lloyds और HSBC के ग्राहकों ने बैंकिंग सेवाओं तक पहुँच में समस्याएँ बताईं। Google की प्रारंभिक घटना रिपोर्ट के अनुसार, एक डेटा सेंटर ज़ोन के अनुपलब्ध होने से उसी क्षेत्र की दूसरी सेवाएँ भी प्रभावित हुईं। काम बची हुई व्यवस्था पर स्थानांतरित किया गया, लेकिन कुछ क्षेत्रीय सिस्टम अब भी बंद पड़े ज़ोन के घटकों पर निर्भर थे। Reuters ने Revolut की सेवा बाधा का Google Cloud की घटना से संबंध बताया; हर वित्तीय संस्था को प्रभावित करने वाला ठीक-ठीक तकनीकी विफलता मार्ग सार्वजनिक रूप से स्थापित नहीं हुआ था।
ऐसी घटनाएँ दिखाती हैं कि अधिक मशीनें या वैकल्पिक नेटवर्क रास्ते जोड़ देना अपने आप में पर्याप्त नहीं है। दूसरा नेटवर्क मार्ग खराब ऐप को ठीक नहीं कर सकता और अगर सभी सर्वर एक ही नियंत्रण प्रणाली पर निर्भर हैं, तो अतिरिक्त सर्वर बेकार हो सकते हैं। बैकअप तभी उपयोगी है जब वह उसी निर्भरता के बंद होने के बाद भी काम करे जिसके लिए उसे बनाया गया है। विश्वसनीयता का मूल्यांकन करते समय यह देखना चाहिए कि कौन-सा घटक अनुपलब्ध होने पर भी सेवा का अपेक्षित काम जारी रह सकता है।
समाचार ऐप लेख कैसे प्राप्त करती हैं
समाचार ऐप यह दिखाने का ठोस उदाहरण है कि सॉफ़्टवेयर की बनावट खराबी का दायरा कैसे बदलती है। ऐसी ऐप कई प्रकाशकों से सीधे सामग्री मँगवा सकती है और आवश्यकता पड़ने पर प्रत्येक स्रोत से अलग संपर्क कर सकती है। एक प्रकाशक अनुपलब्ध हो जाए, तो दूसरे स्रोतों से अनुरोध सफल हो सकते हैं, बशर्ते उनके डेटा लाने वाले रास्ते काम करते रहें। इसका मतलब यह नहीं कि प्रकाशक पूरी तरह स्वतंत्र हैं; वे नाम खोजने, होस्टिंग या डिलीवरी के साझा सिस्टम इस्तेमाल कर सकते हैं। लेकिन ऐप ने एक अतिरिक्त केंद्रीय दूरस्थ सेवा अनिवार्य नहीं बनाई है, जिसके चलते हर प्रकाशक की नई सामग्री पाने के लिए उस सेवा का उपलब्ध रहना ज़रूरी हो।
दूसरी तरह की समाचार ऐप उन्हीं प्रकाशकों की सामग्री एक केंद्रीय प्लेटफ़ॉर्म से ले सकती है, जो पहले सामग्री इकट्ठा करता है और फिर ऐप तक पहुँचाता है। प्लेटफ़ॉर्म के सर्वर और स्थान अनेक हो सकते हैं, लेकिन यदि ऐप के पास नई सामग्री सीधे पाने का दूसरा रास्ता नहीं है, तो केंद्रीय सेवा उसमें दिखने वाले हर स्रोत के लिए आवश्यक निर्भरता बन जाती है। उसके ठप होने पर नई सामग्री आना रुक सकता है, भले प्रकाशक सामान्य रूप से काम कर रहे हों। पाठकों को दोनों तरह की ऐप का इंटरफ़ेस लगभग एक जैसा दिख सकता है; अंतर उन सिस्टमों में है जिनके चलते अगला अनुरोध सफल हो पाएगा।
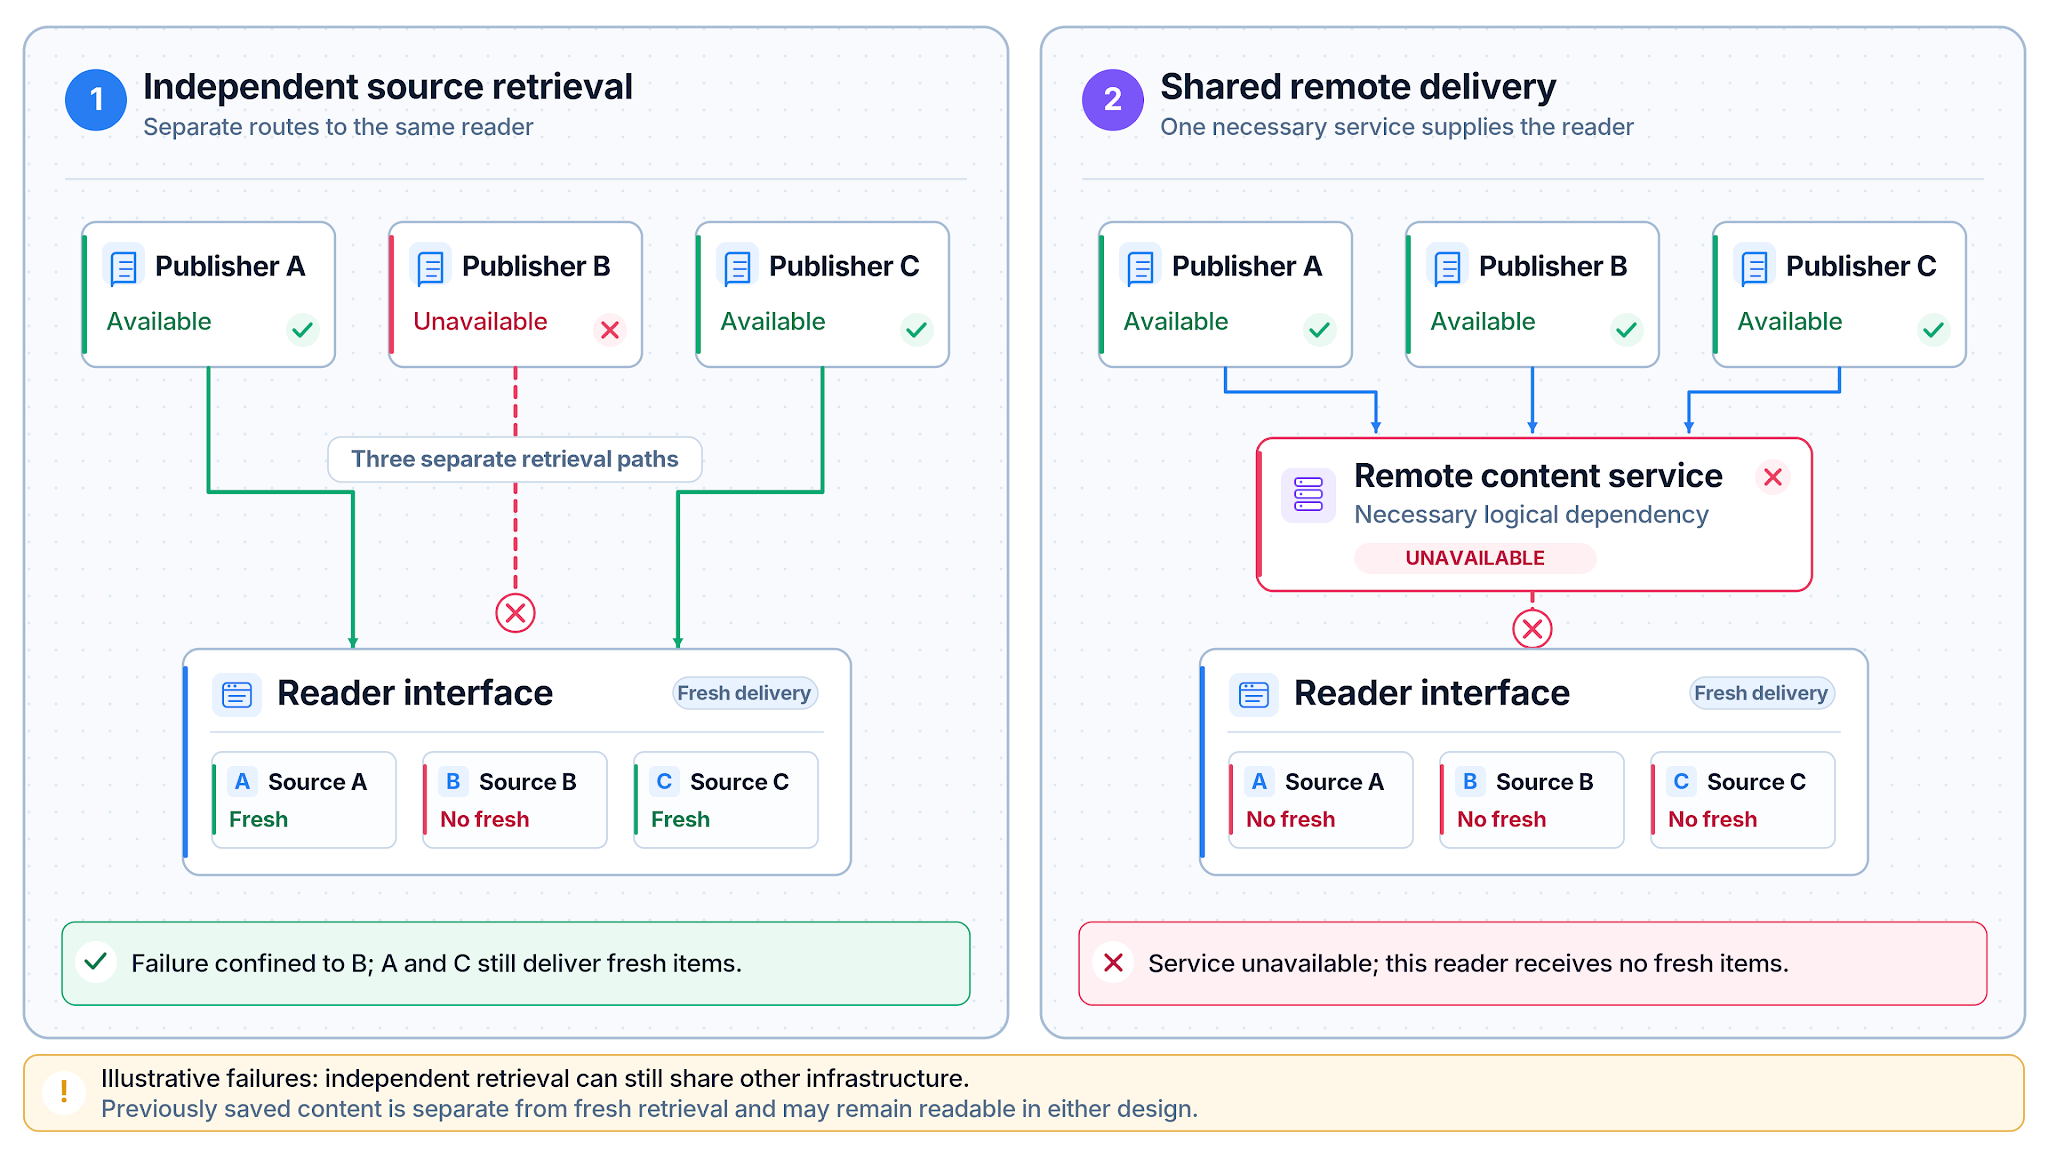
उपकरण पर पहले से सेव सामग्री दोनों तरह की रुकावटों में पढ़ने योग्य रह सकती है, लेकिन इससे नई सामग्री पाने की क्षमता सिद्ध नहीं होती। डिलीवरी की बनावट यह भी तय करती है कि जानकारी किन पक्षों के पास जाती है। एन्क्रिप्शन आम तौर पर नेटवर्क से गुज़रते समय संचार की सुरक्षा करता है और रास्ते के असंबंधित ऑपरेटरों की सामग्री पढ़ने की क्षमता सीमित करता है। फिर भी कोई केंद्रीय डिलीवरी प्लेटफ़ॉर्म, जो कनेक्शन को समाप्त करता है या उसमें आए डेटा को प्रोसेस करता है, अपने द्वारा पहुँचाई गई सामग्री देख सकता है। डेटा भेजते समय एन्क्रिप्शन होना यह नहीं बताता कि उस प्लेटफ़ॉर्म पर भरोसा किया जा सकता है या उसकी जानकारी सही है। उपलब्धता और डेटा प्रबंधन, दोनों के लिए यह अंतर मायने रखता है, भले ऐप के इंटरफ़ेस से यह दिखाई न दे।
निचोड़
इंटरनेट से काम की जानकारी प्राप्त करने के लिए उपकरण का कनेक्शन चालू होना ही काफ़ी नहीं है। हर उपयोगी जवाब के पीछे अलग-अलग संगठनों के नेटवर्कों से होकर जाने वाला रास्ता और उत्तर तैयार करने में सक्षम सिस्टमों की शृंखला होती है। देरी इन दोनों हिस्सों में हो सकती है और खराबियों का असर उतना फैलता है जितनी दूर आवश्यक निर्भरताएँ साझा होती हैं। बनावट का सबसे महत्वपूर्ण हिस्सा अक्सर दिखाई नहीं देता: कई संगठन एक अहम घटक पर निर्भर हो सकते हैं, जबकि कोई एक ऐप अलग-अलग स्रोतों को एक ही केंद्रीय निर्भरता में बदल सकती है। जवाब वास्तव में कहाँ से आता है और उसे पहुँचने से क्या रोक सकता है, यह समझने पर असंबंधित लगने वाली रुकावटें स्पष्ट होती हैं और तकनीकी डिज़ाइन का मूल्यांकन बेहतर ढंग से किया जा सकता है।
जानने लायक ज़रूरी शब्द
| क्रमांक | शब्द | अर्थ |
|---|---|---|
| 1 | इंटरनेट प्रोटोकॉल (IP) | पतों की वह व्यवस्था जो जानकारी को कई नेटवर्कों से होते हुए उसके गंतव्य की ओर पहुँचाने में मदद करती है। |
| 2 | इंटरनेट सेवा प्रदाता (ISP) | वह कंपनी जो स्थानीय नेटवर्क से आगे बड़े इंटरनेट तक पहुँच देती है। |
| 3 | कंटेंट डिलीवरी नेटवर्क (CDN) | उपयुक्त सामग्री की प्रतियाँ अलग-अलग स्थानों से दे सकता है, ताकि हर अनुरोध के लिए मूल स्रोत से संपर्क न करना पड़े। |
| 4 | डोमेन नेम सिस्टम (DNS) | example.com जैसे नाम के लिए पता खोजने में मदद करता है, लेकिन रास्ता नहीं चुनता। |
| 5 | सिंगल पॉइंट ऑफ़ फ़ेल्योर (SPoF) | किसी काम के लिए ज़रूरी ऐसा घटक जिसका प्रभावी विकल्प न हो। उसके बंद होने पर वह काम रुक जाता है। |
संदर्भ
- Google Cloud Service Health (22 अक्टूबर 2026)। 20 अक्टूबर को europe-west2 क्षेत्र में हुई बाधा की प्रारंभिक घटना रिपोर्ट। ↗
- Reuters (21 अक्टूबर 2026)। «Europe's financial regulators query Google over cloud outage that hit banks»। ↗
- Synergy Research Group (30 जुलाई 2026)। «Q2 Cloud Market Passes $143 Billion; Highest Growth Rate in Eight Years»। 2026 की दूसरी तिमाही में वैश्विक क्लाउड इंफ़्रास्ट्रक्चर सेवाओं के राजस्व का हिस्सा: Amazon 28%, Microsoft 20%, Google 15%। ↗
- W3Techs (22 अक्टूबर 2026 को देखा गया)। «Usage statistics and market shares of reverse proxy services for websites»। इसमें Cloudflare, Amazon CloudFront, Fastly और Akamai जैसी सेवाओं के वेबसाइटों पर देखे गए इस्तेमाल को मापा जाता है, न कि CDN के राजस्व या ट्रैफ़िक का हिस्सा। ↗