
Los anteriores artículos de la serie Fundamentos, «Cómo funcionan los ordenadores: el empleado de archivo ultrarrápido de Feynman» y «Cómo convierten los ordenadores los ceros y unos en palabras e imágenes», explicaron cómo sigue instrucciones un ordenador y cómo representa información mediante valores almacenados. Llevar esa información a otro ordenador plantea un problema diferente: las máquinas no comparten memoria y ni siquiera tienen por qué estar conectadas directamente. El empleado de archivo del modelo de Feynman puede abrir un cajón numerado para encontrar algo guardado cerca. Sin embargo, para obtener información almacenada en un ordenador lejano tiene que enviar una solicitud y esperar la respuesta, más parecido a escribir a otra oficina que a abrir un segundo cajón. El procesamiento puede estar listo para continuar mucho antes de que llegue la contestación.
Internet hace posibles estos intercambios conectando redes gestionadas por distintas organizaciones. La información puede salir de la primera red a la que se conecta un dispositivo, atravesar varias redes más, llegar a un servicio capaz de responder y regresar por otra sucesión de conexiones. Comprender tanto el recorrido como los sistemas que proporcionan la respuesta permite explicar por qué el acceso varía de un lugar a otro, por qué algunas solicitudes tardan y por qué servicios que parecen independientes pueden dejar de funcionar al mismo tiempo.
Del dispositivo a la red más amplia
Un teléfono, un portátil u otro dispositivo empieza con una conexión local, normalmente por Wi-Fi, una red móvil o un cable. Desde ahí, los equipos cercanos de red reenvían el tráfico hacia una red más amplia. En conexiones domésticas y de oficina, un proveedor de servicios de Internet (ISP) suele ofrecer el acceso al resto de Internet; en el móvil, la red del operador cumple una función similar. Cada proveedor puede intercambiar tráfico con otras redes, de modo que las comunicaciones atraviesan organizaciones y grandes distancias sin necesitar una conexión física exclusiva entre los dos dispositivos finales.
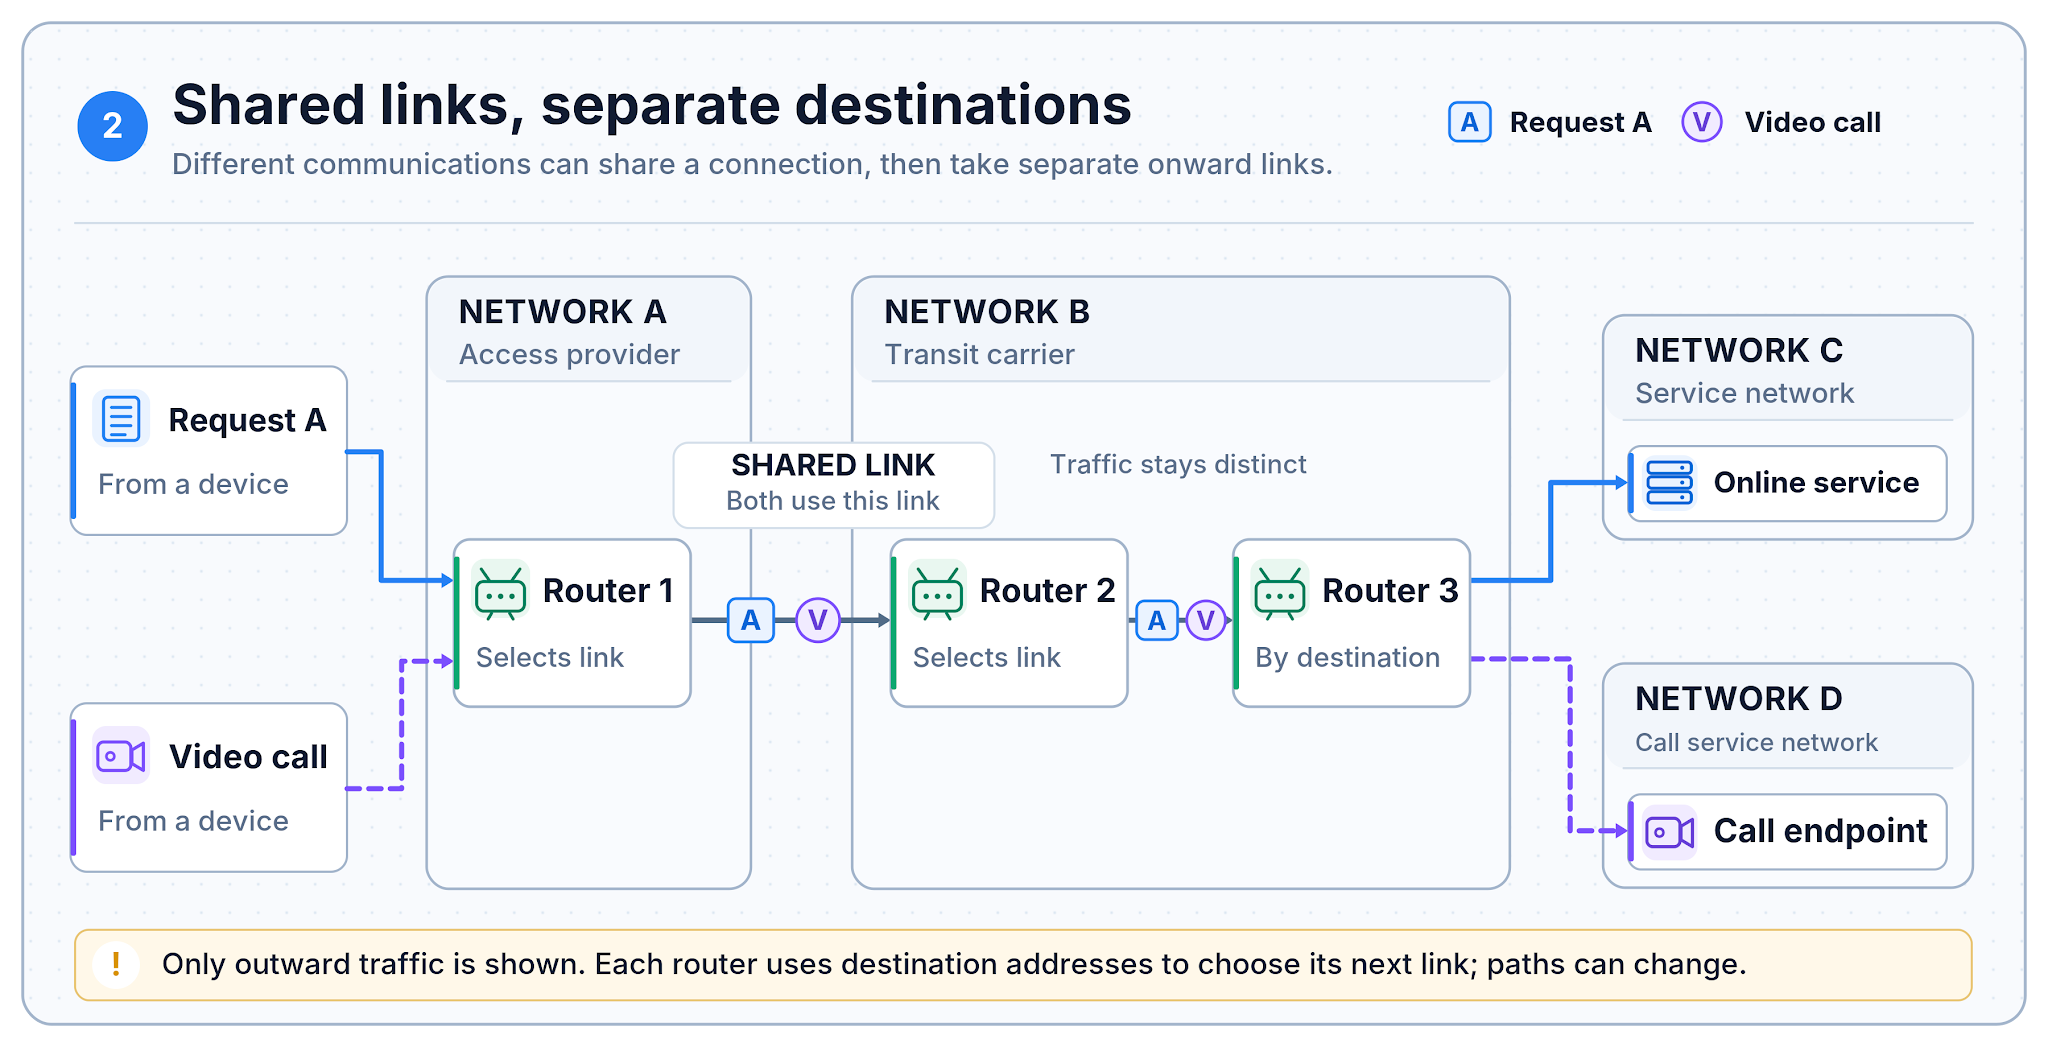
Internet funciona a esta escala porque muchas comunicaciones pueden utilizar los mismos enlaces y equipos. Una videollamada, un mensaje, la descarga de un archivo y una solicitud a un servicio pueden compartir parte de la red y consumir parte de su capacidad disponible. El protocolo de Internet (IP) proporciona direcciones de destino y los encaminadores, también llamados routers, las usan para decidir por dónde enviar el tráfico a continuación. Un servicio puede tener varias direcciones y varias máquinas pueden aparecer detrás de una sola. La dirección hace posible la entrega, pero no identifica un recorrido físico o una máquina concretos.
Cómo se convierte el nombre de un servicio en una dirección
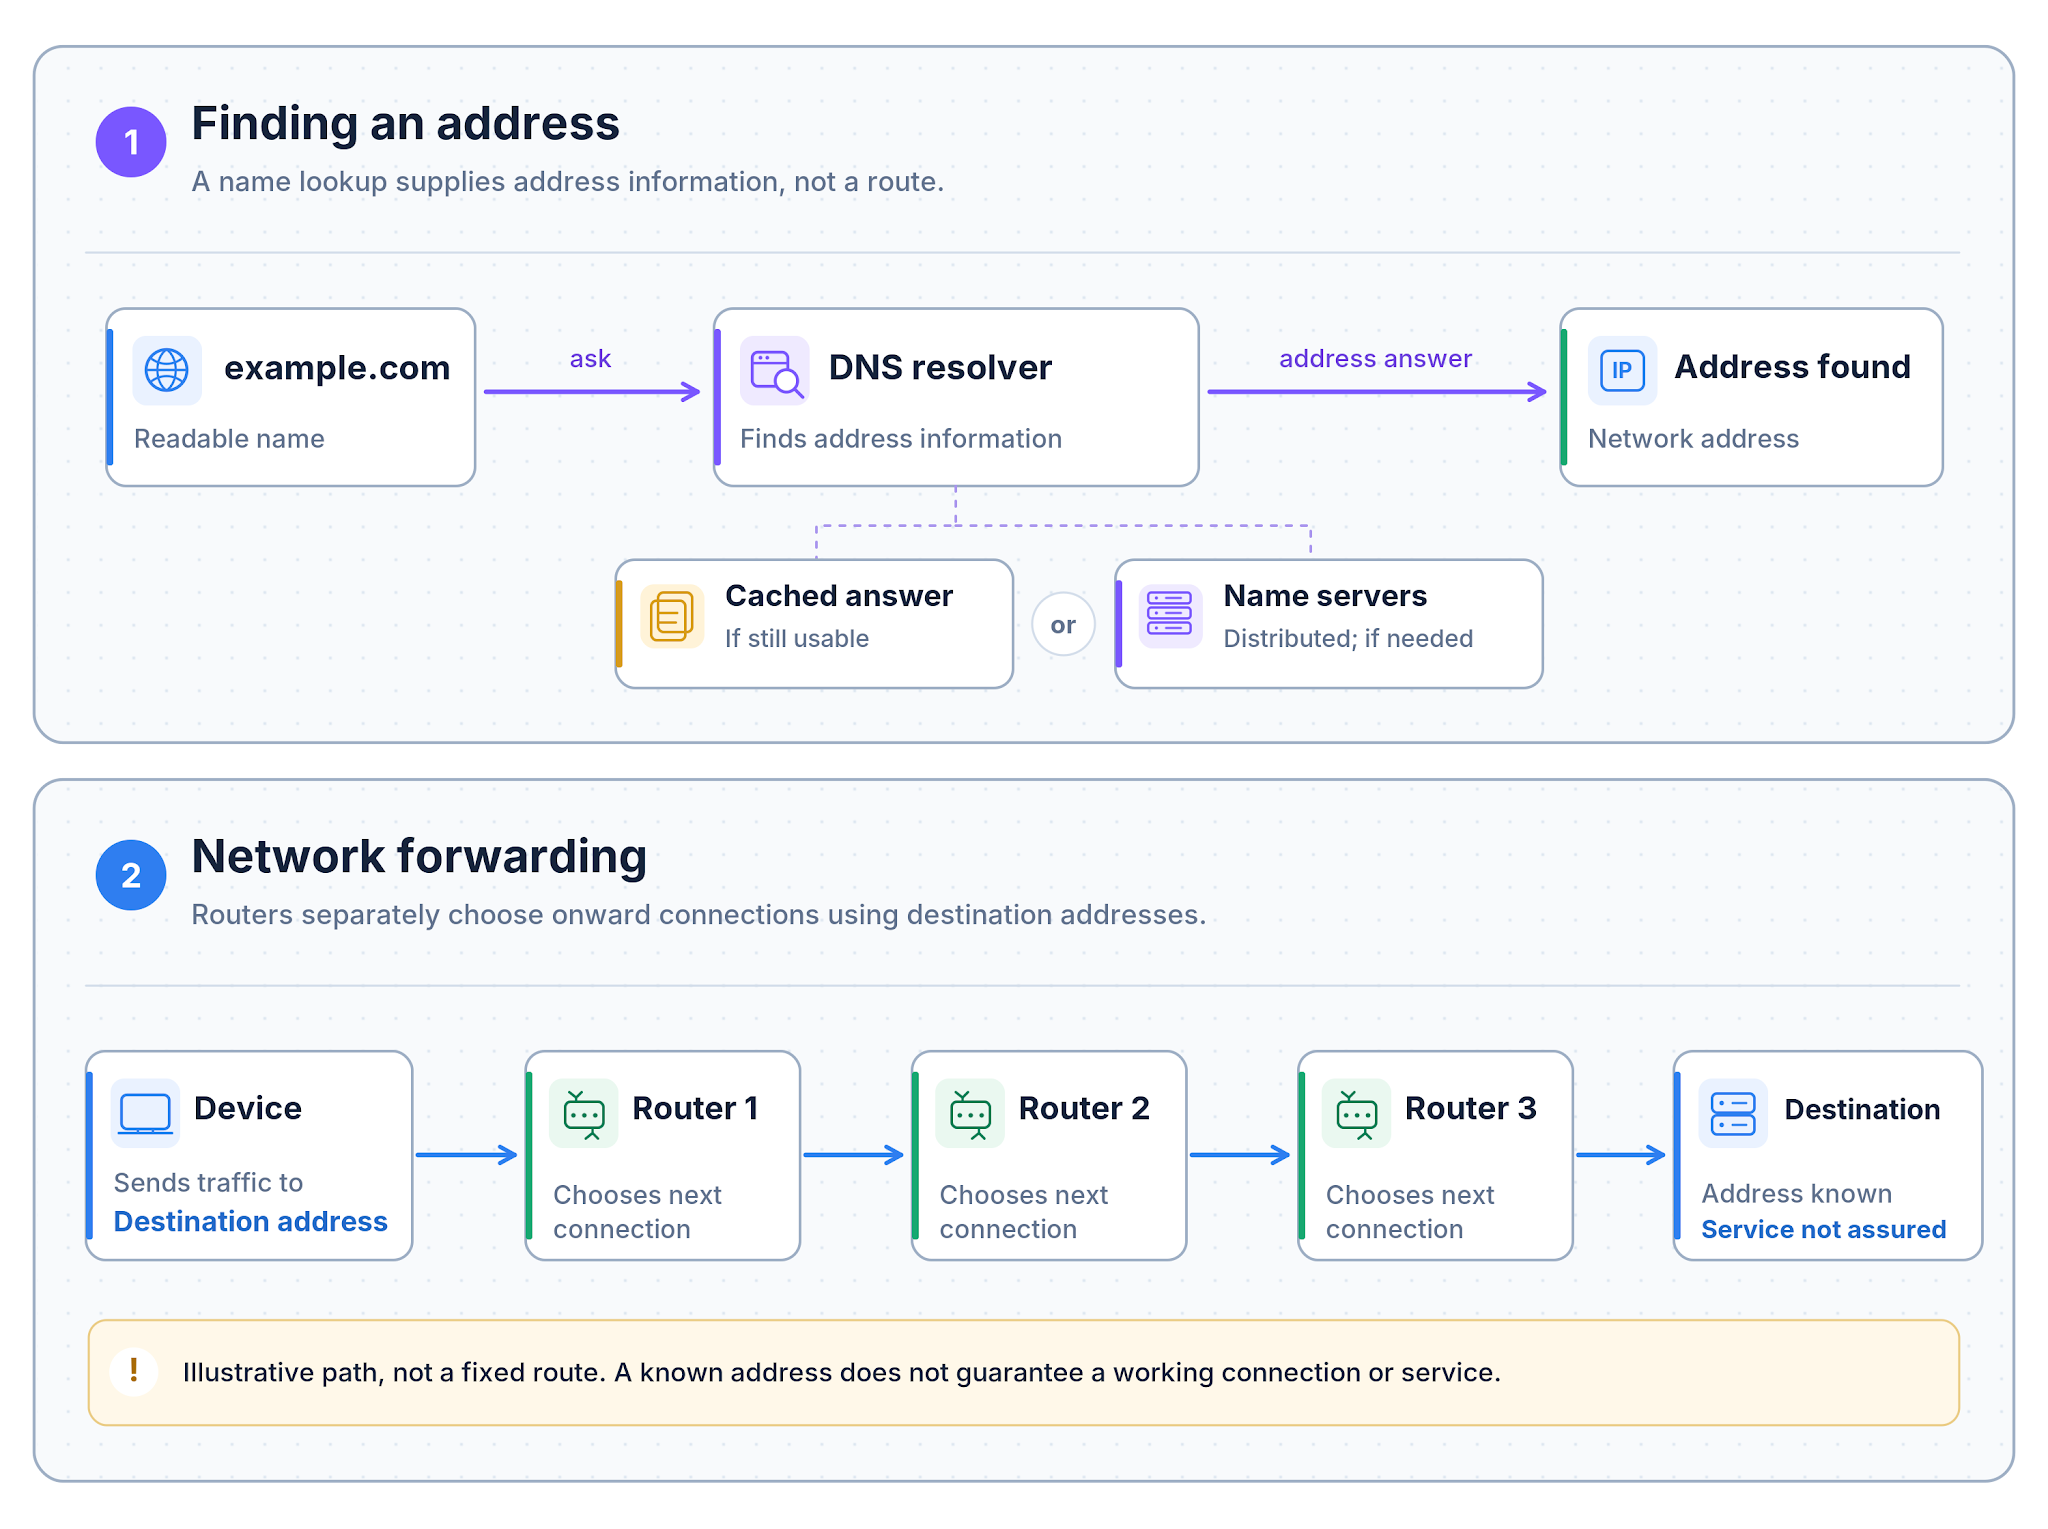
Antes de contactar con un servicio llamado, por ejemplo, example.com, una aplicación suele necesitar una dirección de red. El sistema de nombres de dominio (DNS) ayuda a encontrarla, igual que consultar la dirección de una oficina permite enviarle una carta. La dirección puede estar ya guardada en el dispositivo; si no, este puede preguntar a un resolvedor DNS. El resolvedor puede devolver una respuesta de su caché o consultar otros servidores de nombres. La información sobre los nombres está distribuida entre numerosos sistemas, no almacenada en un único directorio mundial. Un servicio puede tener varias direcciones válidas, que además cambian con el tiempo.
Cuando la respuesta necesaria no está en la caché, encontrarla puede requerir más intercambios por la red y añadir una espera antes de que la aplicación envíe su solicitud. Si falla la búsqueda del nombre, el acceso mediante ese nombre puede quedar impedido aunque los sistemas de destino funcionen. Encontrar una dirección tampoco determina el camino hasta ella. Una vez que la aplicación conoce la dirección, envía tráfico hacia el destino y los encaminadores del recorrido consultan su propia información de enrutamiento para elegir los enlaces siguientes. Resolver el nombre no establece ni la ruta ni la capacidad del servicio para responder.
Cómo reenvían la información las redes
Cuando se conoce la dirección de destino, el tráfico empieza su recorrido por la puerta de enlace local del dispositivo, normalmente un encaminador. La puerta de enlace lo reenvía a otro encaminador, que elige la siguiente conexión a partir de la dirección y de su propia información de enrutamiento. La secuencia puede cruzar redes gestionadas por varias organizaciones: un proveedor local entrega el tráfico a otro operador, que lo transporta hacia la red que atiende el destino. Cada encaminador toma una decisión local de reenvío. No existe una sala de control central que asigne el recorrido completo de cada solicitud. Distintas comunicaciones pueden compartir algunos enlaces aunque procedan de orígenes diferentes y terminen en lugares distintos.
Cada paso de reenvío de un encaminador a otro suele llamarse salto (hop). Un número mayor de saltos no implica por sí solo más retraso: también importan la distancia recorrida, las conexiones disponibles, la congestión y la ubicación del sistema que responde. Las redes intercambian información sobre los destinos a los que se puede llegar a través de sus vecinas. Si falla un enlace o una red, esa información puede cambiar y los encaminadores pueden adoptar otras rutas cuando existen alternativas utilizables y lo permiten las políticas de sus operadores. Actualizar las rutas puede llevar tiempo y algunos destinos no tienen una alternativa disponible. Incluso si la solicitud llega, la respuesta puede regresar por una sucesión diferente de encaminadores.
De dónde vienen las respuestas y por qué tardan
Cuando una solicitud llega a la infraestructura que atiende su destino, todavía hace falta que algún sistema prepare la respuesta. Puede recuperar información almacenada, realizar un cálculo, comprobar permisos o actualizar un registro. La organización que presta el servicio puede operar sus propias máquinas o depender de un proveedor de alojamiento. Por eso, una ruta de red que funciona no garantiza una respuesta rápida. Después de recibir la solicitud, el software, el almacenamiento y otros sistemas pueden funcionar despacio, sobrecargarse, estar mal configurados o dejar de estar disponibles. Incluso tratándose de material público, pedir repetidamente al mismo ordenador lejano una imagen o un archivo que no ha cambiado puede desperdiciar tiempo y capacidad de la red.
Se pueden guardar copias de contenidos adecuados en distintos lugares. Una red de distribución de contenidos (CDN) puede responder a ciertas solicitudes con una copia de caché sin contactar con la fuente original, habitualmente llamada origen. Si no dispone de una copia adecuada, el sistema de distribución puede tener que recuperar el contenido de otra caché o del origen antes de responder. Otras operaciones, como iniciar sesión, cambiar datos almacenados o solicitar información actualizada, pueden requerir un procesamiento nuevo. Los sistemas que almacenan, procesan y distribuyen la información pueden pertenecer a organizaciones distintas y presentarse como un único servicio. La respuesta viaja después por la red hasta el dispositivo solicitante, que la interpreta.
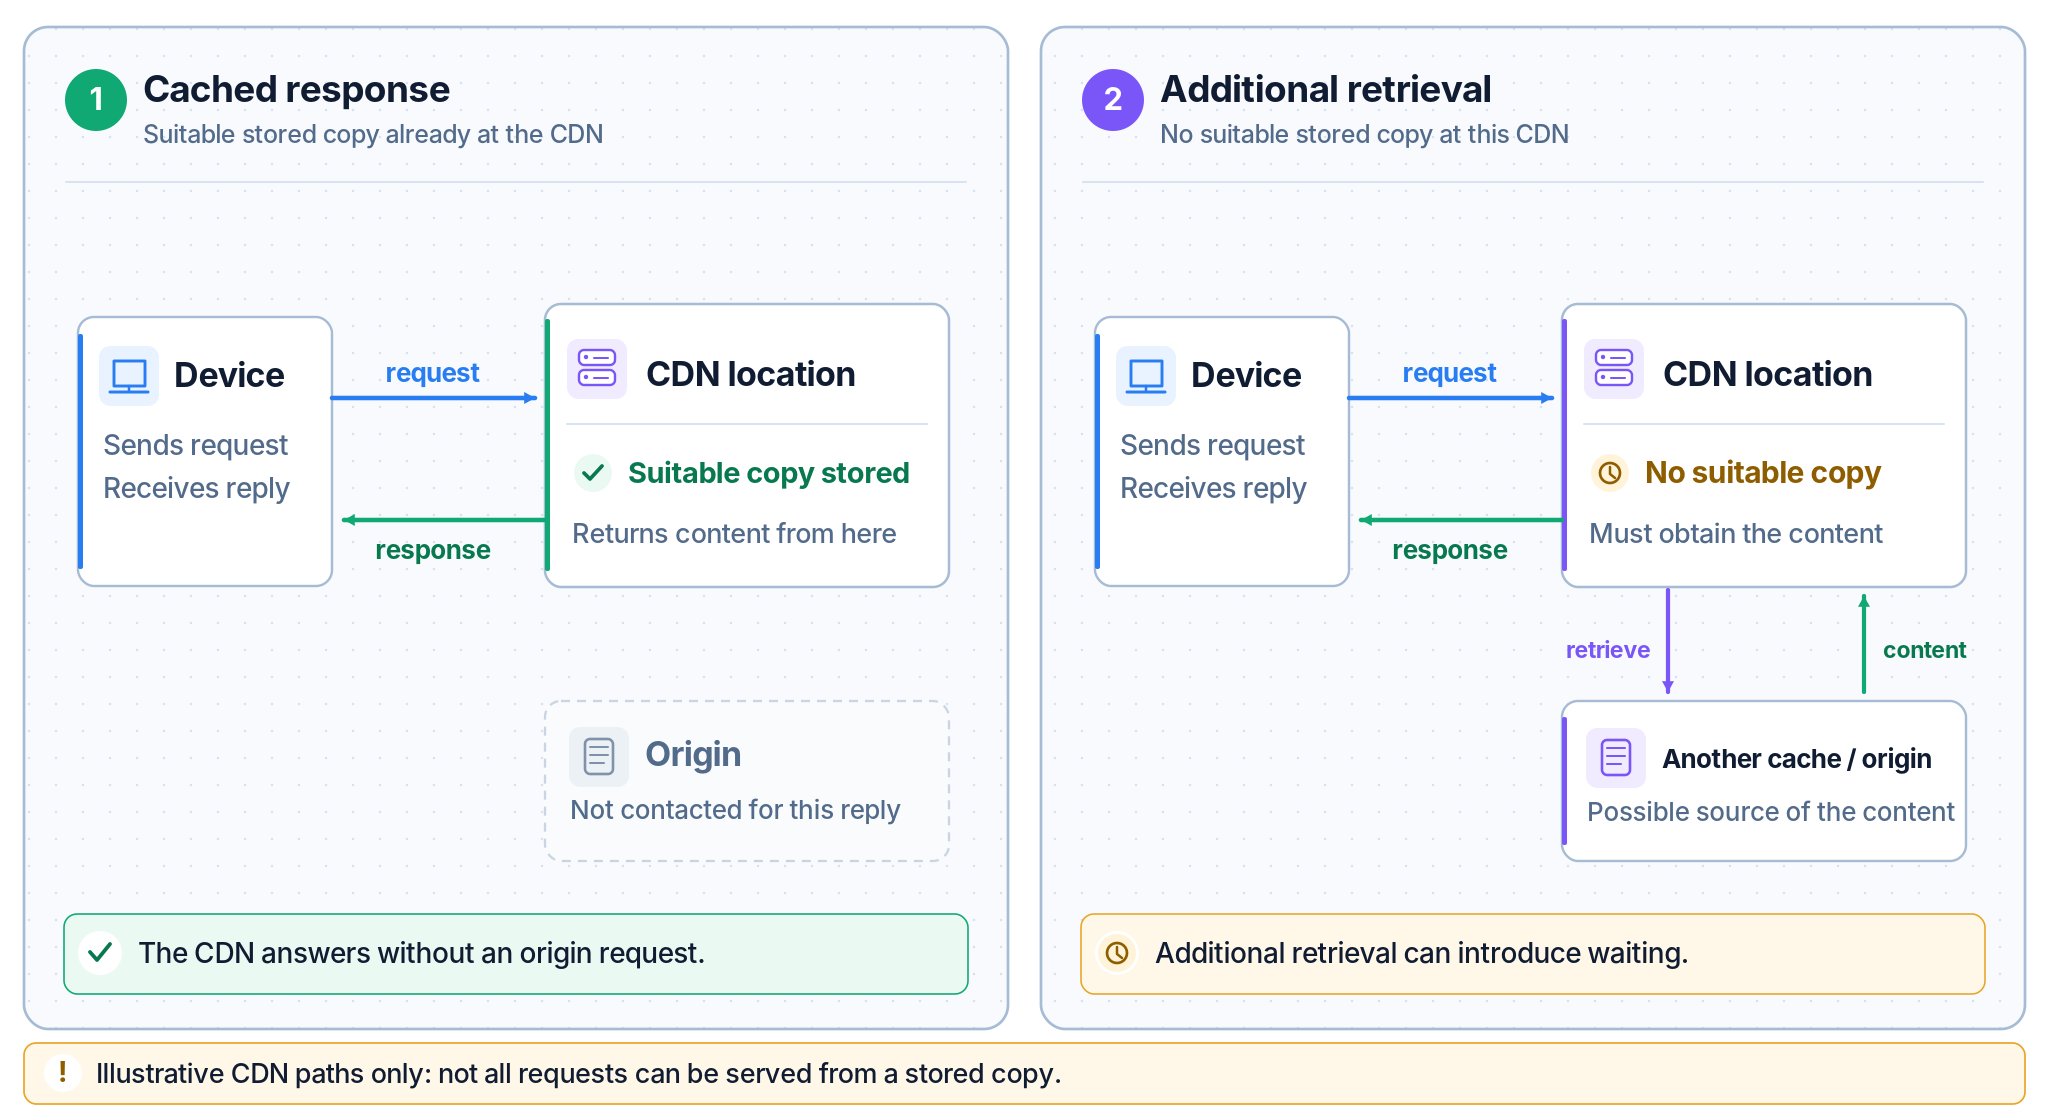
El mismo servicio puede parecer rápido desde un lugar y lento desde otro. Una persona puede llegar a un servidor o a un punto cercano de una CDN a través de redes bien conectadas, mientras que la solicitud de otra atraviesa enlaces más largos, más congestionados o menos directos. La latencia de red describe el tiempo que se emplea en el recorrido por la red; tanto el viaje de ida de la solicitud como el regreso de la respuesta contribuyen a la espera. Por eso, el servidor geográficamente más próximo no es necesariamente el más rápido de alcanzar. El número de encaminadores recorridos aporta cierta información sobre el trayecto, pero no sustituye la medición del tiempo que tardan realmente los intercambios. La resolución de nombres puede añadir su propia espera antes de la solicitud si no hay una respuesta adecuada en caché.
El tiempo total también incluye el trabajo realizado después de recibir la solicitud. El sistema que responde quizá deba leer del almacenamiento, generar un resultado, recuperar un elemento que no está en caché o esperar a otro servicio. Una conexión capaz de transferir grandes cantidades de información con rapidez no elimina esos retrasos. Si la respuesta tarda demasiado o no llega, la aplicación puede indicar que se ha agotado el tiempo de espera y, según su diseño, volver a intentarlo. Por tanto, dónde se guardan y procesan los datos afecta a algo más que a la velocidad: determina qué sistemas deben estar disponibles para que una solicitud tenga éxito. Esa dependencia es especialmente importante cuando varios servicios comparten infraestructura.
Por qué pueden fallar varios servicios a la vez
Una tienda en línea, una aplicación bancaria y un servicio de vídeo pueden tener propietarios y finalidades distintos, pero depender de una misma pieza de infraestructura. Proveedores como Amazon Web Services, Microsoft Azure y Google Cloud ofrecen capacidad de procesamiento y almacenamiento; Cloudflare, Akamai y Amazon CloudFront proporcionan distintas formas de distribución de contenidos y otros servicios de red. Las categorías pueden solaparse y cada proveedor opera numerosos componentes diferentes. Por tanto, mencionar un proveedor no demuestra que exista una dependencia técnica común ni cuál fue la causa de una avería concreta. La cuestión decisiva es qué componentes necesita realmente cada servicio para completar una operación determinada.
Un punto único de fallo (single point of failure, SPoF) es un componente necesario para una operación que no tiene una alternativa eficaz. No tiene por qué ser una sola máquina física. Una plataforma puede funcionar sobre miles de ordenadores y seguir dependiendo de un único sistema lógico para comprobar identidades, gestionar la configuración o acceder a información almacenada. Si ese sistema falla, las máquinas que siguen funcionando correctamente pueden ser incapaces de completar una solicitud. La separación geográfica solo ayuda cuando las dependencias importantes son lo bastante independientes. Varios centros de datos pueden utilizar un mismo servicio de control; del mismo modo, varias aplicaciones pueden compartir proveedor, pero utilizar componentes distintos que no se han visto afectados. La resiliencia depende de los fallos que un diseño puede soportar, no simplemente del número de máquinas o ubicaciones que tenga.
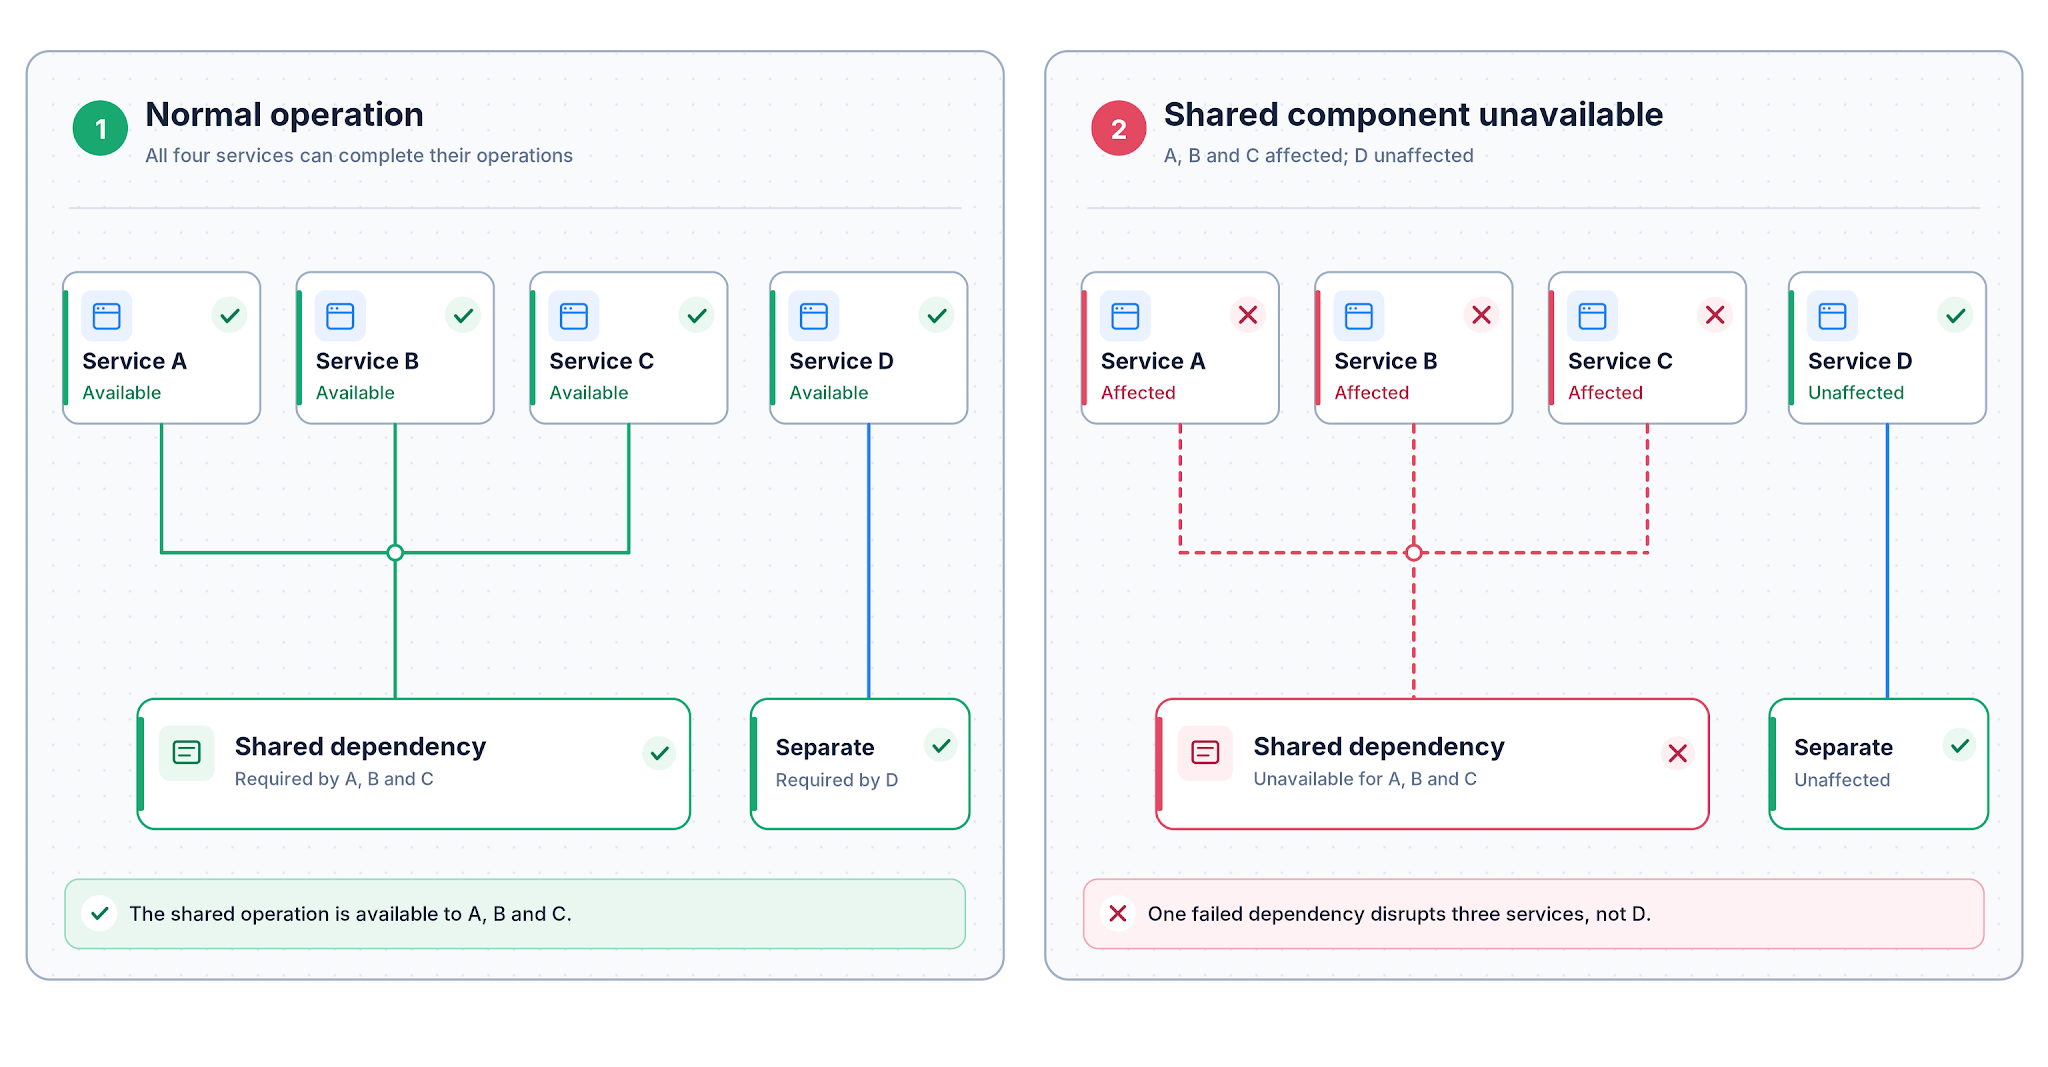
Averías en distintos niveles pueden producir consecuencias visibles casi idénticas. Una red de acceso puede perder la ruta hacia servicios que siguen sanos; pueden dejar de funcionar los sistemas de nombres, el alojamiento o la distribución; o puede fallar una aplicación concreta mientras su red continúa operativa. Una interrupción que afecta a varias organizaciones sugiere posibles dependencias compartidas, pero no identifica por sí misma qué componente ha fallado.
El 20 de octubre de 2026, un incidente eléctrico interrumpió servicios de Google Cloud en su región de Londres mientras clientes de Revolut, Lloyds y HSBC notificaban problemas para acceder a servicios bancarios. El informe preliminar de Google explicó que la pérdida de una zona de un centro de datos también afectó a servicios en otras partes de la región: el trabajo se desplazó hacia la infraestructura restante, pero ciertos sistemas regionales aún dependían de componentes situados en la zona no disponible. Reuters informó de una relación entre la interrupción de Revolut y el incidente de Google Cloud; las rutas técnicas concretas de fallo que afectaron a cada entidad no quedaron establecidas públicamente.
Un incidente de este tipo también muestra por qué no basta con añadir máquinas o rutas alternativas. Otra ruta de red no puede reparar una aplicación averiada, y más servidores pueden no servir de nada si todos dependen del mismo sistema de control. Una alternativa solo tiene valor si sigue siendo utilizable cuando falla precisamente la dependencia que debe cubrir. Al evaluar la fiabilidad, lo útil es determinar qué componente puede dejar de estar disponible sin detener la operación que se espera del servicio.
Cómo obtienen artículos las aplicaciones de noticias
Una aplicación de noticias ofrece un ejemplo concreto de cómo la arquitectura del software modifica el alcance de una avería. Puede recuperar contenido directamente de varios editores y contactar con cada fuente según sea necesario. Si un editor deja de estar disponible, las solicitudes a los demás pueden seguir funcionando siempre que sus rutas de recuperación permanezcan operativas. Esto no significa que los editores sean completamente independientes, pues pueden compartir sistemas de nombres, alojamiento o distribución. Sí significa que la aplicación no ha añadido un servicio remoto adicional cuya disponibilidad sea imprescindible para obtener material nuevo de todos los editores.
Otra aplicación de noticias puede recibir el contenido de esos mismos editores desde una plataforma central que lo reúne y después lo sirve a la aplicación. Esa plataforma puede utilizar numerosos servidores y ubicaciones, pero si la aplicación no tiene una vía alternativa para recuperar material reciente, el servicio central pasa a ser una dependencia necesaria para todas las fuentes que muestra. Si falla, pueden dejar de llegar novedades aunque los editores sigan operativos. Los lectores podrían ver interfaces casi idénticas en ambos diseños; la diferencia reside en qué sistemas deben funcionar para que tenga éxito la próxima solicitud.
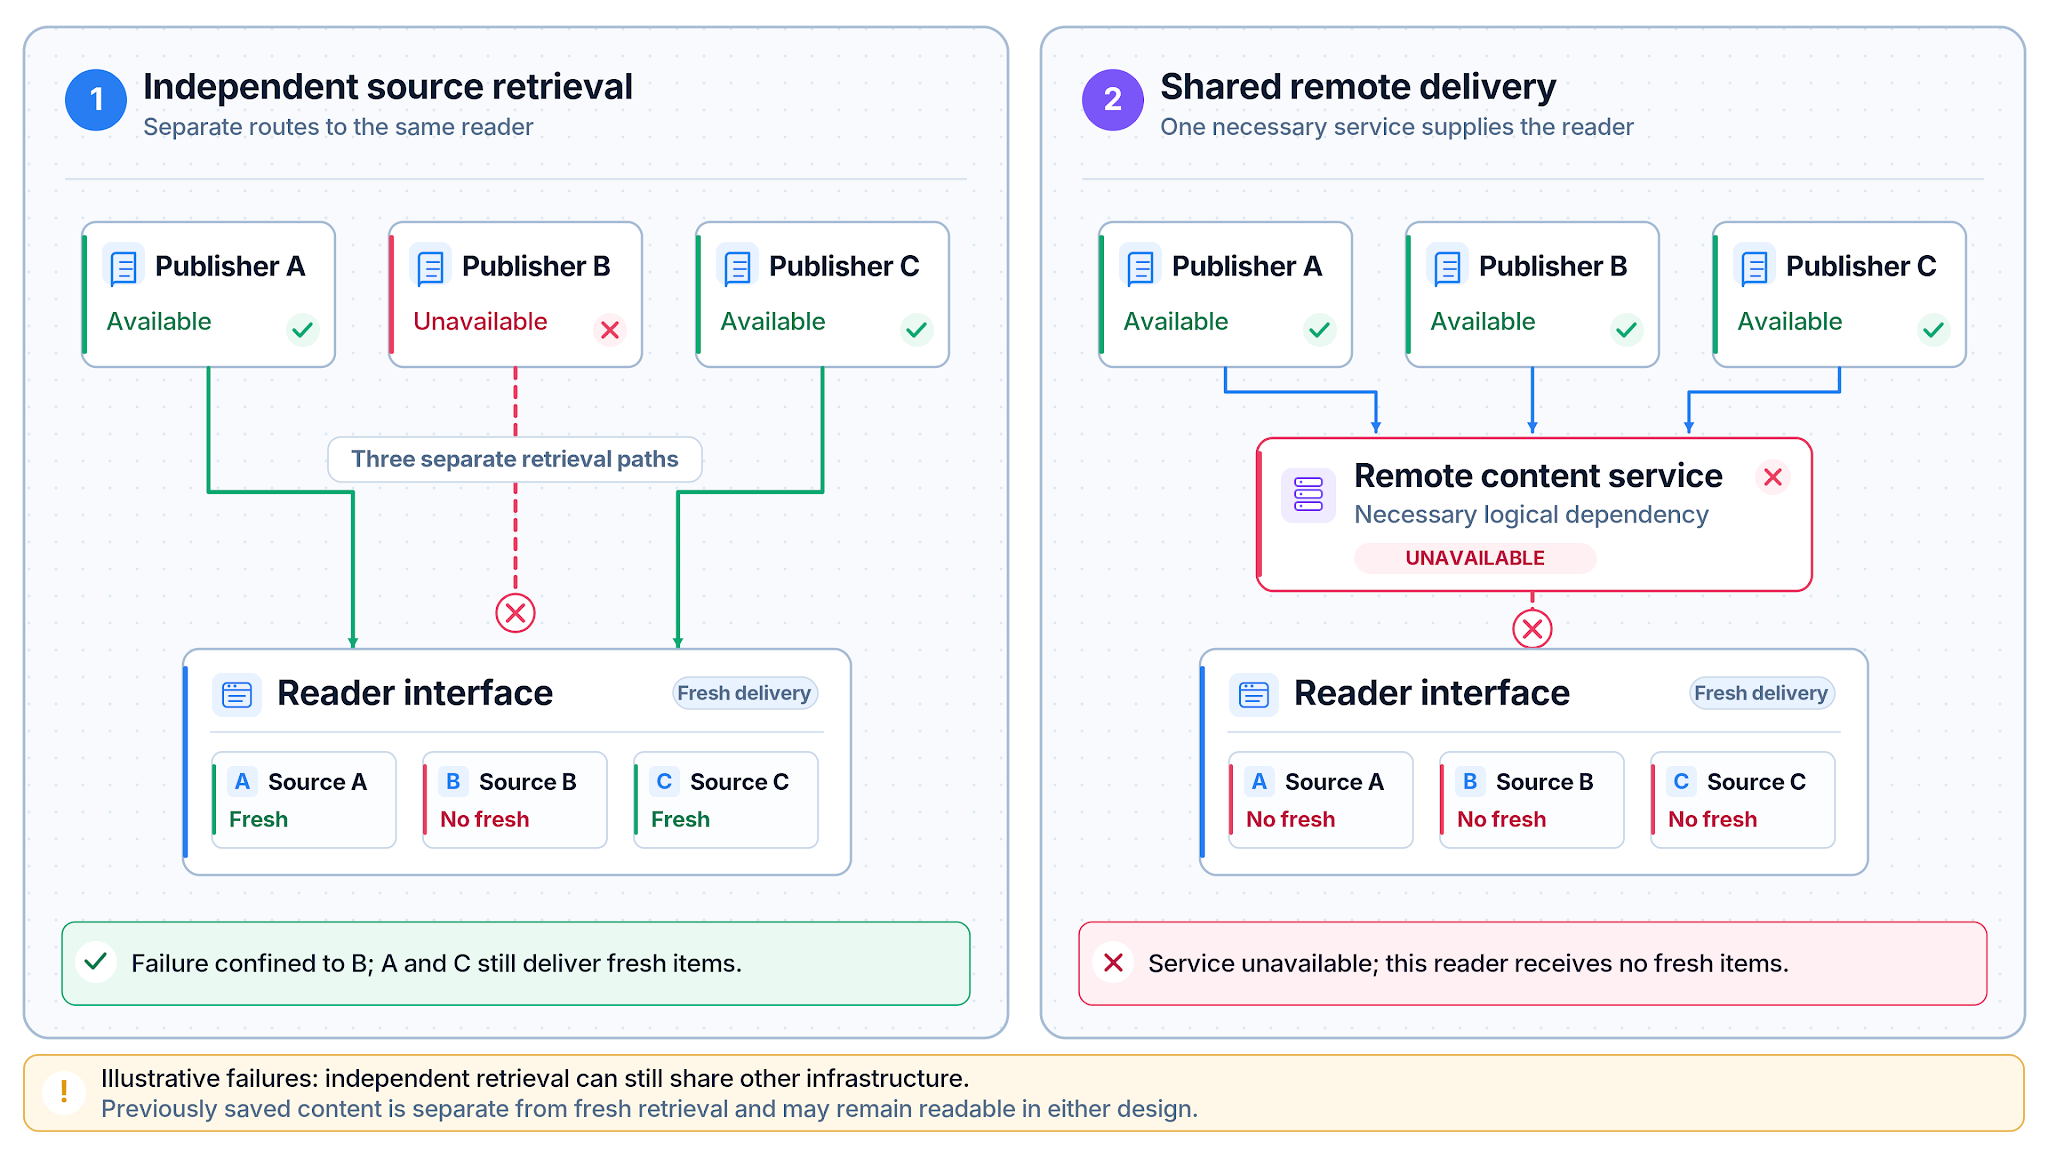
El material ya guardado en el dispositivo puede seguir siendo legible durante cualquiera de los dos tipos de interrupción, pero eso no demuestra que se pueda obtener contenido nuevo. La arquitectura de distribución también influye en qué entidades manejan la información. El cifrado suele proteger las comunicaciones mientras atraviesan las redes y limita lo que los operadores ajenos al intercambio pueden leer durante el recorrido. Sin embargo, una plataforma central que termina una conexión o procesa su contenido puede tener acceso a los datos que distribuye. El cifrado en tránsito no determina si esa plataforma merece confianza o si la información que entrega es correcta. La distinción importa tanto para la disponibilidad como para el tratamiento de los datos, aunque no resulte visible en la interfaz.
En resumen
El acceso útil a Internet requiere algo más que una conexión operativa desde un dispositivo. Cada respuesta depende de un recorrido por redes gestionadas de forma independiente y de un conjunto de sistemas capaces de proporcionarla. Los retrasos aparecen en ambas partes de esa cadena y las averías se extienden hasta donde alcanzan las dependencias indispensables. La arquitectura importa especialmente donde menos se ve: varias organizaciones pueden necesitar un mismo componente crítico, mientras que una sola aplicación puede convertir distintas fuentes en una dependencia común. Entender de dónde procede realmente una respuesta y qué podría impedir que llegase hace menos misteriosas las interrupciones aparentemente inconexas y permite evaluar mejor los diseños.
Conceptos que conviene conocer
| N.º | Término | Significado |
|---|---|---|
| 1 | Protocolo de Internet (IP) | Sistema de direcciones que ayuda a llevar información hacia su destino a través de las redes. |
| 2 | Proveedor de servicios de Internet (ISP) | Empresa que proporciona conexión al resto de Internet. |
| 3 | Punto único de fallo (SPoF) | Componente imprescindible para una operación sin alternativa eficaz. Si falla, la operación se detiene. |
| 4 | Red de distribución de contenidos (CDN) | Puede servir copias adecuadas de contenidos desde distintos lugares sin contactar siempre con su fuente original. |
| 5 | Sistema de nombres de dominio (DNS) | Ayuda a encontrar la dirección de un nombre como example.com, pero no determina la ruta. |
Referencias
- Google Cloud Service Health (22 de octubre de 2026). Informe preliminar sobre la interrupción del 20 de octubre en la región europe-west2. ↗
- Reuters (21 de octubre de 2026). «Europe's financial regulators query Google over cloud outage that hit banks». ↗
- Synergy Research Group (30 de julio de 2026). «Q2 Cloud Market Passes $143 Billion; Highest Growth Rate in Eight Years». Cuotas mundiales de ingresos de los servicios de infraestructura en la nube en el segundo trimestre de 2026: Amazon 28 %, Microsoft 20 %, Google 15 %. ↗
- W3Techs (consultado el 22 de octubre de 2026). «Usage statistics and market shares of reverse proxy services for websites». Mide el uso observado en sitios web de servicios como Cloudflare, Amazon CloudFront, Fastly y Akamai, no sus cuotas de ingresos como CDN ni sus cuotas de tráfico. ↗