
Les précédents articles de la série Fondations, « Comment fonctionnent les ordinateurs : l’employé de classement ultrarapide de Feynman » et « Comment les ordinateurs transforment les 0 et les 1 en mots et en images », expliquaient comment un ordinateur exécute des instructions et représente l’information sous forme de valeurs mémorisées. Transmettre cette information à un autre ordinateur pose un problème différent : les deux machines ne partagent pas leur mémoire et rien ne garantit qu’un lien direct les relie. Dans le modèle de Feynman, l’employé peut ouvrir un tiroir numéroté pour retrouver une donnée conservée à proximité. Pour obtenir une information stockée sur une machine distante, il doit au contraire envoyer une demande et attendre une réponse, comme s’il écrivait à un autre bureau plutôt que d’ouvrir un second tiroir. Le traitement peut être prêt à reprendre bien avant l’arrivée de cette réponse.
Internet rend de tels échanges possibles en reliant des réseaux exploités par différentes organisations. Une information peut partir du réseau auquel l’appareil s’est d’abord connecté, traverser plusieurs autres réseaux, atteindre un service capable de répondre, puis revenir par une autre succession de liaisons. Comprendre à la fois ce trajet et les systèmes qui produisent la réponse permet d’expliquer pourquoi l’accès varie selon les lieux, pourquoi certaines demandes sont lentes et pourquoi des services apparemment sans rapport peuvent tomber en panne ensemble.
De l’appareil au réseau mondial
Un téléphone, un ordinateur portable ou un autre appareil établit d’abord une connexion locale, souvent par Wi-Fi, réseau mobile ou câble. Les équipements situés à proximité transmettent ensuite le trafic vers un réseau plus étendu. À domicile et au bureau, un fournisseur d’accès à Internet (FAI) assure généralement cette connexion ; pour les appareils mobiles, le réseau de l’opérateur joue un rôle comparable. Chaque fournisseur peut échanger du trafic avec d’autres réseaux, ce qui permet aux communications de franchir de grandes distances et plusieurs organisations sans liaison physique réservée aux deux appareils.
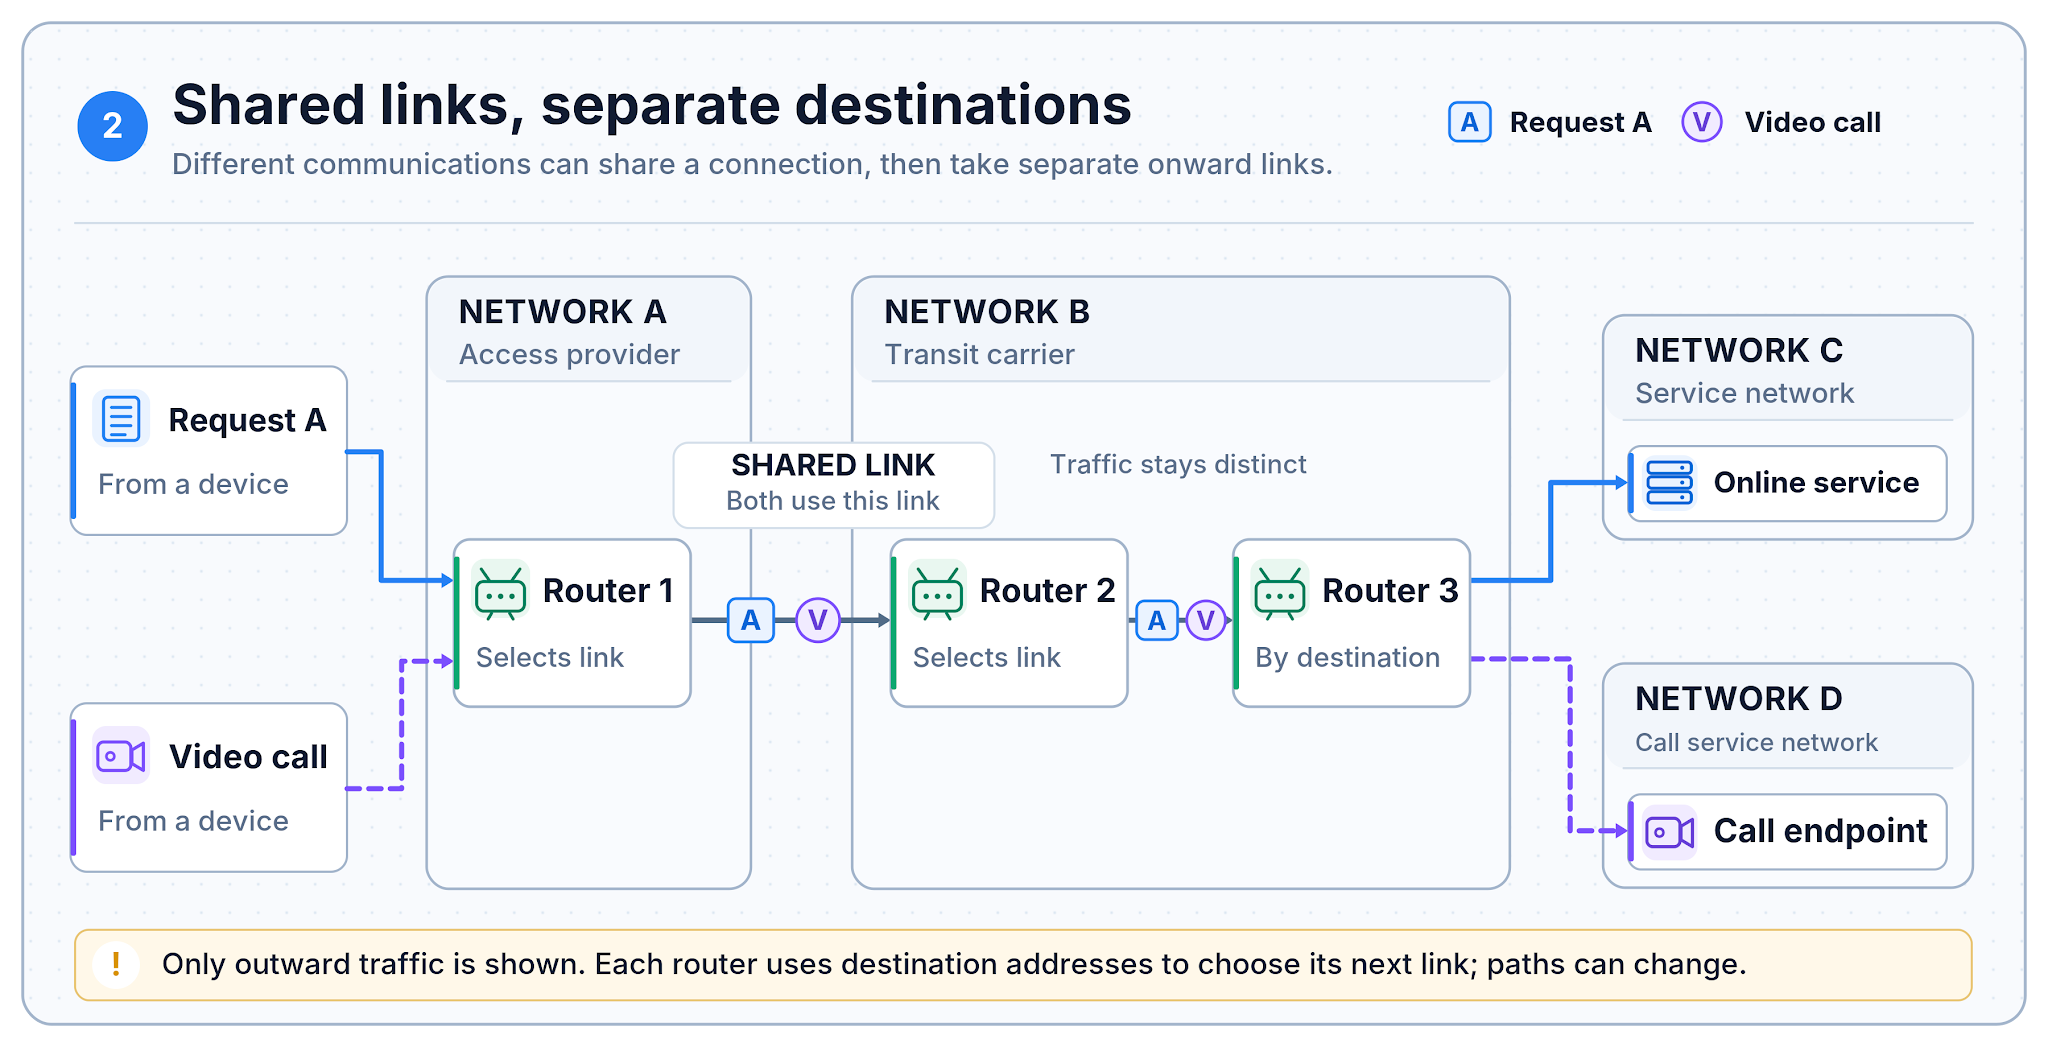
Internet fonctionne à cette échelle parce que de nombreuses communications empruntent les mêmes liaisons et équipements. Un appel vidéo, un message, le téléchargement d’un fichier et une demande adressée à un service peuvent utiliser une portion commune du réseau et se partager sa capacité disponible. Le protocole Internet (IP) fournit des adresses de destination, et les routeurs s’en servent pour choisir vers où transmettre le trafic. Un service peut disposer de plusieurs adresses, tandis que plusieurs machines peuvent se trouver derrière une adresse unique. L’adresse permet l’acheminement sans désigner pour autant un trajet physique ou une machine unique.
Comment un nom de service devient une adresse
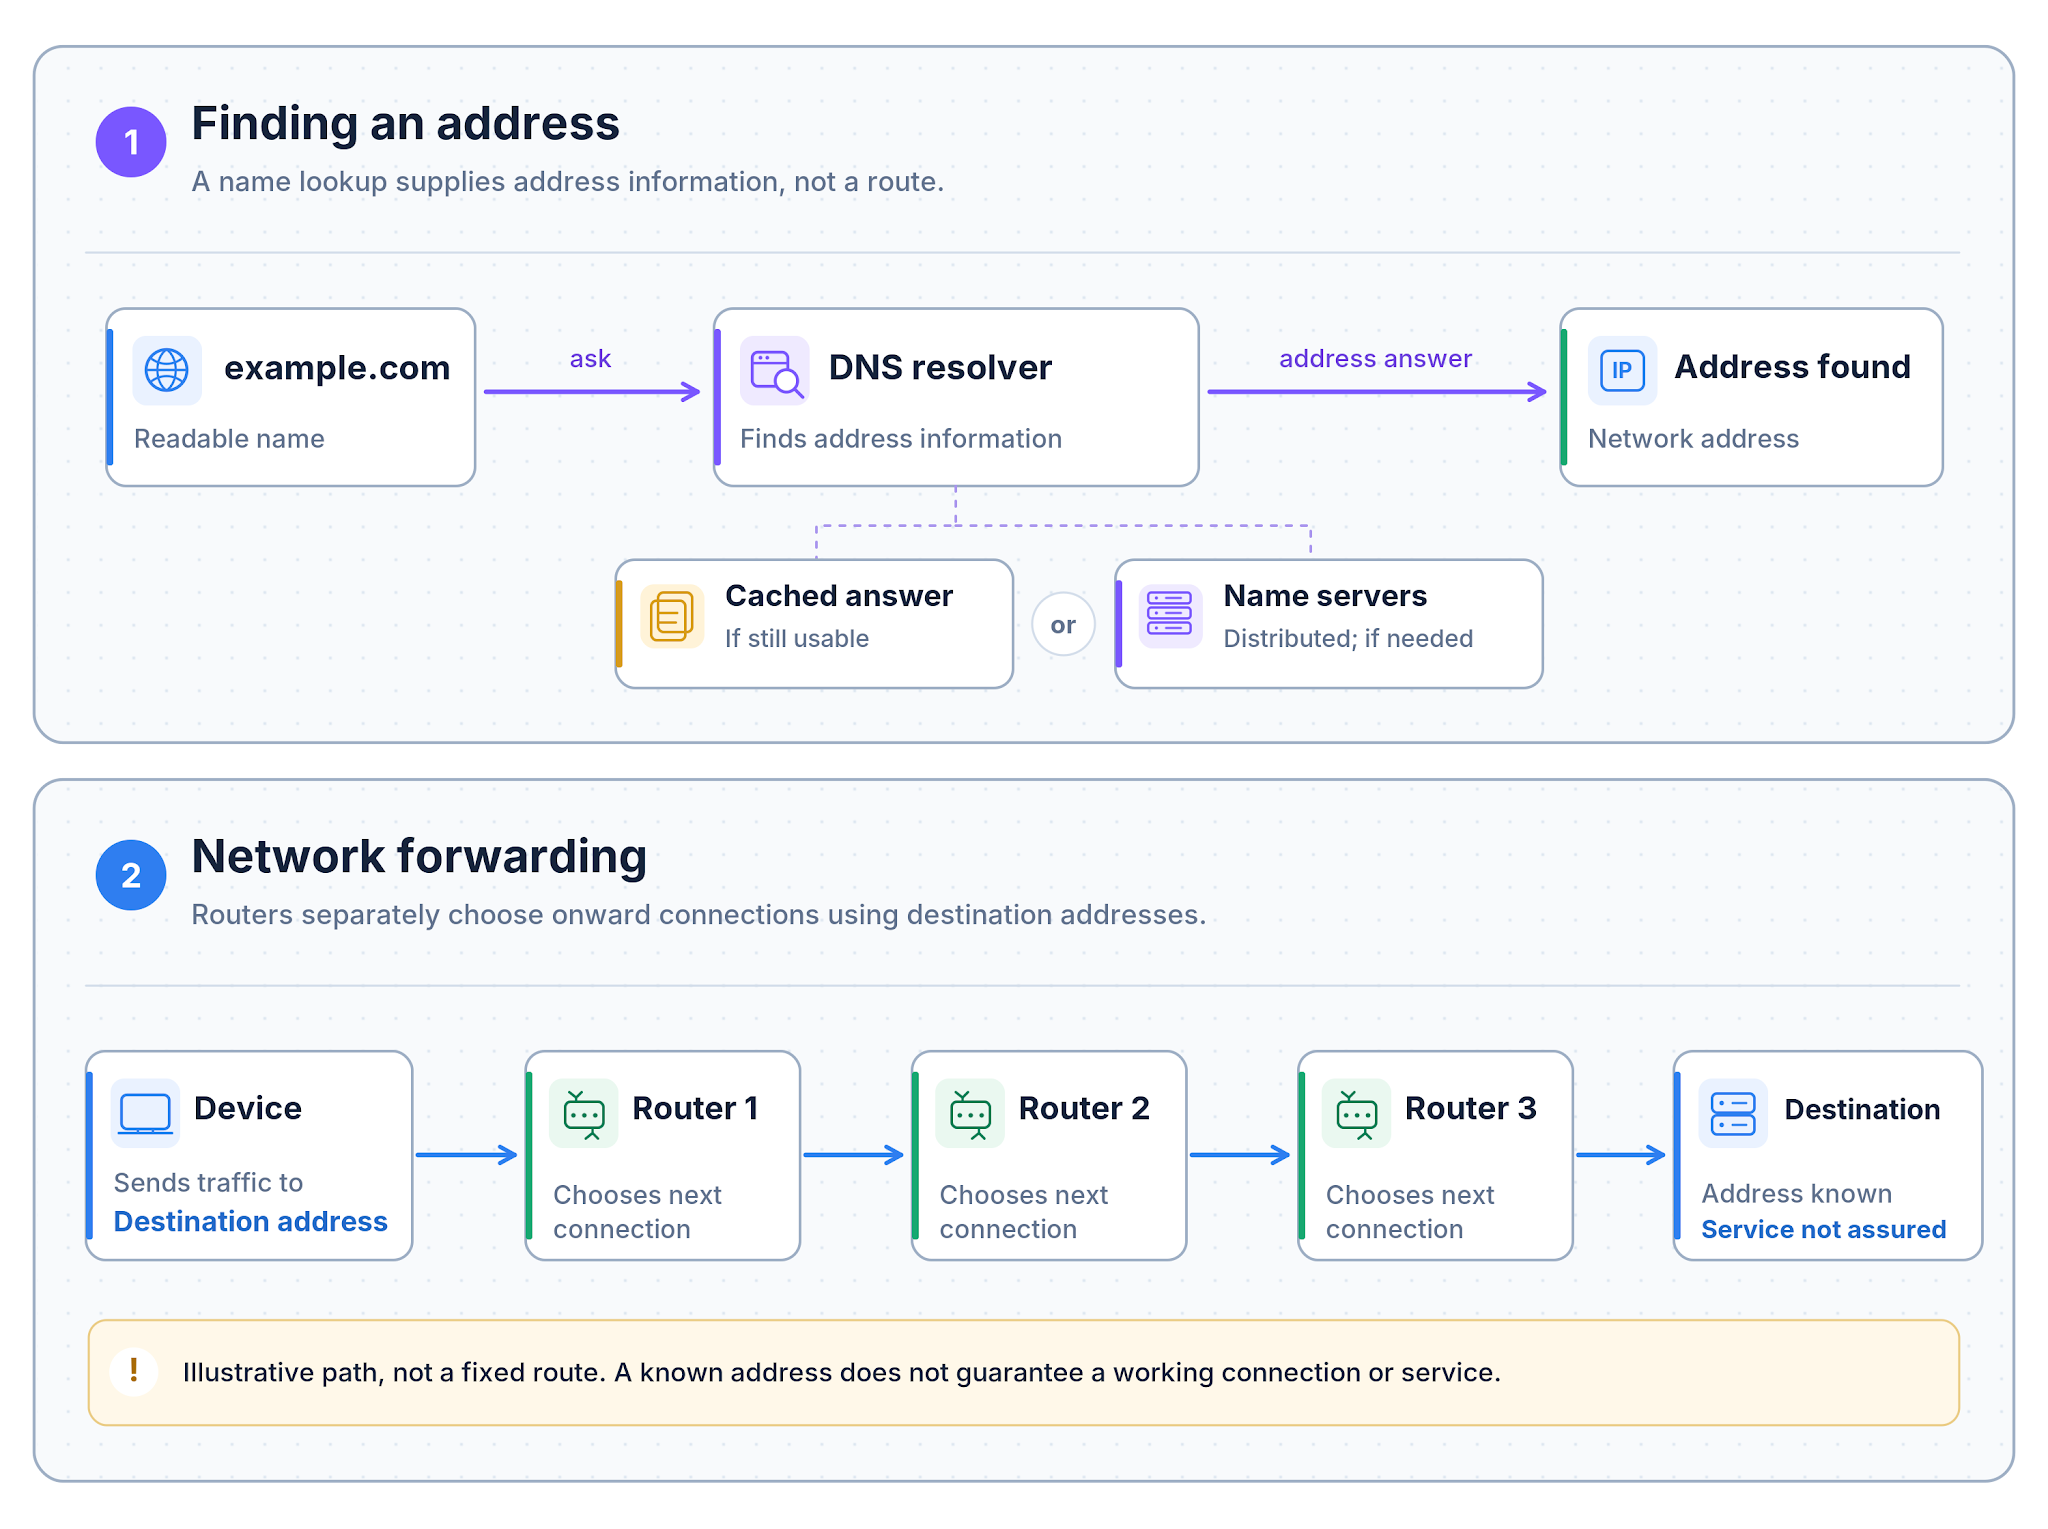
Avant de contacter un service nommé, comme example.com, une application a généralement besoin d’une adresse réseau. Le système de noms de domaine (DNS) aide à la retrouver, de la même manière que connaître l’adresse d’un bureau permet de lui envoyer une lettre. L’adresse peut déjà être enregistrée sur l’appareil ; sinon, celui-ci interroge un résolveur DNS. Le résolveur peut répondre à partir de son cache ou consulter d’autres serveurs de noms. Les informations relatives aux noms sont réparties entre de nombreux systèmes, et non réunies dans un annuaire mondial unique. Un service peut avoir plusieurs adresses valides, susceptibles de changer au fil du temps.
Lorsque la réponse nécessaire n’est pas en cache, la recherche peut entraîner de nouveaux échanges sur le réseau et retarder l’envoi de la demande par l’application. Une résolution de nom qui échoue peut empêcher l’accès par le nom alors même que les systèmes de destination fonctionnent. Trouver une adresse ne revient pas non plus à déterminer l’itinéraire. Une fois l’adresse obtenue, l’application envoie son trafic vers la destination, puis chaque routeur consulte ses propres informations de routage pour choisir la liaison suivante. La recherche du nom ne fixe donc ni le chemin emprunté ni la capacité du service à répondre.
Comment les réseaux acheminent l’information
Une fois l’adresse de destination connue, le trafic commence son parcours par la passerelle locale de l’appareil, généralement un routeur. Cette passerelle le transmet à un autre routeur, qui choisit la liaison suivante en fonction de l’adresse et de ses propres informations de routage. Le parcours peut traverser des réseaux exploités par plusieurs organisations : un fournisseur local peut remettre le trafic à un autre opérateur, qui le transporte vers le réseau desservant la destination. Chaque routeur prend une décision d’acheminement locale. Aucun poste de contrôle central ne dicte l’ensemble du trajet de chaque demande. Des communications provenant de sources différentes et destinées à des endroits différents peuvent néanmoins partager certaines liaisons.
On appelle souvent « saut » (hop) le passage d’un routeur au suivant. Un nombre de sauts plus élevé n’implique pas à lui seul un délai plus long : la distance, les liaisons disponibles, la congestion et l’emplacement du système qui répond comptent aussi. Les réseaux s’échangent des informations indiquant quelles destinations sont accessibles par quels voisins. Lorsqu’une liaison ou un réseau tombe en panne, ces informations peuvent changer, et les routeurs peuvent adopter d’autres chemins si des solutions utilisables existent et si les politiques des opérateurs le permettent. La mise à jour de ces directions peut prendre du temps, et certaines destinations n’ont aucune solution de remplacement. Même quand la demande arrive à destination, la réponse peut emprunter d’autres routeurs au retour.
D’où viennent les réponses et pourquoi elles prennent du temps
Quand une demande atteint l’infrastructure qui dessert sa destination, un système doit encore préparer la réponse. Il peut récupérer une information stockée, effectuer un calcul, vérifier des autorisations ou modifier un enregistrement. L’organisation qui propose le service peut exploiter elle-même ses machines ou dépendre d’un hébergeur. Un chemin réseau opérationnel ne garantit donc pas une réponse rapide : après l’arrivée de la demande, un logiciel, un stockage ou un autre système peut être ralenti, surchargé, mal configuré ou indisponible. Même pour un contenu public, redemander sans cesse la même image ou le même fichier inchangé à une machine distante peut gaspiller du temps et de la capacité réseau.
Il est possible de conserver des copies de certains contenus à différents endroits. Un réseau de diffusion de contenu (CDN) peut répondre à certaines demandes depuis une copie mise en cache, sans solliciter la source initiale, souvent appelée serveur d’origine. Lorsqu’aucune copie adéquate n’est disponible, le système de diffusion peut devoir récupérer le contenu dans un autre cache ou auprès de l’origine avant de répondre. D’autres opérations, comme se connecter à un compte, modifier des données enregistrées ou demander des informations à jour, peuvent nécessiter un nouveau traitement. Les systèmes qui stockent, traitent et diffusent l’information peuvent appartenir à différentes organisations tout en se présentant comme un seul service. La réponse repart ensuite sur le réseau vers l’appareil demandeur, qui l’interprète.
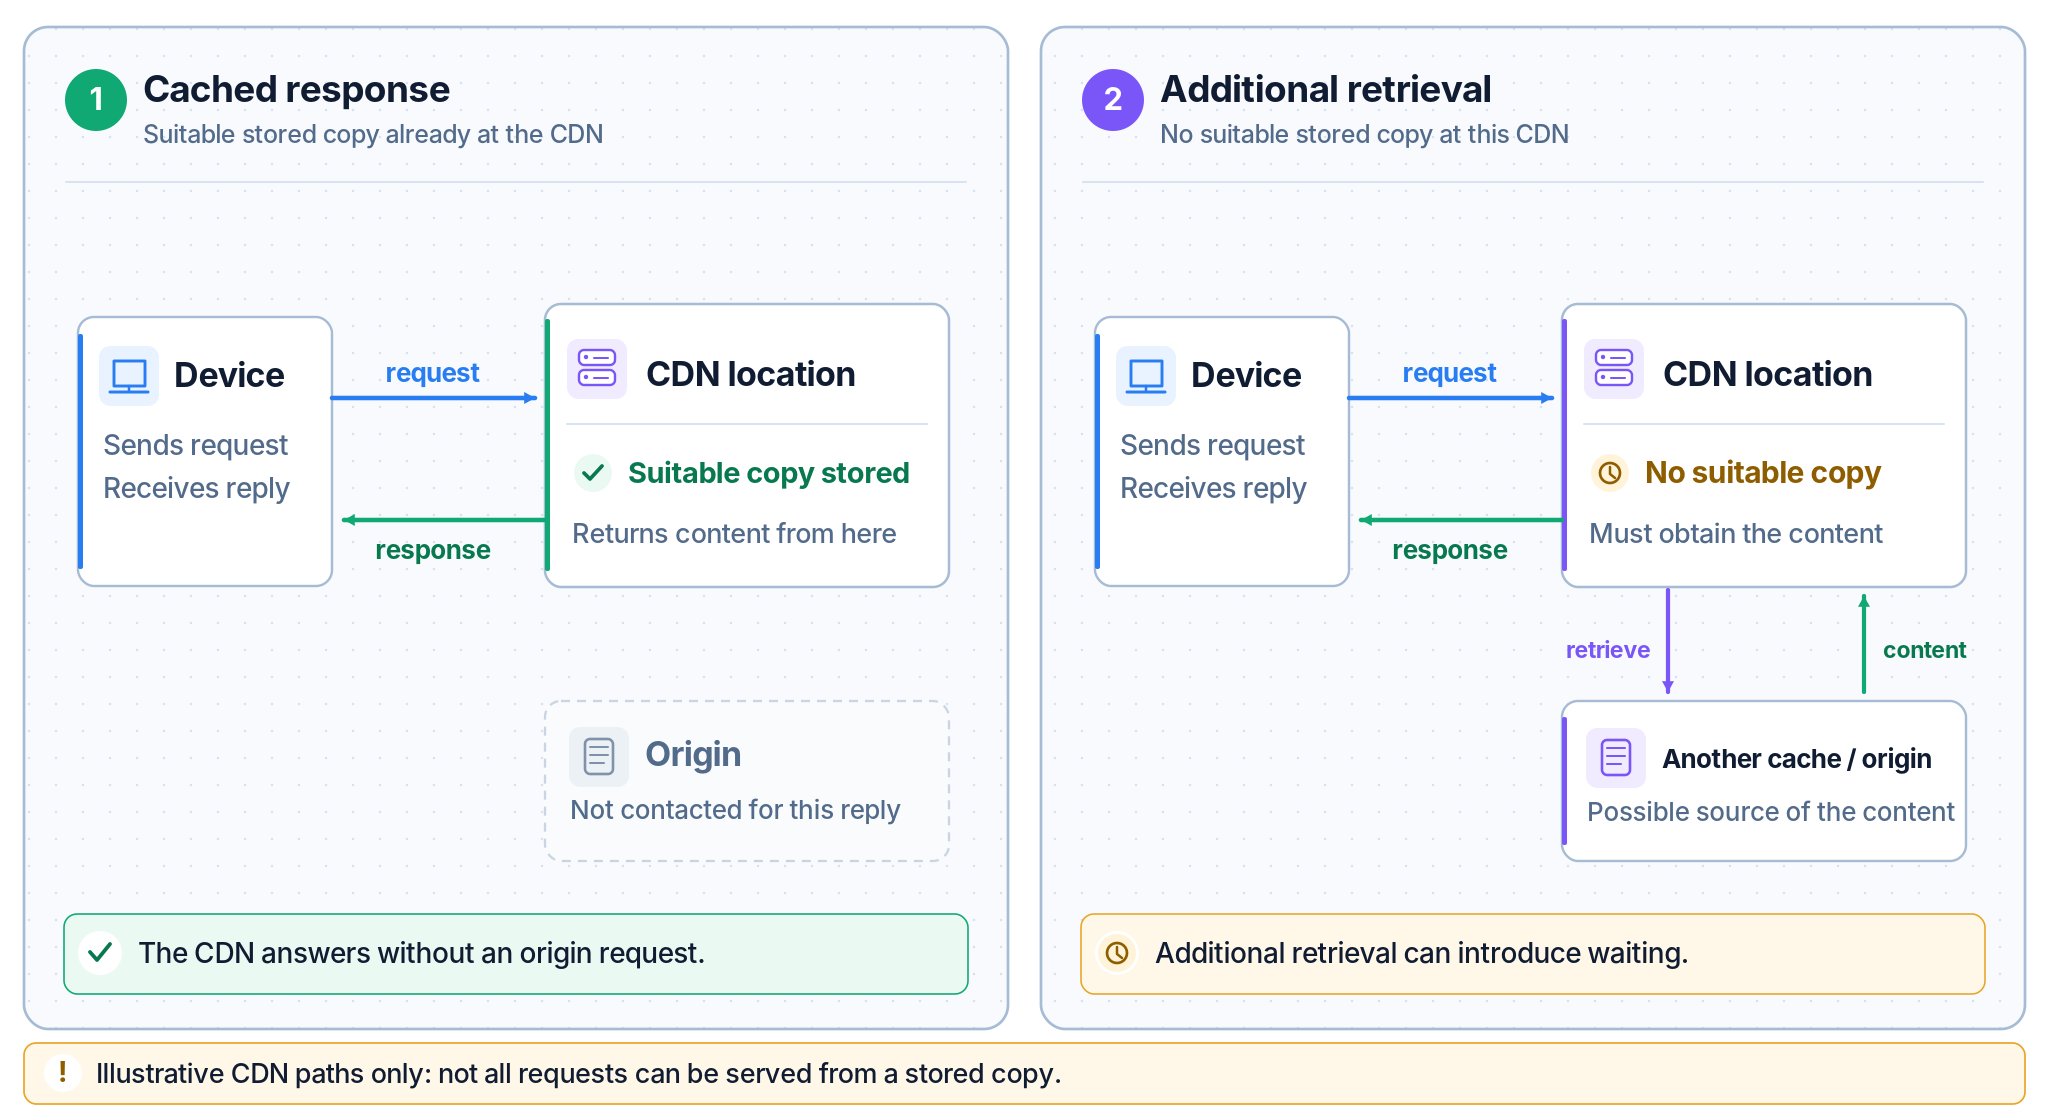
Un même service peut sembler rapide à un endroit et lent à un autre. Un utilisateur peut atteindre un serveur ou un point de présence CDN proche par des réseaux bien interconnectés, tandis qu’un autre passe par des liaisons plus longues, plus encombrées ou moins directes. La latence réseau désigne le temps consacré au trajet sur le réseau ; l’aller de la demande et le retour de la réponse contribuent tous deux à l’attente. Le serveur géographiquement le plus proche n’est donc pas forcément le plus rapide à joindre. Le nombre de routeurs traversés renseigne sur le parcours, sans remplacer la mesure du temps réel des échanges. Une recherche DNS peut aussi ajouter son propre délai avant l’envoi de la demande si aucune réponse adéquate n’est en cache.
Le temps de livraison comprend également le travail effectué après l’arrivée de la demande. Le système chargé de répondre peut devoir lire le stockage, produire un résultat, récupérer un élément absent du cache ou attendre un autre service. Une connexion capable de transférer rapidement de gros volumes de données ne supprime pas ces délais. Si la réponse tarde trop ou n’arrive jamais, l’application peut signaler un délai d’attente dépassé et éventuellement réessayer, selon sa conception. L’endroit où l’information est stockée et traitée détermine donc non seulement la rapidité, mais aussi les systèmes qui doivent rester disponibles pour que l’opération aboutisse. Ce point devient crucial lorsque plusieurs services reposent sur la même infrastructure.
Pourquoi plusieurs services peuvent tomber en panne ensemble
Un site marchand, une application bancaire et un service vidéo peuvent appartenir à des organisations distinctes et remplir des fonctions différentes, tout en dépendant d’une même infrastructure. Des fournisseurs tels qu’Amazon Web Services, Microsoft Azure et Google Cloud proposent des capacités de calcul et de stockage ; Cloudflare, Akamai et Amazon CloudFront assurent différentes formes de diffusion de contenu et d’autres services réseau. Les catégories se recoupent parfois, et chaque fournisseur exploite de nombreux composants distincts. Nommer un prestataire ne prouve donc ni une dépendance technique commune ni la cause d’une panne particulière. Il faut plutôt déterminer les composants réellement nécessaires à chaque service pour effectuer une opération précise.
Un point unique de défaillance (single point of failure, SPoF) est un composant indispensable à une opération pour lequel il n’existe aucune solution de remplacement efficace. Il ne s’agit pas nécessairement d’une seule machine physique. Une plateforme peut fonctionner sur des milliers d’ordinateurs et pourtant dépendre d’un unique système logique pour vérifier les identités, gérer la configuration ou accéder aux informations stockées. Si ce système tombe en panne, des machines encore en parfait état peuvent ne plus pouvoir traiter les demandes. La séparation géographique n’aide que si les dépendances importantes sont suffisamment indépendantes. Plusieurs centres de données peuvent ainsi partager un même service de contrôle, tandis que plusieurs applications chez le même fournisseur peuvent s’appuyer sur des composants différents qui ne sont pas touchés. La résilience dépend des défaillances qu’une architecture peut supporter, et non du seul nombre de machines ou de sites.
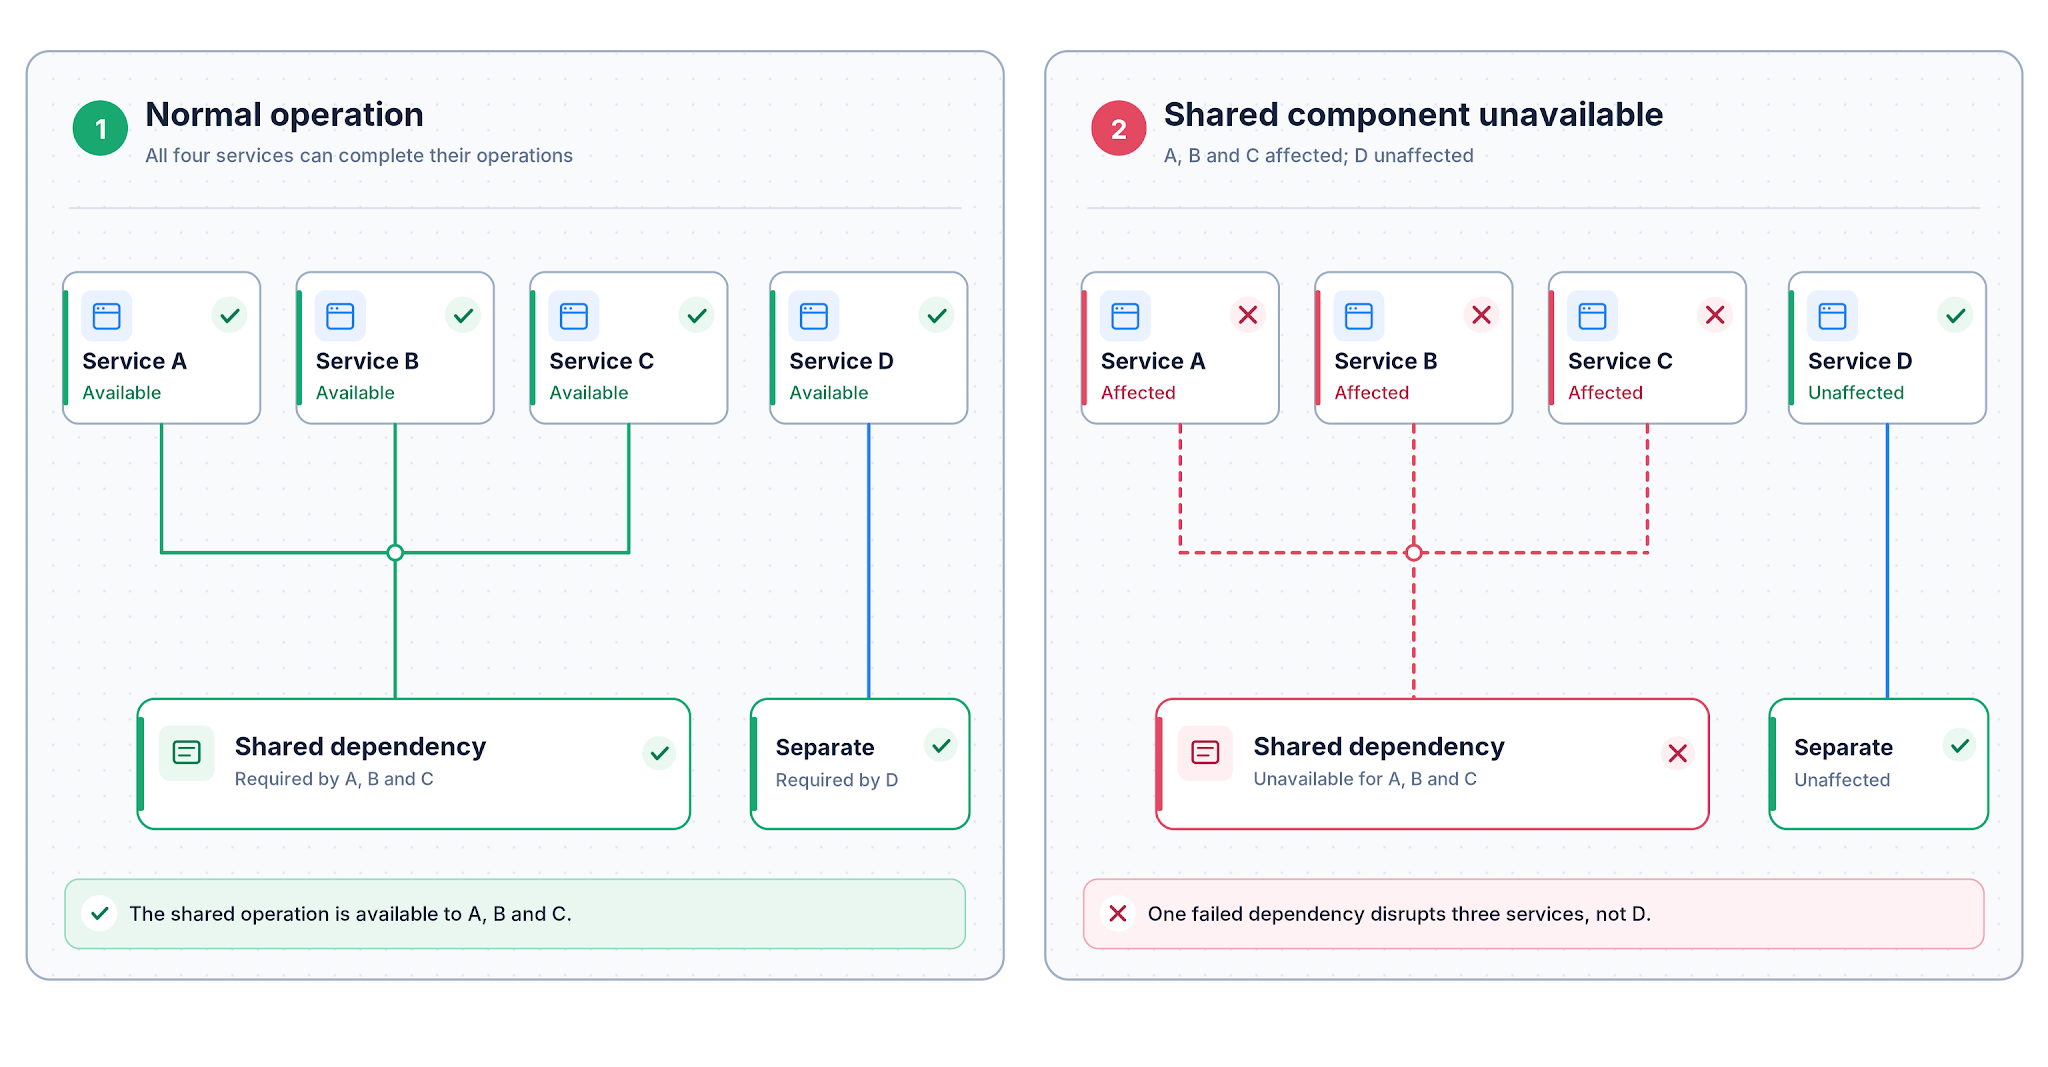
Des pannes survenant à différents niveaux peuvent produire des symptômes presque identiques. Un réseau d’accès peut perdre son chemin vers des services pourtant opérationnels ; l’infrastructure de nommage, d’hébergement ou de diffusion peut cesser de fonctionner ; ou une application peut échouer alors que le réseau reste disponible. Une interruption touchant plusieurs organisations suggère donc de possibles dépendances communes, sans identifier à elle seule le composant défaillant.
Le 20 octobre 2026, un incident d’alimentation électrique a perturbé des services Google Cloud dans la région de Londres, tandis que des clients de Revolut, Lloyds et HSBC signalaient des difficultés d’accès aux services bancaires. Dans son rapport préliminaire, Google expliquait que la perte d’une zone de centre de données avait également perturbé des services ailleurs dans la région, le travail étant transféré vers l’infrastructure restante alors que certains systèmes régionaux dépendaient encore de composants situés dans la zone indisponible. Reuters a fait état d’un lien entre l’interruption de Revolut et l’incident Google Cloud ; les chemins de défaillance précis ayant affecté chaque établissement n’ont toutefois pas été établis publiquement.
Ce type d’incident montre aussi pourquoi ajouter des machines ou des itinéraires de secours ne suffit pas. Un autre chemin réseau ne répare pas une application défaillante ; des serveurs supplémentaires ne servent à rien si tous dépendent du même système de contrôle. Une solution de repli n’a de valeur que si elle reste utilisable lorsque la dépendance visée cesse de fonctionner. Pour juger de la fiabilité, la bonne question consiste à déterminer quels composants peuvent devenir indisponibles sans empêcher le service d’accomplir l’opération attendue.
Comment les applications d’actualité obtiennent les articles
Une application d’actualité illustre concrètement la manière dont l’architecture logicielle modifie l’étendue d’une panne. Elle peut récupérer des contenus directement auprès de plusieurs éditeurs, en contactant chaque source selon les besoins. Si un éditeur devient indisponible, les demandes adressées aux autres peuvent continuer de réussir, à condition que leurs chemins de récupération restent opérationnels. Cela ne rend pas les éditeurs parfaitement indépendants, puisqu’ils peuvent partager des infrastructures DNS, d’hébergement ou de diffusion. Mais l’application n’a pas introduit un service distant supplémentaire dont la disponibilité serait indispensable pour obtenir chaque nouveau contenu de tous les éditeurs.
Une autre application peut récupérer les contenus de ces mêmes éditeurs auprès d’une plateforme centrale qui les rassemble avant de les lui transmettre. Cette plateforme peut utiliser de nombreux serveurs et emplacements, mais si l’application ne dispose d’aucun autre chemin pour obtenir du contenu récent, ce service central devient une dépendance nécessaire pour chaque source affichée. Une panne de la plateforme peut arrêter l’arrivée des nouveautés même lorsque les éditeurs continuent de fonctionner. Les lecteurs peuvent voir des interfaces presque identiques dans les deux architectures ; ce qui change, ce sont les systèmes devant fonctionner pour que la prochaine demande réussisse.
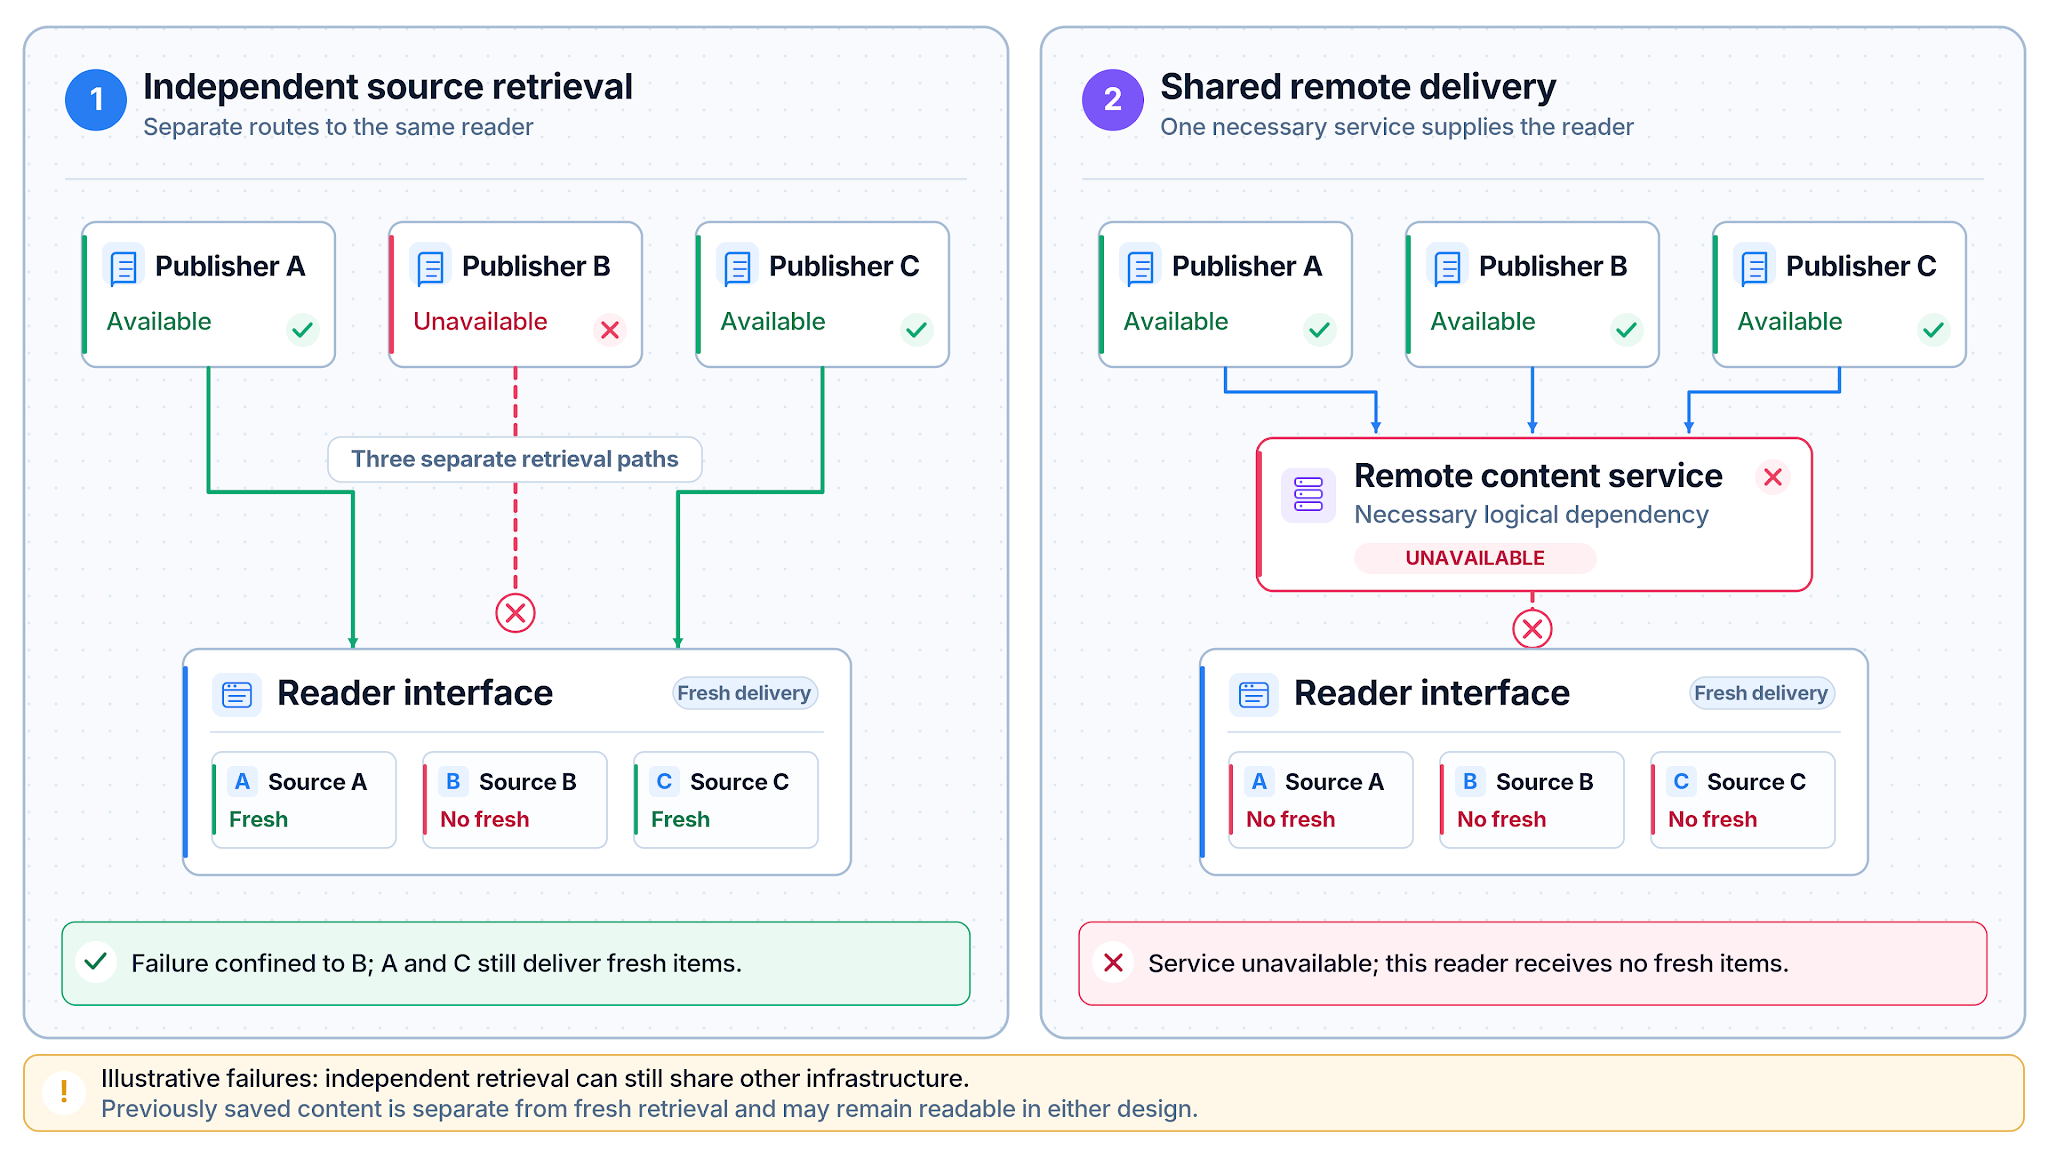
Un contenu déjà conservé sur l’appareil peut rester lisible pendant l’une ou l’autre panne, sans que cela garantisse la possibilité de récupérer du contenu récent. L’architecture de diffusion détermine aussi quelles parties manipulent les informations. Le chiffrement protège généralement les communications pendant leur transit sur les réseaux, en limitant ce que les opérateurs non concernés peuvent en lire. En revanche, une plateforme centrale qui termine une connexion ou traite les données peut avoir accès au contenu qu’elle diffuse. Le chiffrement en transit ne dit ni si cette plateforme est digne de confiance ni si les informations fournies sont exactes. Cette distinction touche à la disponibilité comme à la gestion des données, même lorsque l’interface ne laisse rien paraître.
En bref
L’accès à Internet ne dépend pas seulement d’une connexion fonctionnelle depuis un appareil. Toute réponse utile nécessite un parcours à travers des réseaux exploités par des organisations indépendantes et des systèmes capables de fournir effectivement cette réponse. Les délais se produisent dans les deux parties de cette chaîne ; les défaillances se propagent à l’étendue des dépendances indispensables. L’architecture compte particulièrement là où elle est la moins visible : plusieurs organisations peuvent dépendre d’un même composant essentiel, tandis qu’une seule application peut transformer des sources distinctes en une dépendance commune. Comprendre d’où vient réellement une réponse, et ce qui pourrait l’empêcher d’arriver, rend les pannes apparemment sans rapport moins mystérieuses et permet de mieux apprécier les choix d’architecture.
Quelques notions à connaître
| N° | Terme | Signification |
|---|---|---|
| 1 | Fournisseur d’accès à Internet (FAI) | Entreprise qui fournit la connexion au réseau Internet au-delà du réseau local. |
| 2 | Point unique de défaillance (SPoF) | Composant nécessaire à une opération sans solution de remplacement efficace ; sa panne empêche cette opération. |
| 3 | Protocole Internet (IP) | Système d’adressage qui permet d’acheminer les informations vers leur destination à travers les réseaux. |
| 4 | Réseau de diffusion de contenu (CDN) | Peut fournir des copies de contenus adaptés depuis plusieurs lieux sans solliciter systématiquement leur source d’origine. |
| 5 | Système de noms de domaine (DNS) | Aide à retrouver une adresse à partir d’un nom comme example.com, mais ne choisit pas le chemin emprunté. |
Références
- Google Cloud Service Health (22 octobre 2026). Rapport préliminaire sur l’incident du 20 octobre dans la région europe-west2. ↗
- Reuters (21 octobre 2026). « Europe's financial regulators query Google over cloud outage that hit banks ». ↗
- Synergy Research Group (30 juillet 2026). « Q2 Cloud Market Passes $143 Billion; Highest Growth Rate in Eight Years ». Parts du chiffre d’affaires mondial des services d’infrastructure cloud au deuxième trimestre 2026 : Amazon 28 %, Microsoft 20 % et Google 15 %. ↗
- W3Techs (consulté le 22 octobre 2026). « Usage statistics and market shares of reverse proxy services for websites ». Mesure l’utilisation observée sur les sites web de services tels que Cloudflare, Amazon CloudFront, Fastly et Akamai ; il ne s’agit ni des parts de revenus des CDN ni des parts de trafic. ↗