
Richard Feynman est une légende de la science, mais ce n’est pas, à lui seul, la raison pour laquelle nous ouvrons le blog technique de XMAKYNA avec cette conférence. Nous commençons ici parce qu’une grande partie de l’ingénierie qui nous importe finit par se ramener à des questions très simples : qu’a lu la machine ? Qu’a-t-elle stocké ? Qu’a-t-elle fait ensuite ? Sur quoi avait-elle le droit d’agir ? Le modèle de l’employé de classement de Feynman nous donne un langage commun pour poser ces questions. Les articles suivants pourront s’appuyer sur cette base au lieu de la réexpliquer depuis le début.
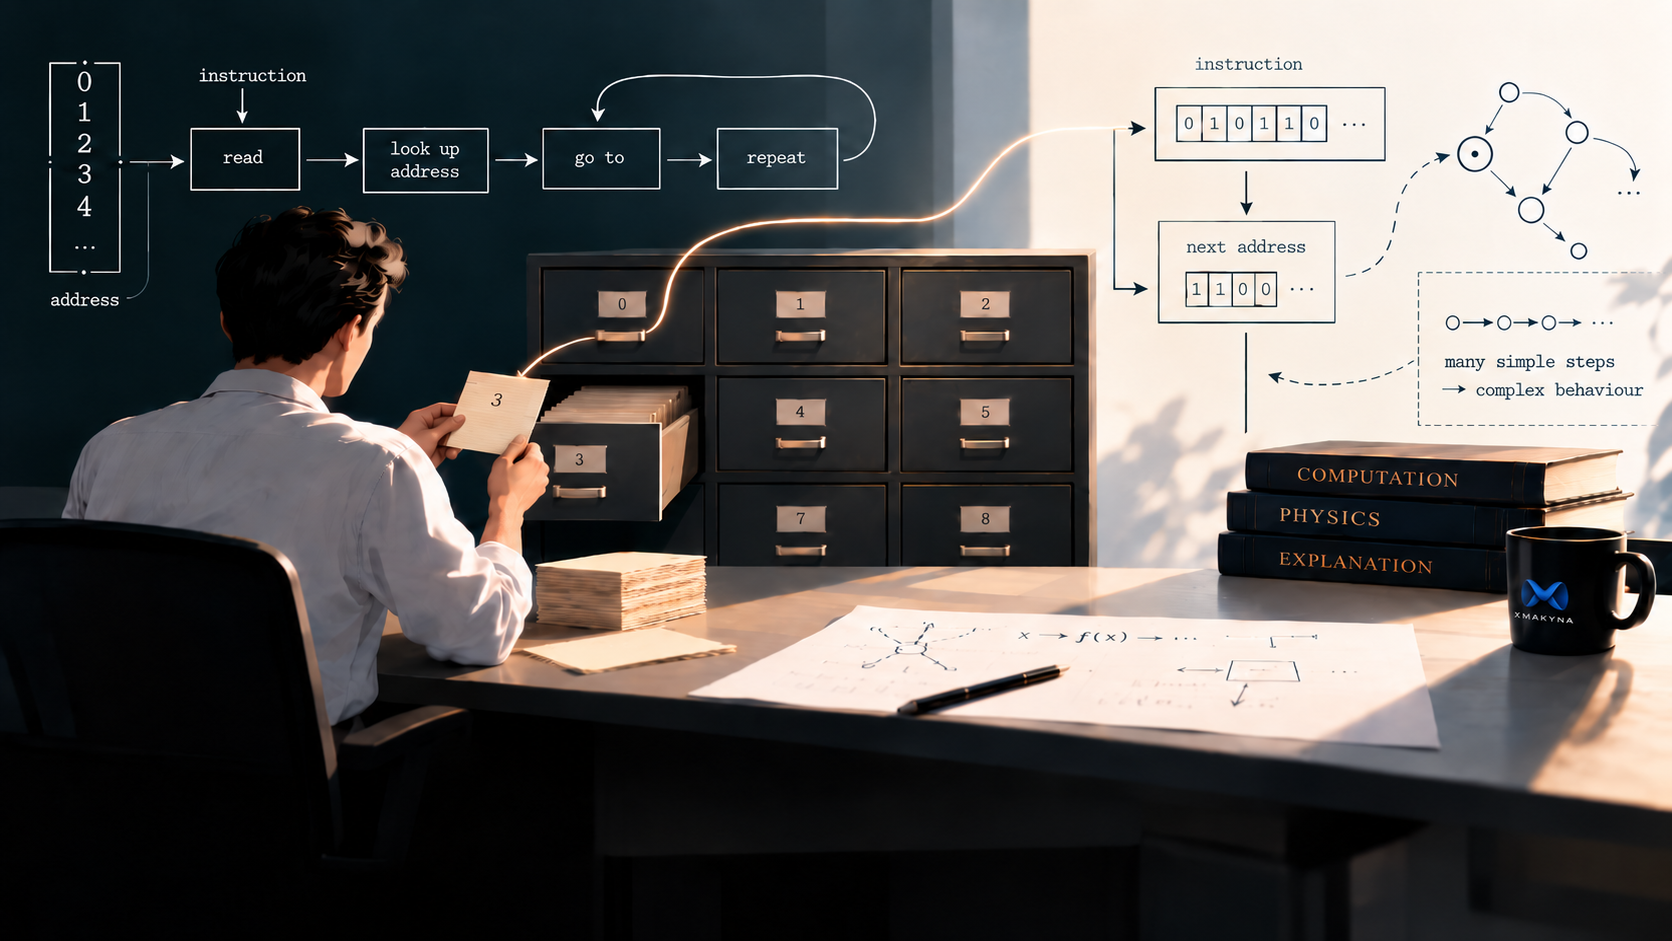
Plus de quarante ans plus tard (le séminaire a été enregistré en 1985), la conférence garde une fraîcheur remarquable. Elle peut parler à presque toute personne curieuse d’informatique, parce que Feynman ne commence pas par le jargon. Il nous donne un employé, des tiroirs numérotés, des instructions simples, une note indiquant à l’employé où aller ensuite et des valeurs qui peuvent pointer vers d’autres tiroirs. À partir de ces quelques éléments, la mécanique fondamentale d’un ordinateur commence à apparaître.
Ni la conférence ni cet article n’expliquent tout sur les ordinateurs. Ils en expliquent toutefois un noyau utile : l’information est stockée quelque part, les instructions déterminent ce qui se passe ensuite, des valeurs stockées peuvent orienter la machine ailleurs, et des opérations simples peuvent se combiner pour produire des comportements bien plus complexes.
Cela compte aussi pour la sécurité. Beaucoup de défaillances graves deviennent bien moins mystérieuses lorsqu’on les ramène à cette image. La machine peut lire au mauvais endroit, suivre la mauvaise étape suivante, faire confiance à une valeur qui signifie autre chose pour une autre partie du système, ou être délibérément orientée par quelqu’un qui peut influencer ce qui se trouve dans un tiroir ou l’endroit où l’employé regardera ensuite.
La machine peut suivre ses instructions à la perfection et pourtant faire quelque chose de dangereux. Le comprendre est l’un des fondements auxquels nous reviendrons.
La conférence résonne autrement aujourd’hui, alors que nous vivons avec les grands modèles de langage (LLM) et d’autres systèmes dont les sorties peuvent sembler extraordinairement capables. Feynman n’expliquait pas l’IA moderne, et cet article ne prétendra pas le contraire. Ce que sa conférence nous apporte est plus fondamental : une manière de regarder au-delà d’une sortie impressionnante et de demander ce que la machine fait réellement, comment elle est arrivée là, où elle peut se tromper et ce qui se passe lorsque ces erreurs ont des conséquences. Pour nous, c’est une préoccupation d’ingénierie centrale dans notre usage de l’IA : qu’un code puisse être construit (qu’il compile), qu’il s’exécute et qu’il paraisse plausible ne suffit pas ; il faut encore établir qu’il est correct.
Cet article commence donc délibérément par les fondamentaux. Il suit les métaphores simples de Feynman assez loin pour qu’une personne non spécialiste puisse se construire une image solide de la manière dont un ordinateur trouve une information, suit des instructions, change de direction et produit un comportement complexe à partir d’étapes simples. Nous aurons besoin de cette image encore et encore.
Commencer par un employé et quelques tiroirs
Imaginons un employé dans une pièce remplie de tiroirs numérotés. Chaque tiroir peut contenir un nombre ou une autre information simple. L’employé peut ouvrir un tiroir, lire ce qu’il contient, copier une valeur, écrire une nouvelle valeur ailleurs, comparer deux valeurs et suivre une instruction qui lui indique quoi faire ensuite.
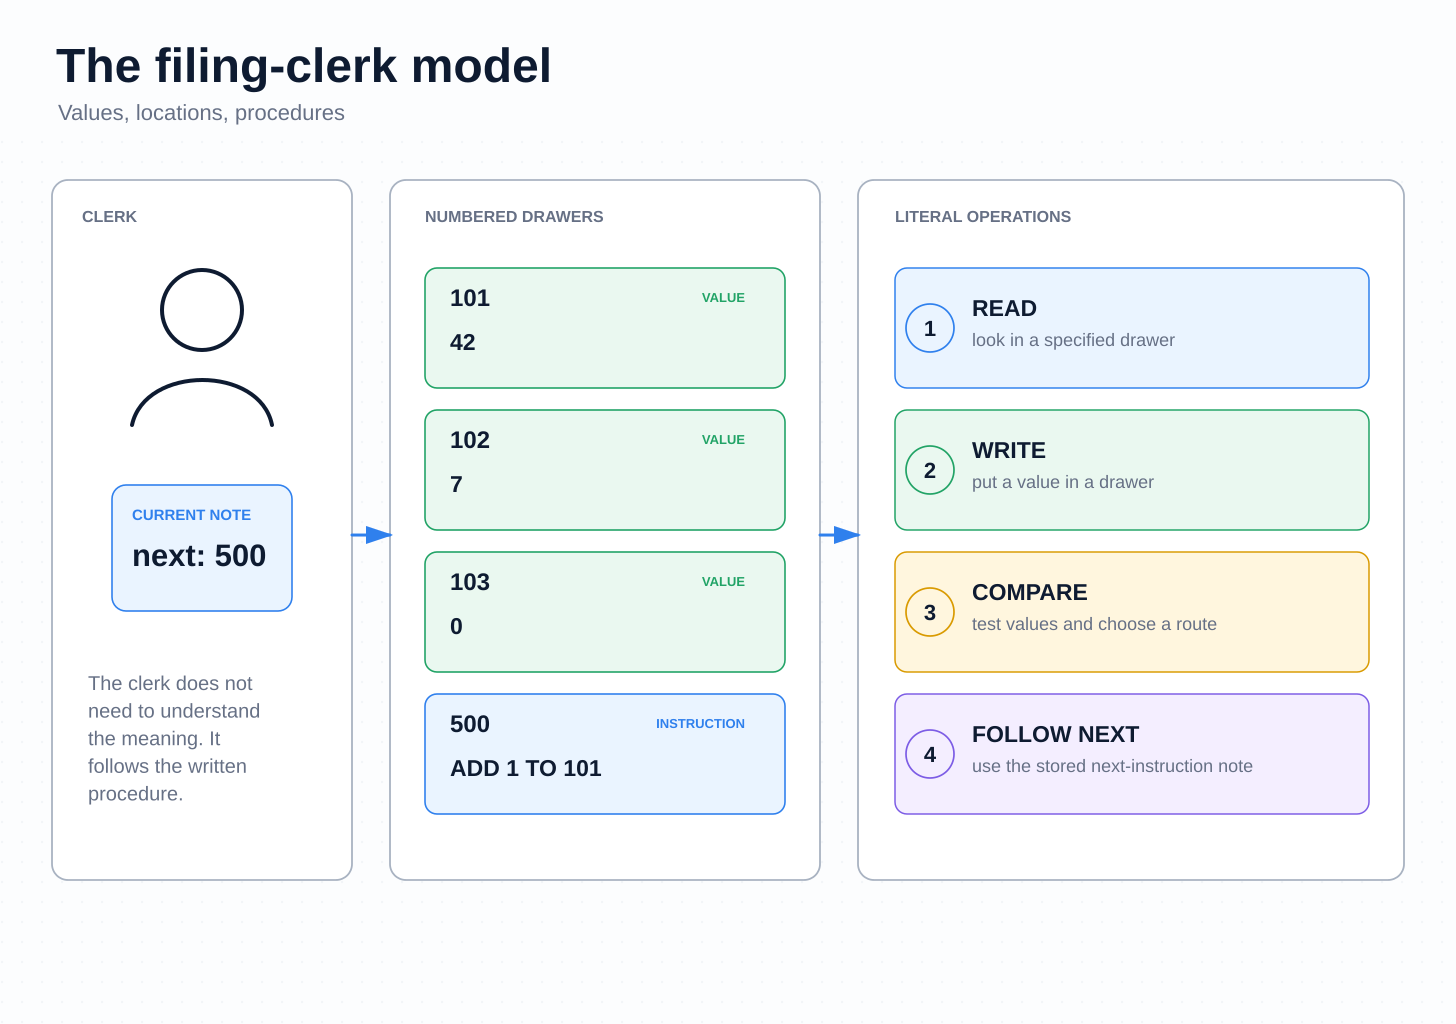
C’est volontairement peu spectaculaire. L’employé n’a pas besoin de savoir si un nombre représente de l’argent, une couleur, une lettre, une température, une position sur un échiquier ou l’adresse d’un autre tiroir. Le sens vient de la représentation que nous imposons. Pour l’employé, il y a des valeurs, des emplacements et des procédures.
C’est l’une des manières les plus utiles de démystifier un ordinateur. Une machine peut produire, vue de l’extérieur, un comportement étonnant tout en étant construite à partir d’opérations qui, prises séparément, sont presque embarrassantes de simplicité. La sophistication vient de l’organisation : ce qui est stocké, la manière dont c’est représenté, l’instruction qui s’exécute ensuite et le nombre d’opérations de ce type que l’on peut enchaîner.
Le chemin dans le programme est lui aussi stocké
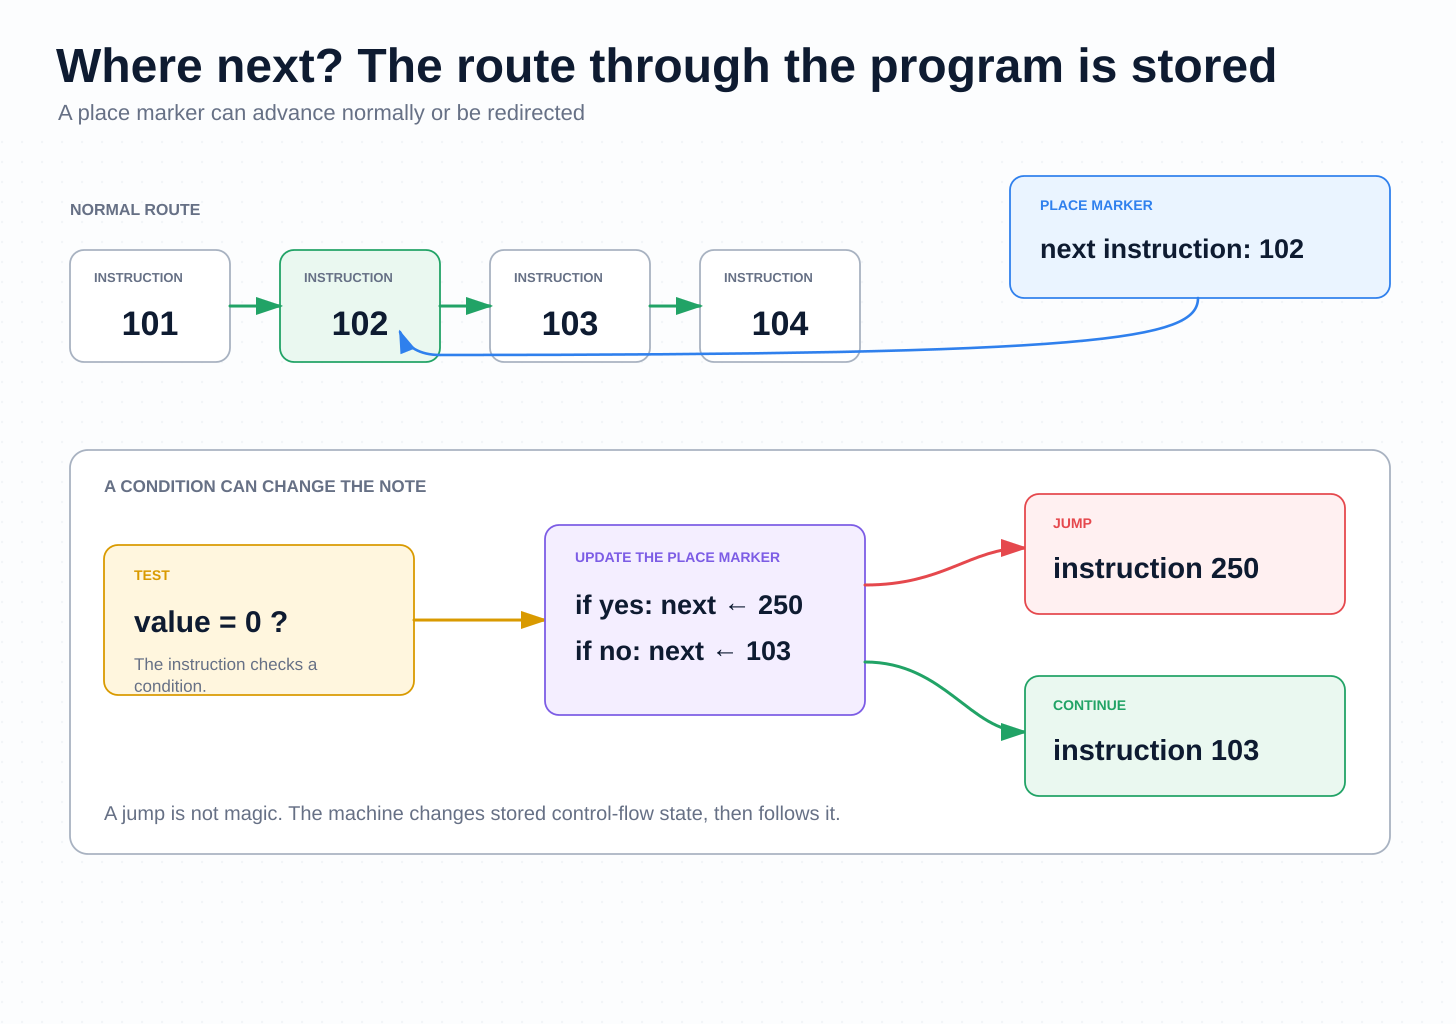
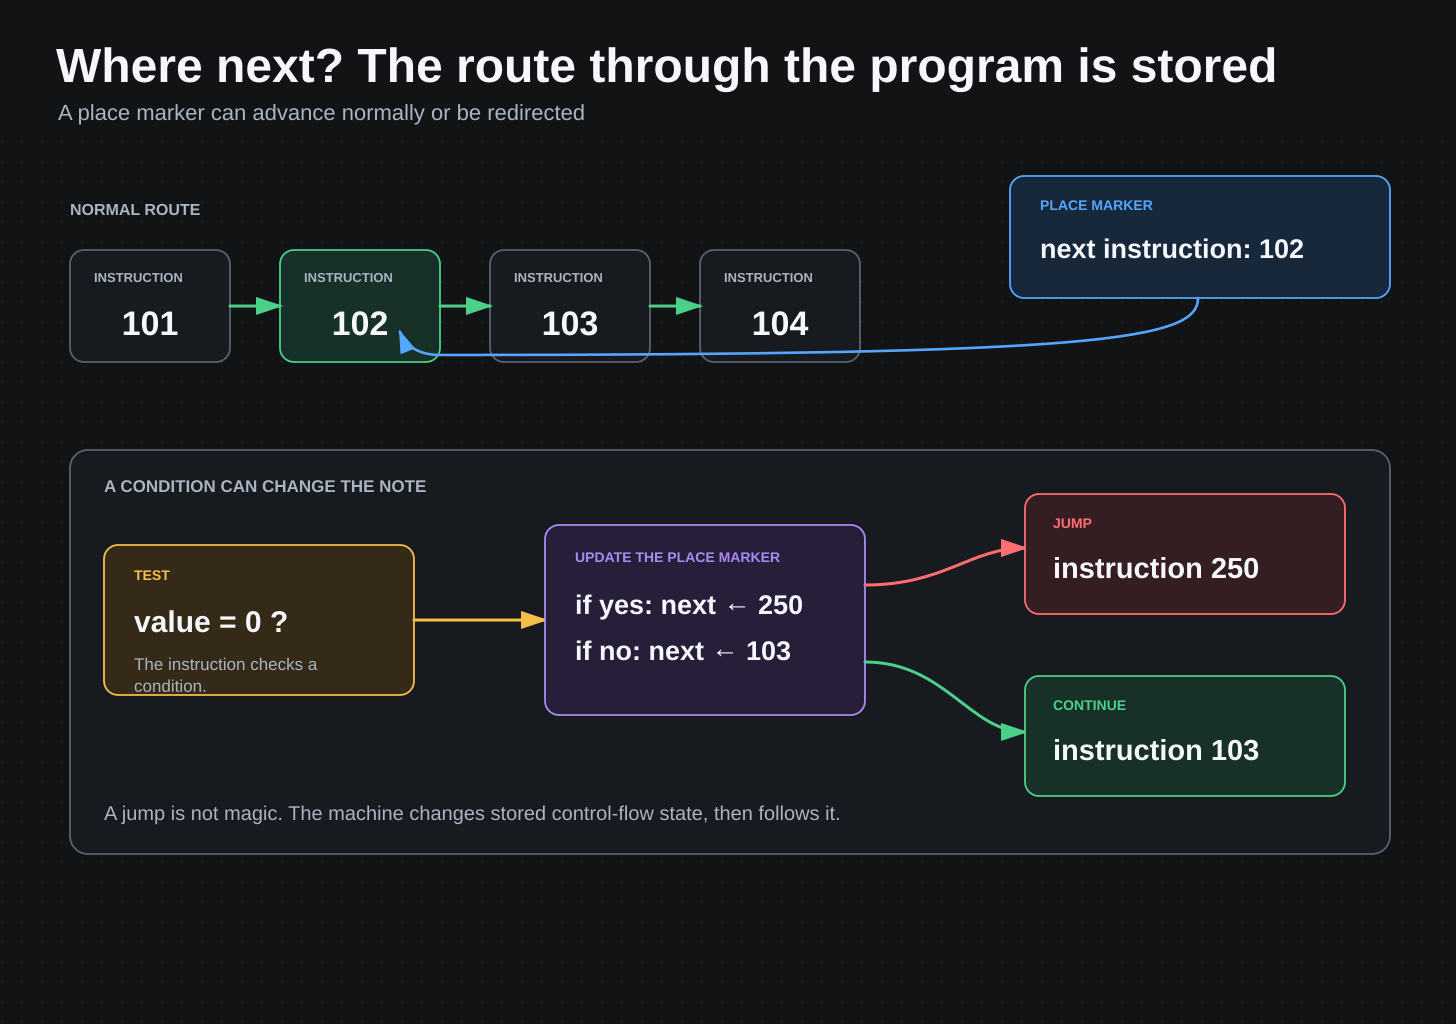
Ce qui est vraiment puissant, c’est que le système de classement peut décrire non seulement les données, mais aussi le chemin du travail. Quelque part, l’employé garde la trace de l’instruction qui doit venir ensuite. Dans l’architecture informatique moderne, ce petit morceau d’état s’appelle couramment le compteur de programme. Le nom peut sembler technique ; l’idée sous-jacente est presque comiquement simple. C’est la note de l’employé qui dit, en substance : « lis ensuite l’instruction 101 ».
Après l’instruction 101, la règle normale pourrait être de poursuivre avec 102, puis 103, puis 104. Mais une instruction peut aussi dire : ne continue pas avec la carte suivante ; va plutôt à l’instruction 250. C’est un saut. Un saut conditionnel ajoute un test : si cette valeur vaut zéro, va à 250 ; sinon, continue avec 102.
Rien de mystérieux ne s’est produit. La machine a changé l’emplacement stocké de la prochaine instruction. Pourtant, cette seule idée nous donne les branchements, les boucles, les nouvelles tentatives et une grande partie de la forme familière d’un programme. Une boucle n’est qu’un saut qui renvoie l’employé vers des instructions déjà parcourues jusqu’à ce qu’une condition change.
Cela vaut la peine de s’y attarder, car une grande quantité de jargon informatique se réduit alors à de la tenue de registre ordinaire. Le flux de contrôle de la machine est lui-même un état. La réponse à « que se passe-t-il ensuite ? » est représentée quelque part, et des instructions peuvent modifier cette réponse.
Un pointeur n’est qu’un emplacement noté quelque part
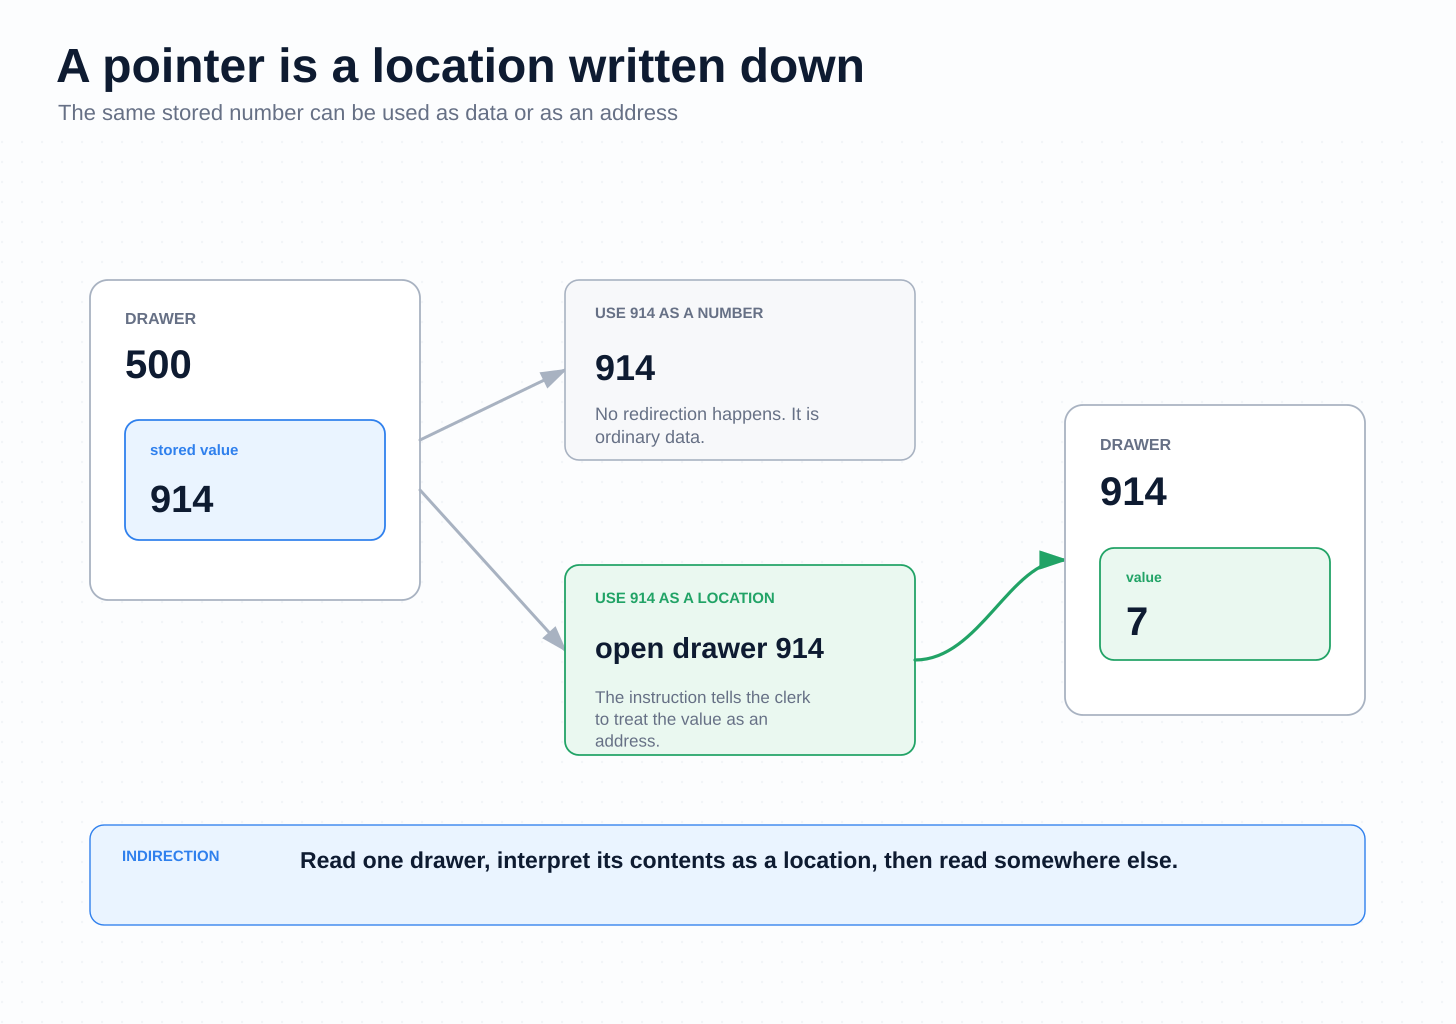
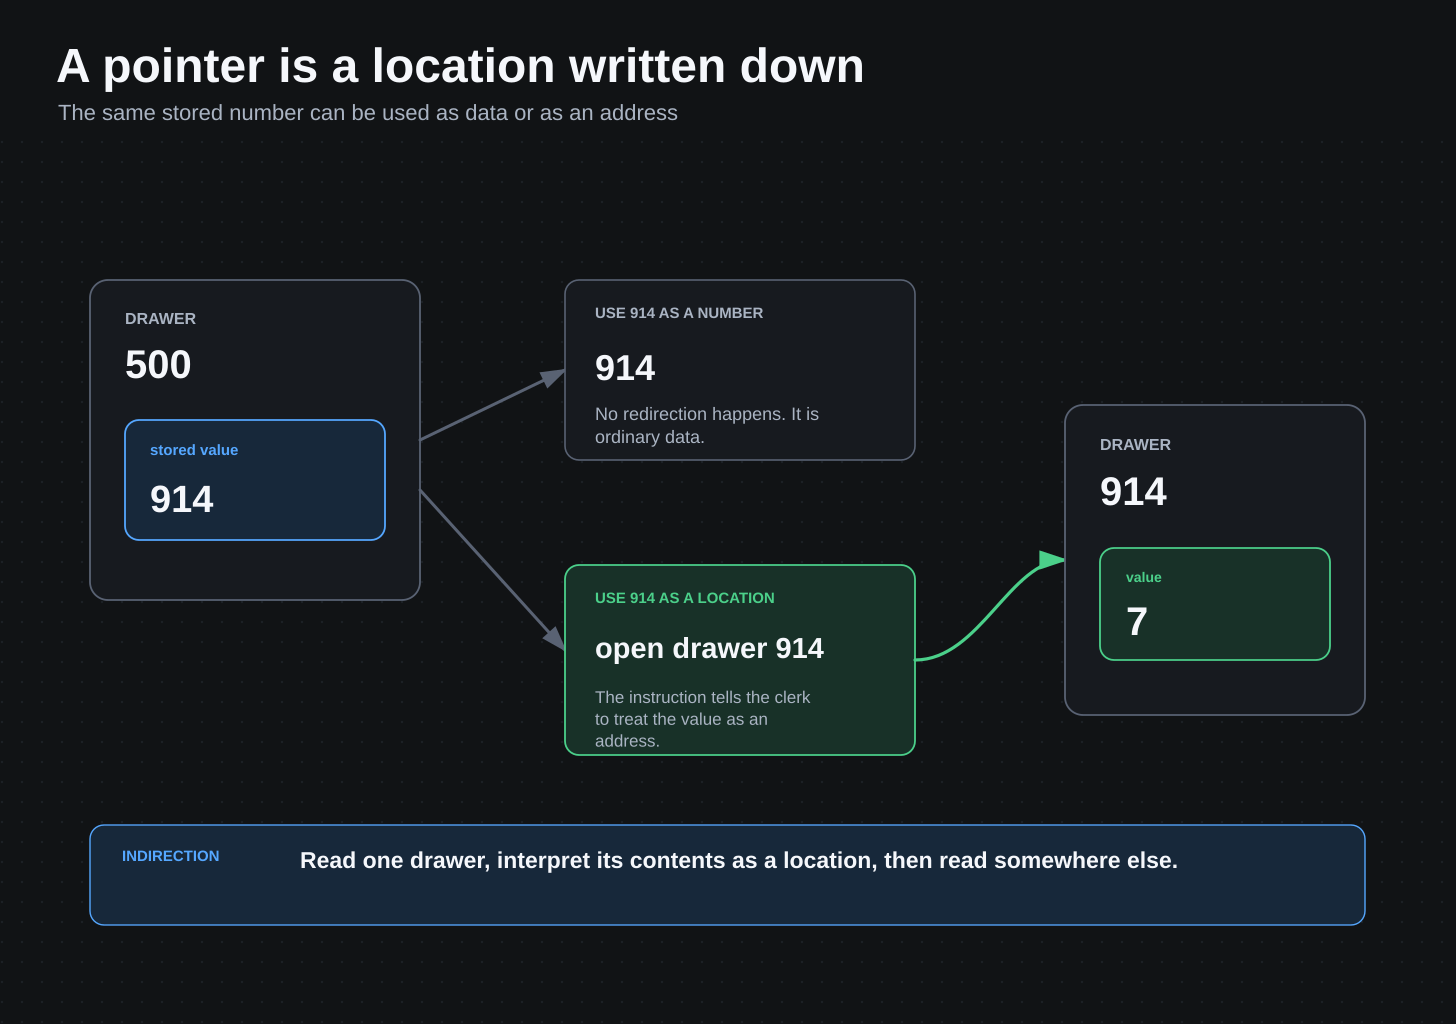
Les pointeurs s’expliquent avec le même système de classement. Supposons que le tiroir 500 contienne le nombre 914. Parfois, 914 n’est que le nombre neuf cent quatorze. Dans un autre contexte, il peut vouloir dire : ce que vous cherchez se trouve dans le tiroir 914. Lorsqu’un nombre est utilisé ainsi, il joue le rôle d’un pointeur, c’est-à-dire d’une adresse qui renvoie vers un autre emplacement (un autre tiroir).
Là encore, la puissance vient de l’interprétation. L’employé ne voit pas une flèche lumineuse flotter dans la mémoire. Il lit une valeur, l’instruction courante lui dit de traiter cette valeur comme un emplacement, puis l’opération suivante l’utilise pour choisir un autre tiroir. Un seul nombre stocké peut donc rediriger l’endroit où le travail suivant lira ou écrira.
C’est l’une des raisons pour lesquelles le modèle de l’employé de classement passe si bien à l’échelle. Des données peuvent désigner d’autres données. Des instructions peuvent rediriger vers d’autres instructions. Un petit ensemble d’opérations sur des emplacements peut construire des structures dont le comportement est bien plus riche que celui des opérations prises isolément.
Des instructions simples, un comportement immense
Lire un tiroir. Écrire dans un tiroir. Additionner deux valeurs. Les comparer. Utiliser une valeur comme emplacement d’une autre. Changer l’instruction qui viendra ensuite. Recommencer. Pris séparément, ces actes n’ont rien d’impressionnant.
Combinons-les dans un système de classement immense, à une vitesse extraordinaire, et ils peuvent mettre en œuvre des tableurs, des compilateurs, des jeux, des bases de données, des décodeurs d’images, des navigateurs web et des systèmes d’exploitation. L’employé de classement n’a pas besoin d’une faculté mystérieuse différente pour chaque application. Nous organisons les données et les instructions de sorte que la même mécanique élémentaire produise des comportements différents.
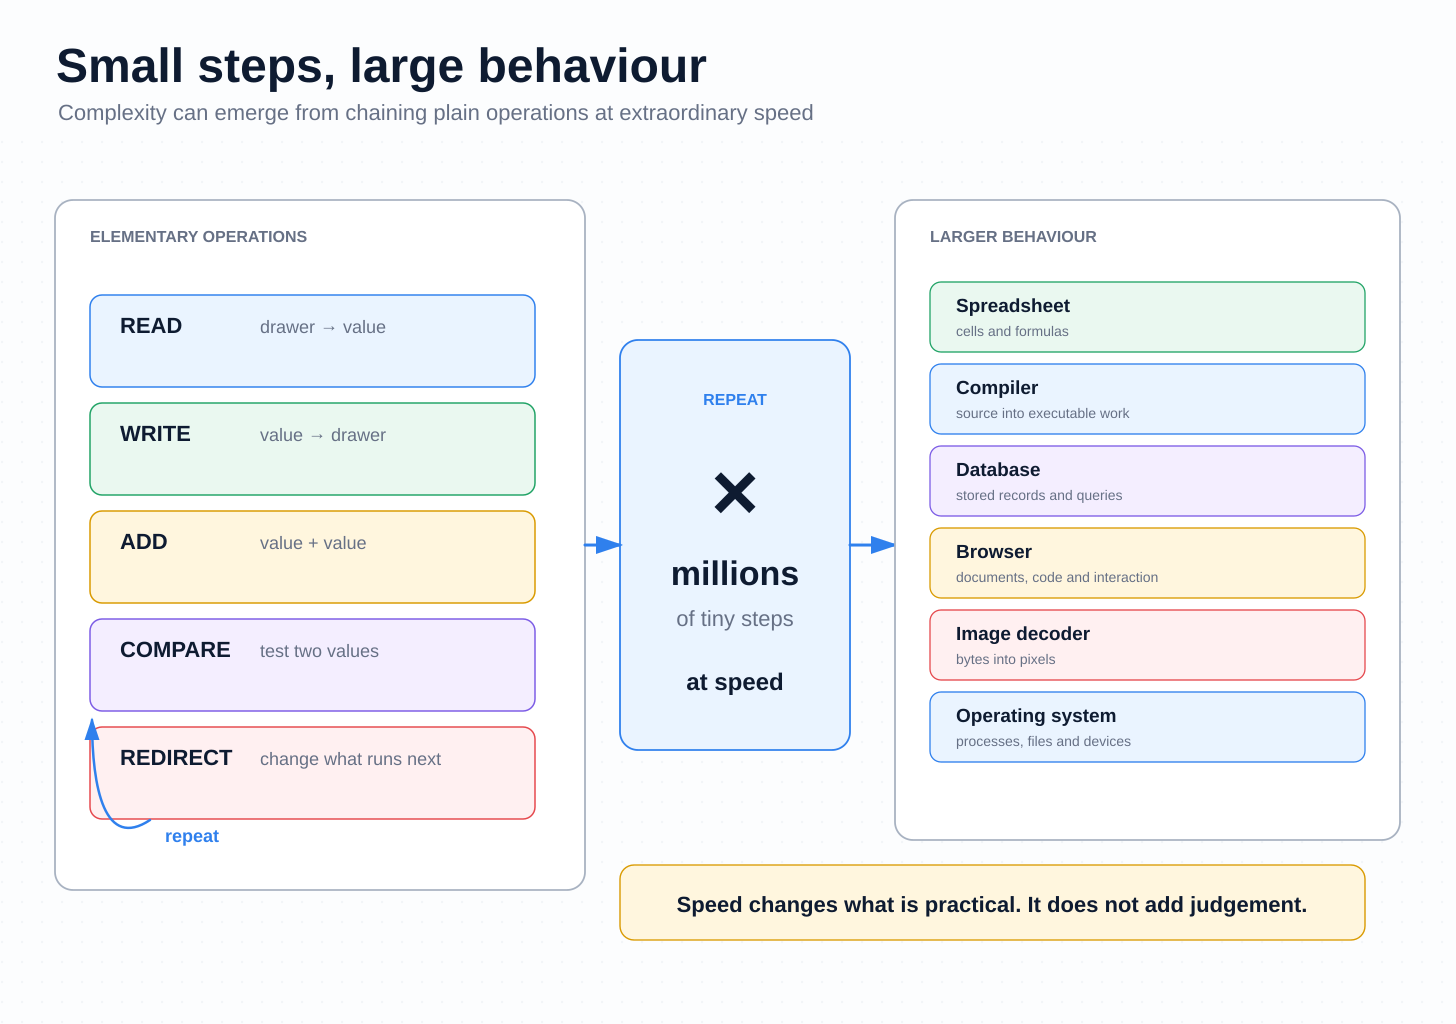
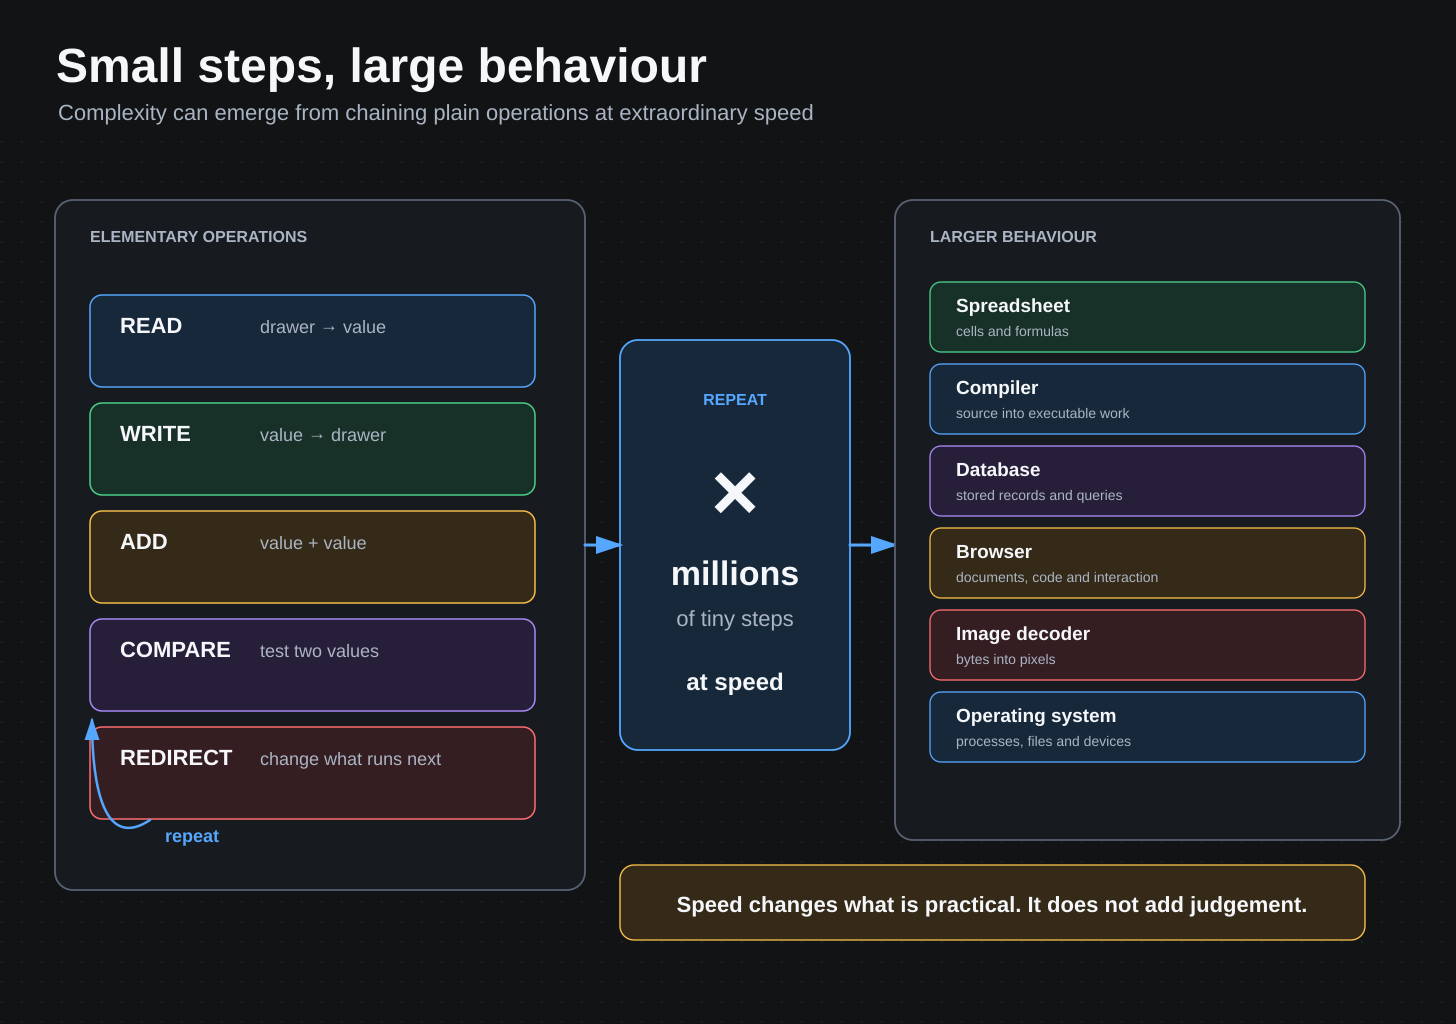
C’est là toute la force de l’explication. Elle ne rend pas les ordinateurs triviaux. Elle rend leur puissance plus impressionnante encore, précisément parce qu’elle est construite à partir d’ingrédients aussi ordinaires.
Quand l’employé commence à paraître intelligent
Feynman finit par pousser le modèle de l’employé de classement vers une question plus difficile : une machine peut-elle penser ? Dans son raisonnement, la difficulté n’est pas qu’un ordinateur serait incapable d’exécuter une procédure de pensée. C’est que la pensée humaine ne nous est pas donnée sous la forme d’une procédure connue et parfaitement définie que nous pourrions simplement remettre à l’employé.
Avant d’en venir aux échecs, Feynman donne une version plus simple de la même idée avec l’arithmétique. La machine n’essaie pas d’imiter l’expérience d’un mathématicien en train de calculer. Elle utilise un mécanisme différent, bien mieux adapté à l’arithmétique routinière.
« Elles font de l’arithmétique mieux que n’importe qui, beaucoup plus vite, et autrement. … nous n’allons jamais changer leur manière de faire de l’arithmétique pour qu’elle ressemble à celle des humains, ce serait revenir en arrière. Parce que l’arithmétique faite par les humains est lente, laborieuse, confuse et pleine d’erreurs. »
La cible de Feynman, ici, est l’arithmétique, pas l’intelligence humaine en général. Son propos porte sur l’exécution : pour l’arithmétique routinière, la méthode différente de l’ordinateur est un avantage. Lui faire imiter une procédure humaine uniquement pour paraître humain reviendrait à jeter cet avantage.
Cela prépare la question plus difficile. Si une machine n’a pas besoin de faire l’arithmétique à la manière humaine, le comportement intelligent doit-il, lui aussi, être produit par la voie humaine ?
Les échecs rendent la difficulté concrète. Un bon joueur humain ne semble pas énumérer des millions de positions. Il remarque des structures : une fourchette, une case vulnérable, une forme familière, une variante prometteuse. Feynman attire l’attention sur l’écart entre le fait de dire qu’une personne voit un motif et le fait de connaître réellement la procédure mécanique par laquelle ce motif utile a été repéré au départ.
Un ordinateur peut aborder le même problème autrement. Il peut examiner beaucoup plus de positions qu’une personne, appliquer des règles et des évaluations explicites, et utiliser des heuristiques pour éviter de consacrer le même effort partout. Il n’a pas besoin de recréer le chemin intérieur par lequel un expert humain est arrivé au même coup.
Feynman formule magnifiquement la distinction : « Nous ne pouvons pas le faire jouer comme joue un humain, mais nous pouvons le faire jouer mieux que presque tous les humains. » (c’est nous qui soulignons)
Cette phrase porte une idée d’ingénierie plus large. Elle sépare la ressemblance de l’utilité. Une machine n’a pas besoin de reproduire le chemin humain pour produire un résultat que nous reconnaissons comme intelligent. Ce qui compte, c’est la procédure qu’elle exécute réellement, les motifs ou régularités qu’elle peut exploiter, la manière dont elle recherche ou sélectionne parmi les possibilités, et l’endroit où sa compétence s’arrête.
Le modèle de l’employé de classement survit donc au saut apparent vers l’intelligence. Le résultat peut sembler remarquablement intelligent alors que la machine sous-jacente continue de manipuler des représentations, de comparer des possibilités et de parcourir des états selon des opérations définies. Le mystère n’a pas migré dans le matériel. Il s’est déplacé vers la manière dont une structure utile est représentée, la façon dont la procédure la trouve, et tout ce qui peut émerger du calcul sans exiger que la machine pense comme une personne.
La dernière partie de la conférence va bien plus loin que cet article sur les machines pensantes, l’intelligence, les heuristiques et leurs limites. Pourtant, la phrase de conclusion de Feynman mérite de survivre à ce resserrement : « Je pense que nous nous approchons des machines intelligentes, mais elles font apparaître les faiblesses nécessaires de l’intelligence. »
Il est difficile de ne pas l’entendre autrement aujourd’hui. Cette phrase laisse place à une machine réellement utile, voire remarquablement capable, sans exiger qu’elle soit parfaite. Une faiblesse n’annule pas automatiquement l’intelligence ; elle nous dit que l’intelligence elle-même peut avoir des limites, des angles morts et des modes de défaillance caractéristiques. Pour l’ingénierie, c’est un point de départ bien plus utile que de prétendre qu’une intelligence artificielle utile doit d’abord devenir infaillible.
L’employé prend les instructions au pied de la lettre
Cette même intelligence a un tranchant : l’employé qui la sous-tend reste, lui, littéral. Il suit la procédure qui existe réellement, avec l’état qui est réellement présent. Il ne corrige pas notre intention.
Si une instruction pointe vers le mauvais tiroir, l’employé ne sait pas miraculeusement quel tiroir nous voulions indiquer. Si le tiroir 500 contient 915 alors que nous attendions 914, un pointeur ultérieur peut mener ailleurs. Si une condition de saut a été mal écrite, l’employé peut suivre parfaitement la mauvaise branche. Si une partie du système interprète une valeur comme une taille et qu’une autre lui donne un autre sens, l’employé ne s’arrête pas parce que le désaccord paraît suspect.
Lorsque nous disons que l’employé est « confus », nous ne voulons pas dire que l’ordinateur éprouve la confusion humaine. Nous voulons dire que l’état, la représentation ou la procédure ne correspond plus au modèle que le concepteur pensait imposer. La machine peut rester parfaitement obéissante tandis que le système devient incorrect.
Les systèmes réels peuvent aussi avoir plusieurs employés travaillant avec les mêmes tiroirs. L’un peut lire une valeur pendant qu’un autre la modifie, l’efface ou réaffecte le tiroir à autre chose. Le premier peut ensuite continuer à utiliser une ancienne valeur, ou même suivre une note vers un tiroir qui ne correspond plus à ce qu’il croyait. Dès que plusieurs employés peuvent atteindre les mêmes tiroirs, qui peut les lire ou les modifier, et à quel moment, fait partie de la correction de la procédure.
C’est là que l’ingénierie commence à devenir intéressante
Beaucoup de défaillances logicielles difficiles peuvent se ramener à une variante de ce problème. Le mauvais emplacement a été suivi. Une décision a été prise avec une représentation et une action exécutée avec une autre. Une valeur a été vérifiée puis a changé avant son utilisation. Un enregistrement périmé a été traité comme actuel. Un chemin de repli a envoyé le travail par une autre route. Une étape ultérieure a fait confiance à un sens qu’une étape précédente n’avait jamais établi.
Vues de l’extérieur, ces défaillances peuvent concerner des logiciels sophistiqués. Vues de l’intérieur vers l’extérieur, les questions sont souvent merveilleusement concrètes. Quelle valeur l’employé a-t-il lue ? Quel tiroir cette valeur désignait-elle ? Quelle instruction s’est exécutée ensuite ? Quelle condition a provoqué le saut ? Quel état l’instruction suivante croyait-elle avoir reçu ?
C’est une habitude d’ingénierie qui nous importe. Lorsqu’une affirmation au niveau du système devient vague, il faut descendre jusqu’à ce que le mécanisme redevienne littéral.
Et c’est là que la sécurité entre en jeu
Un bug ordinaire peut désorienter l’employé par accident. Un problème de sécurité devient possible lorsque quelqu’un peut influencer délibérément l’état ou les instructions de manière à conduire la machine vers une conséquence utile.
Un attaquant n’a pas besoin que l’ordinateur devienne désobéissant. Bien au contraire. Certaines des défaillances les plus intéressantes se produisent parce que l’ordinateur obéit trop fidèlement : il suit le pointeur influencé par l’attaquant, accepte la représentation trompeuse, prend le saut autorisé, exécute l’opération permise ou transmet une valeur au composant suivant exactement comme la procédure le prévoit.
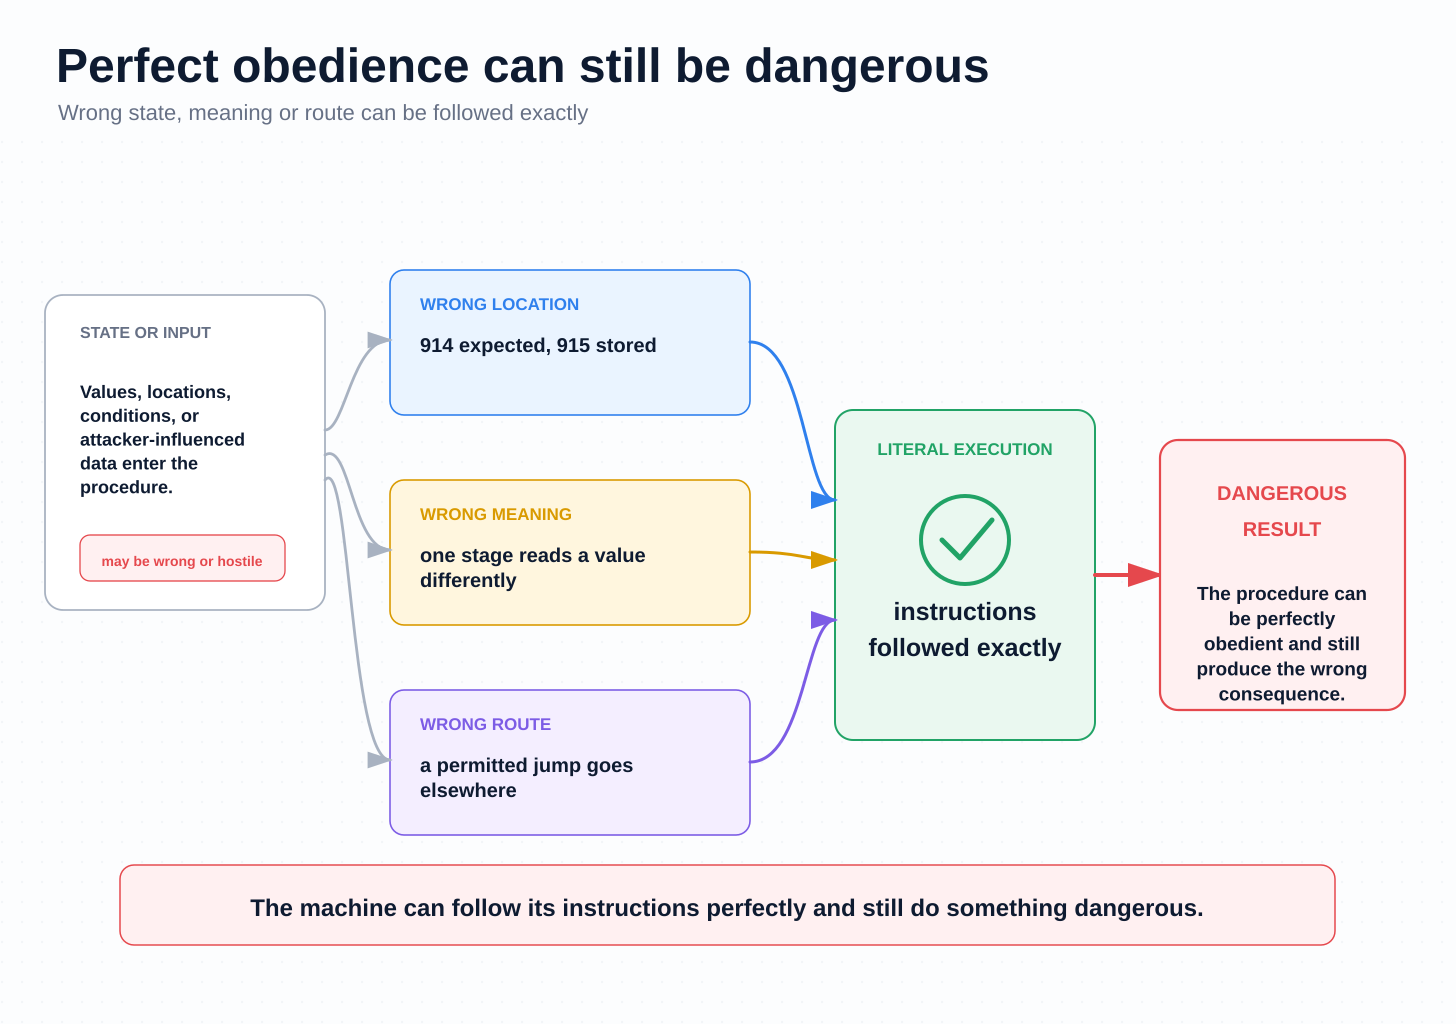
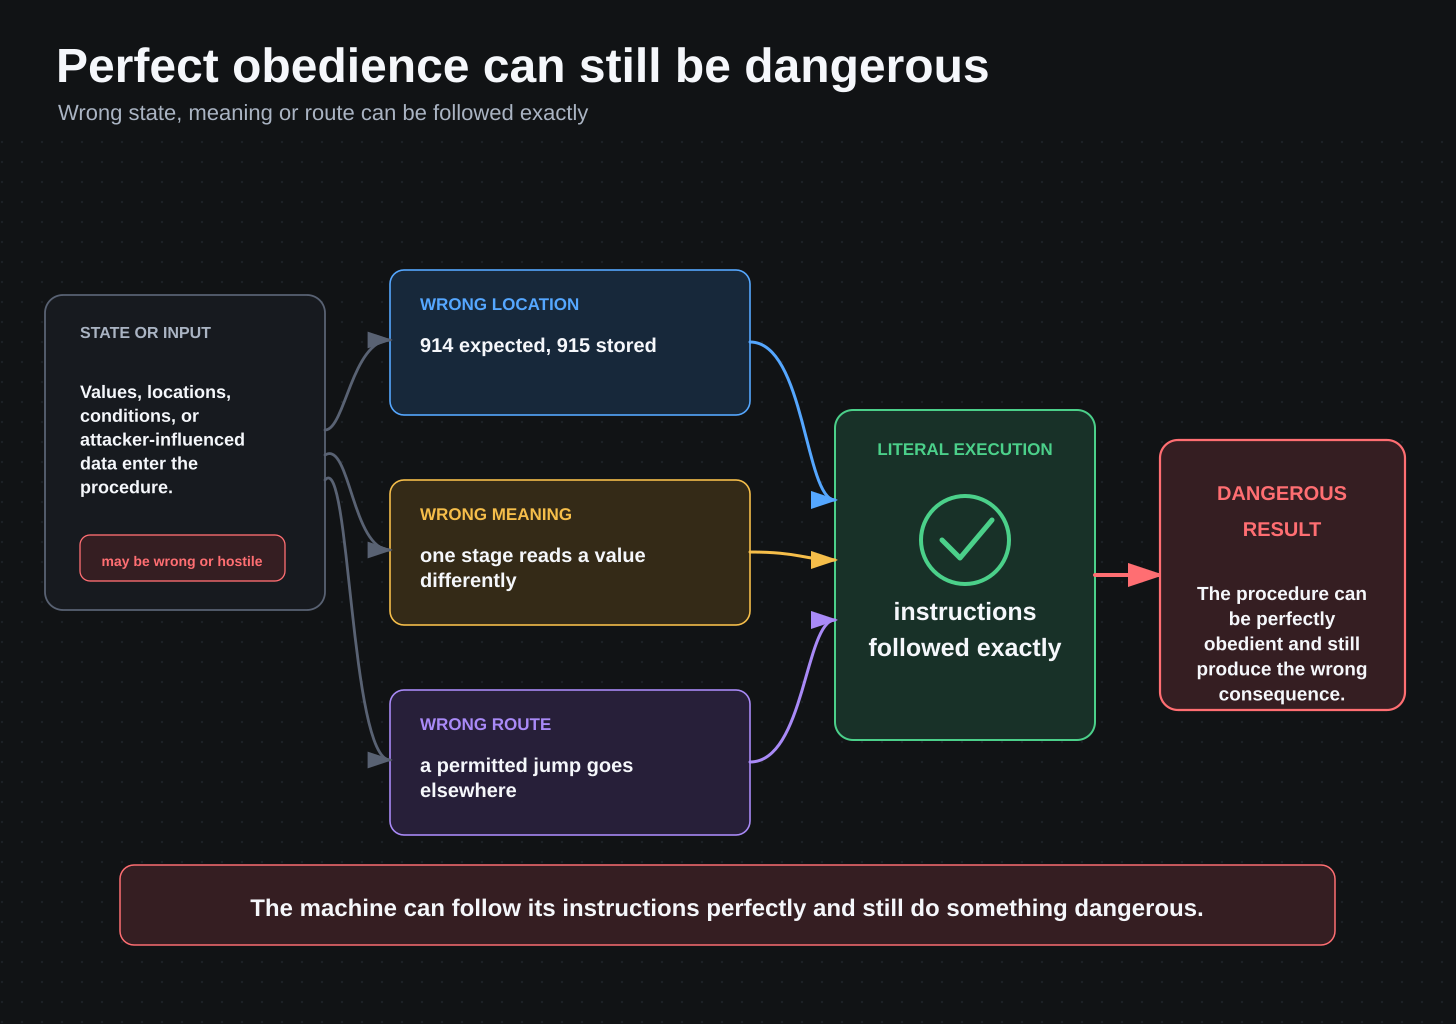
La conséquence dépend alors de ce que l’employé a le droit de faire. Une confusion dans une zone de travail jetable peut être sans effet. La même confusion à proximité d’identifiants d’accès, d’un état durable, de données privées, d’un accès réseau ou d’un autre composant privilégié peut avoir une importance considérable.
Nous reviendrons ailleurs sur ces distinctions. Cet article n’a pas pour but de les devancer. Il vise à nous donner un modèle mental commun : avant de discuter du nom d’une propriété de sécurité, demandons quelles informations existent, ce qu’elles signifient, où elles pointent, quelle instruction s’exécute ensuite et quels pouvoirs sont accessibles à partir de là.
Un modèle que nous comptons réutiliser
Nous pensons que l’employé de classement reviendra souvent dans les écrits de XMAKYNA, parce qu’il rend des idées difficiles accessibles sans les infantiliser. Un pointeur devient un emplacement noté. Un saut devient une modification de la note « instruction suivante ». Le compteur de programme devient le marque-page de l’employé. La mémoire devient des tiroirs. L’exécution devient une suite de petites opérations sur ces tiroirs.
Une fois cette image en place, les arguments plus avancés ont un sol ferme sur lequel se poser. Nous pouvons parler d’état erroné, d’état périmé, de représentation trompeuse, de redirection, d’autorité et de confusion contrôlée par un attaquant sans prétendre que l’ordinateur possède un jugement humain ni que le nom de l’abstraction explique à lui seul le mécanisme.
Ce modèle est utile lorsque l’ingénierie difficile commence à paraître plus mystérieuse qu’elle ne l’est. Retirez l’échelle et l’étrangeté, et il reste encore, en un sens, un meuble à dossiers : si l’état, la représentation et la procédure sont corrects, la machine effectuera le travail.
Voilà pourquoi cette conférence est plus qu’une charmante vieille explication des ordinateurs. Elle nous donne une manière durable de penser.
Métadonnées de la conférence et note sur le titre
Intervenant : Richard P. Feynman. L’enregistrement lié affiche lui-même la date du 26 septembre 1985 et indique comme cadre l’atelier Idiosyncratic Thinking à l’Esalen Institute, Big Sur, Californie.
La conférence a circulé sous différents titres, et certaines références publiées datent différemment des documents connexes d’Esalen. La vidéo liée est intitulée Hardware, Software and Heuristics ; Computers From the Inside Out et The Feynman Lecture on Heuristics apparaissent aussi ailleurs. Ici, nous désignons la conférence sous le titre Computers From the Inside Out.
Voir la conférence : Richard Feynman, Computers From the Inside Out (YouTube).
En bref
Si l’on dépouille suffisamment un ordinateur, il reste une image étonnamment durable : un employé de classement très rapide et très littéral, avec un ensemble effectivement immense de tiroirs numérotés et un petit répertoire d’opérations. Des valeurs peuvent désigner d’autres tiroirs. Des instructions peuvent changer l’instruction suivante. Le compteur de programme est simplement le marque-place de l’employé. Un saut change ce marque-place. Un comportement immense émerge de la répétition de ces gestes simples à une vitesse extraordinaire.
Le modèle est simple, mais pas superficiel. Il nous rappelle que la machine agit sur l’état et la représentation que nous avons réellement encodés, pas sur l’intention dont nous espérions qu’elle serait comprise d’elle-même. Un employé confus est un problème de correction. Un employé qu’un attaquant peut délibérément désorienter, avec une autorité utile à portée, devient un problème de sécurité. Nous comptons revenir souvent à cette idée.