
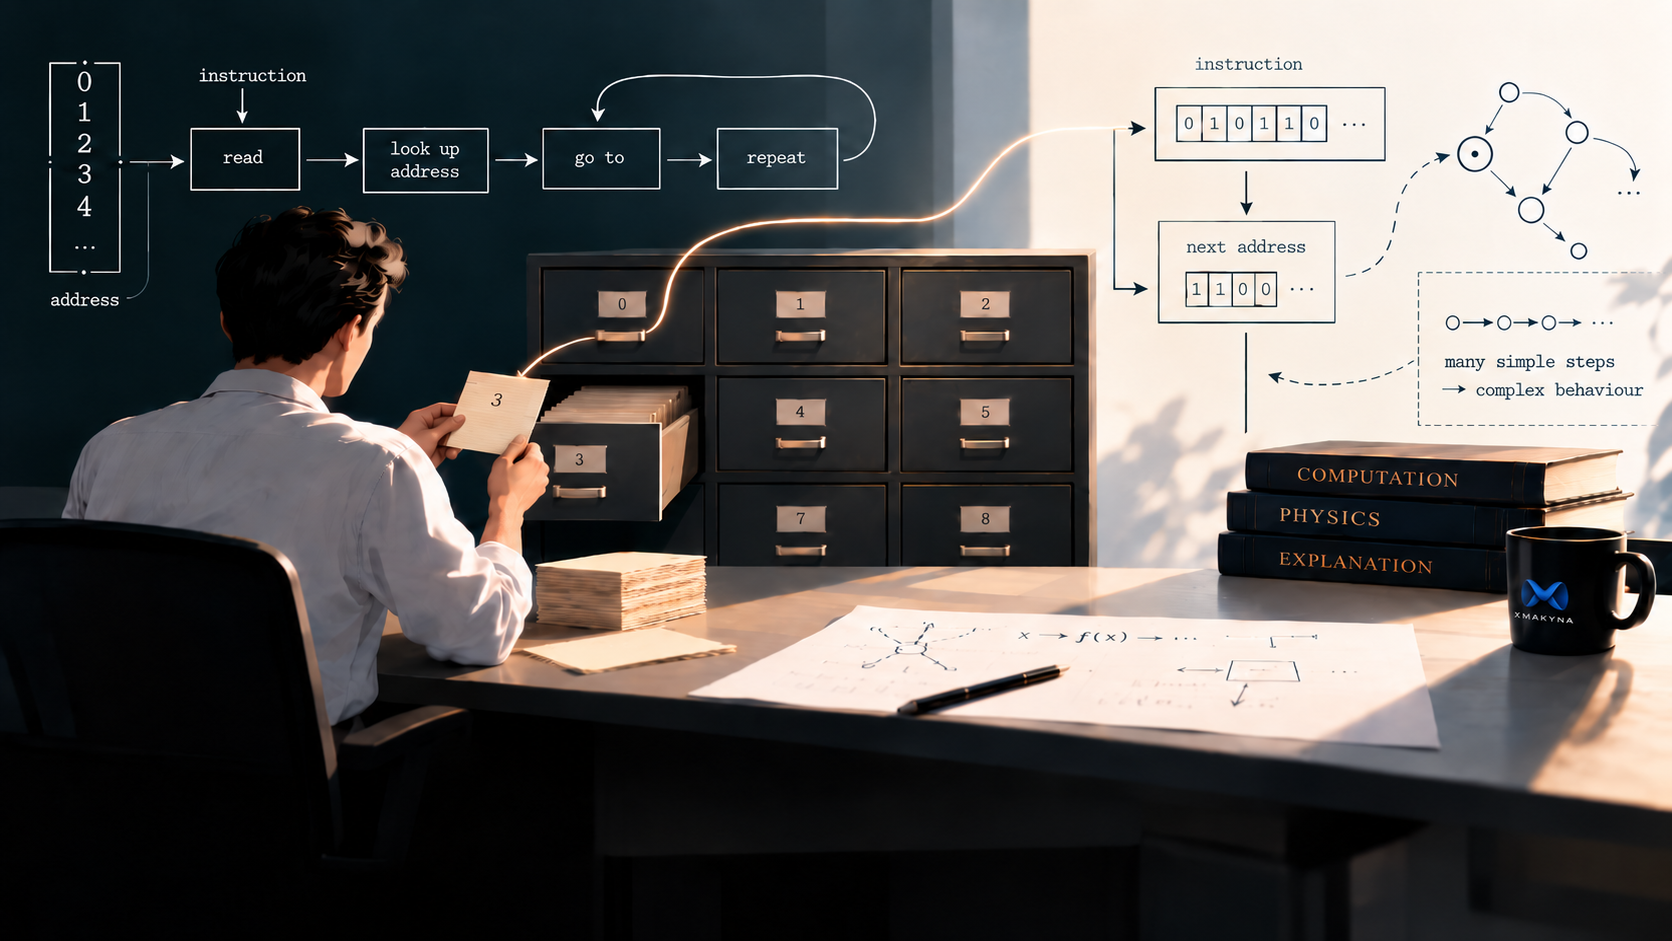
Richard Feynman ist eine wissenschaftliche Legende, aber das allein ist nicht der Grund, warum wir XMAKYNAs technischen Blog mit diesem Vortrag eröffnen. Wir beginnen hier, weil ein großer Teil der Technik, die uns wichtig ist, am Ende auf sehr einfache Fragen hinausläuft: Was hat die Maschine gelesen? Was hat sie gespeichert? Was hat sie als Nächstes getan? Und was durfte sie beeinflussen? Feynmans Modell des Ablageangestellten gibt uns eine gemeinsame Sprache für diese Fragen. Spätere Beiträge können auf dieser Grundlage aufbauen, statt sie jedes Mal von Neuem zu erklären.
Mehr als vierzig Jahre später (das Seminar wurde 1985 aufgezeichnet) wirkt der Vortrag noch immer erstaunlich frisch. Fast jeder, der sich für Computer interessiert, kann etwas daraus mitnehmen, weil Feynman nicht mit Fachjargon beginnt. Er gibt uns einen Angestellten, nummerierte Schubladen, einfache Anweisungen, einen Zettel, der sagt, wo es als Nächstes weitergeht, und Werte, die auf andere Schubladen verweisen können. Aus diesen Zutaten wird die grundlegende Funktionsweise eines Computers sichtbar.
Weder der Vortrag noch dieser Artikel erklären alles über Computer. Sie erklären jedoch einen nützlichen Kern: Informationen werden irgendwo gespeichert, Anweisungen bestimmen, was als Nächstes geschieht, gespeicherte Werte können die Maschine an eine andere Stelle lenken, und einfache Operationen können sich zu sehr viel komplexerem Verhalten verbinden.
Das ist auch für Sicherheit wichtig. Viele ernste Fehler werden deutlich weniger rätselhaft, wenn man sie auf dieses Bild zurückführt. Die Maschine kann am falschen Ort lesen, dem falschen nächsten Schritt folgen, einem Wert vertrauen, der für einen anderen Teil etwas anderes bedeutet, oder gezielt von jemandem gesteuert werden, der beeinflussen kann, was in einer Schublade liegt oder wo der Angestellte als Nächstes nachsieht.
Die Maschine kann ihre Anweisungen vollkommen befolgen und trotzdem etwas Gefährliches tun. Das zu verstehen ist eine der Grundlagen, auf die wir immer wieder zurückgreifen werden.
Der Vortrag klingt heute anders, weil wir mit großen Sprachmodellen (LLMs) und anderen Systemen leben, deren Ausgaben erstaunlich leistungsfähig wirken können. Feynman erklärte keine moderne KI, und dieser Artikel wird auch nicht so tun, als hätte er das getan. Sein Vortrag gibt uns etwas Grundsätzlicheres: eine Möglichkeit, hinter beeindruckende Ausgaben zu schauen und zu fragen, was die Maschine tatsächlich tut, wie sie dort hingelangt ist, was sie falsch machen kann und was geschieht, wenn solche Fehler Folgen haben. Für uns ist das beim Einsatz von KI ein zentrales technisches Anliegen: Code, der sich bauen lässt (kompiliert), läuft und plausibel aussieht, reicht nicht; wir müssen weiterhin feststellen, dass er korrekt ist.
Dieser Beitrag beginnt deshalb ganz bewusst bei den Grundlagen. Er folgt Feynmans einfachen Metaphern weit genug, damit auch Nichtfachleute ein belastbares Bild davon bekommen, wie ein Computer Informationen findet, Anweisungen befolgt, die Richtung ändert und aus einfachen Schritten komplexes Verhalten erzeugt. Dieses Bild werden wir später immer wieder brauchen.
Mit einem Angestellten und einigen Schubladen anfangen
Stellen wir uns einen Angestellten in einem Raum voller nummerierter Schubladen vor. Jede Schublade kann eine Zahl oder eine andere einfache Information enthalten. Der Angestellte kann eine Schublade öffnen, ihren Inhalt lesen, einen Wert kopieren, an einer anderen Stelle einen neuen Wert schreiben, zwei Werte vergleichen und einer Anweisung folgen, die sagt, was als Nächstes zu tun ist.
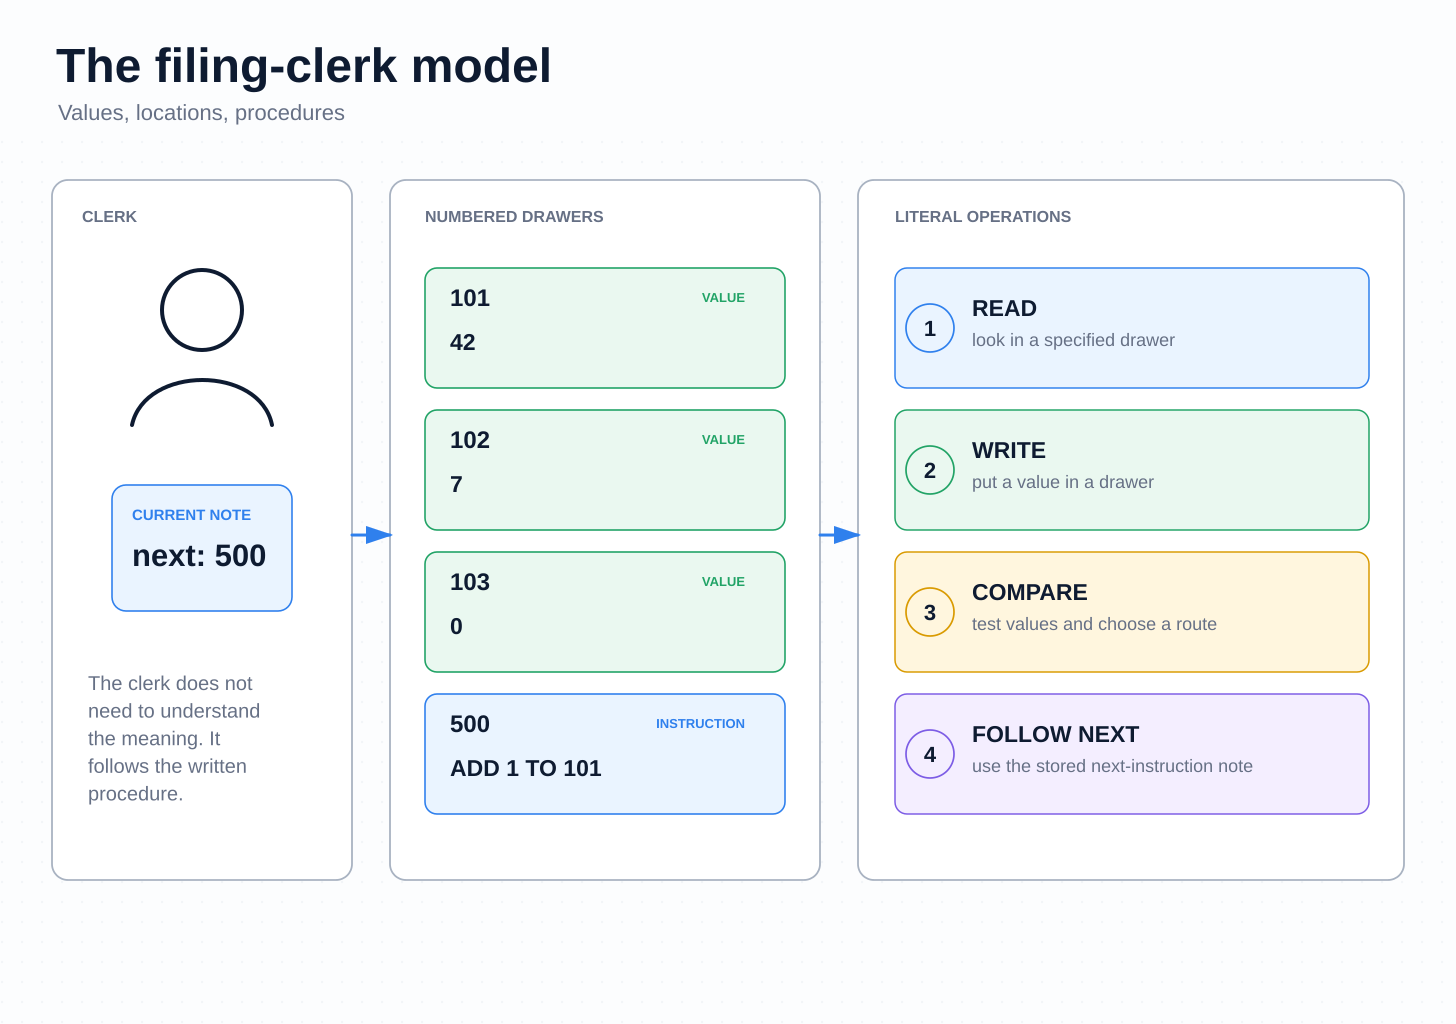
Das ist absichtlich unspektakulär. Der Angestellte muss nicht wissen, ob eine Zahl Geld, eine Farbe, einen Buchstaben, eine Temperatur, eine Position auf einem Schachbrett oder die Adresse einer anderen Schublade darstellt. Bedeutung entsteht durch die Darstellung, die wir festlegen. Für den Angestellten gibt es Werte, Orte und Abläufe.
Das ist eine der nützlichsten Arten, einen Computer zu entmystifizieren. Von außen kann eine Maschine erstaunliches Verhalten zeigen und trotzdem aus Operationen bestehen, die einzeln fast peinlich einfach sind. Die Raffinesse liegt in der Organisation: was gespeichert wird, wie es dargestellt wird, welche Anweisung als Nächstes läuft und wie viele solcher Operationen sich aneinanderreihen lassen.
Auch der Weg durch das Programm ist gespeichert
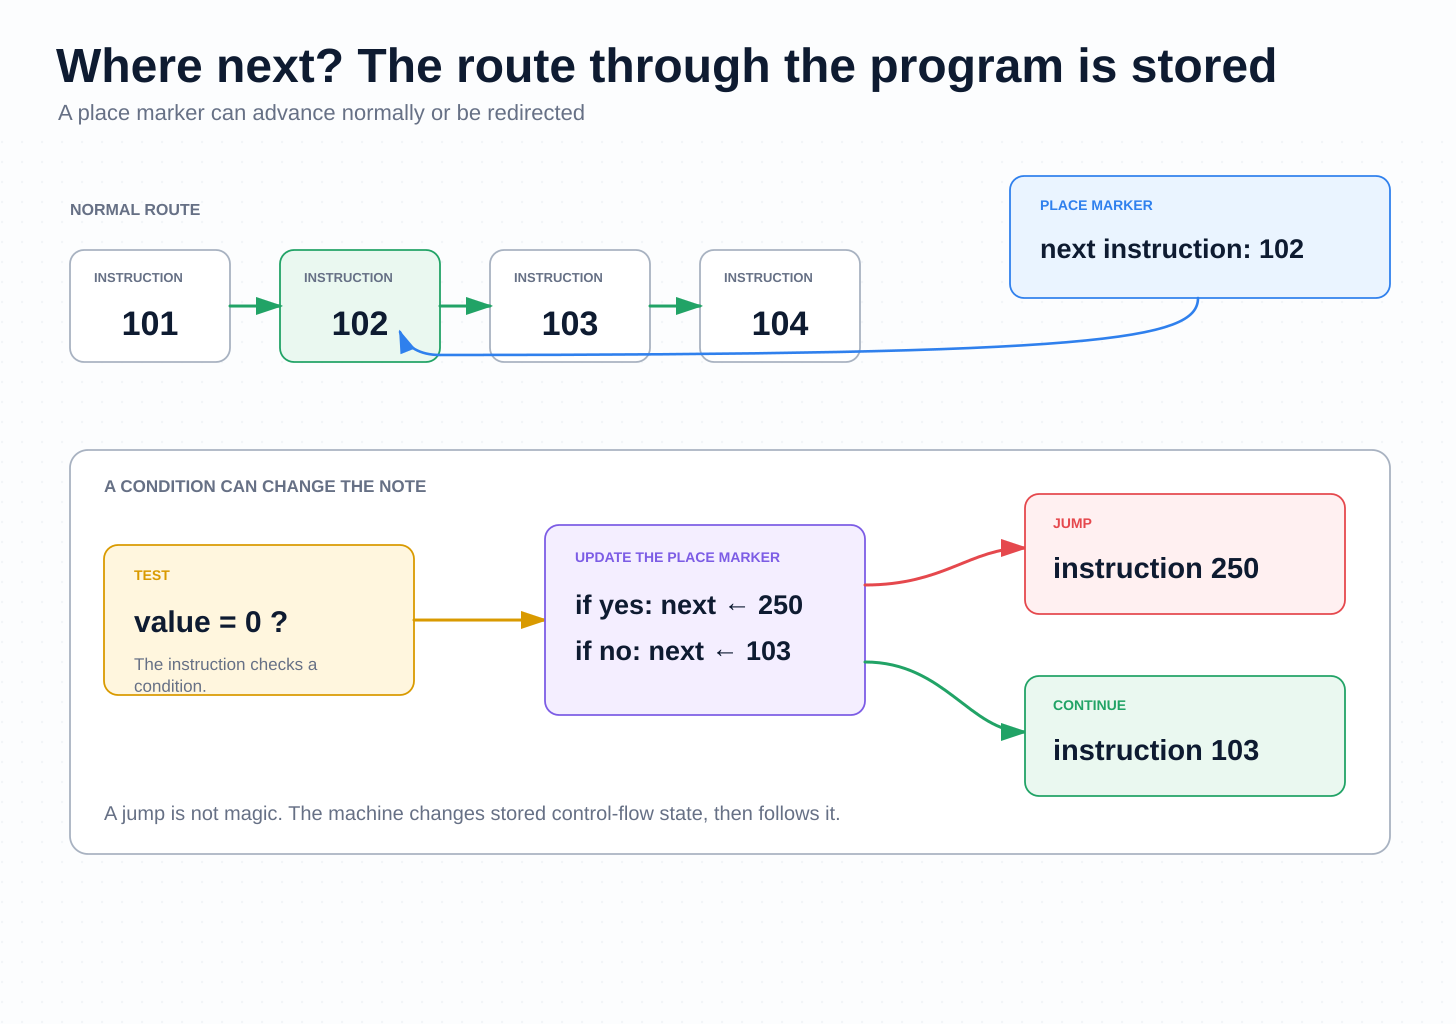
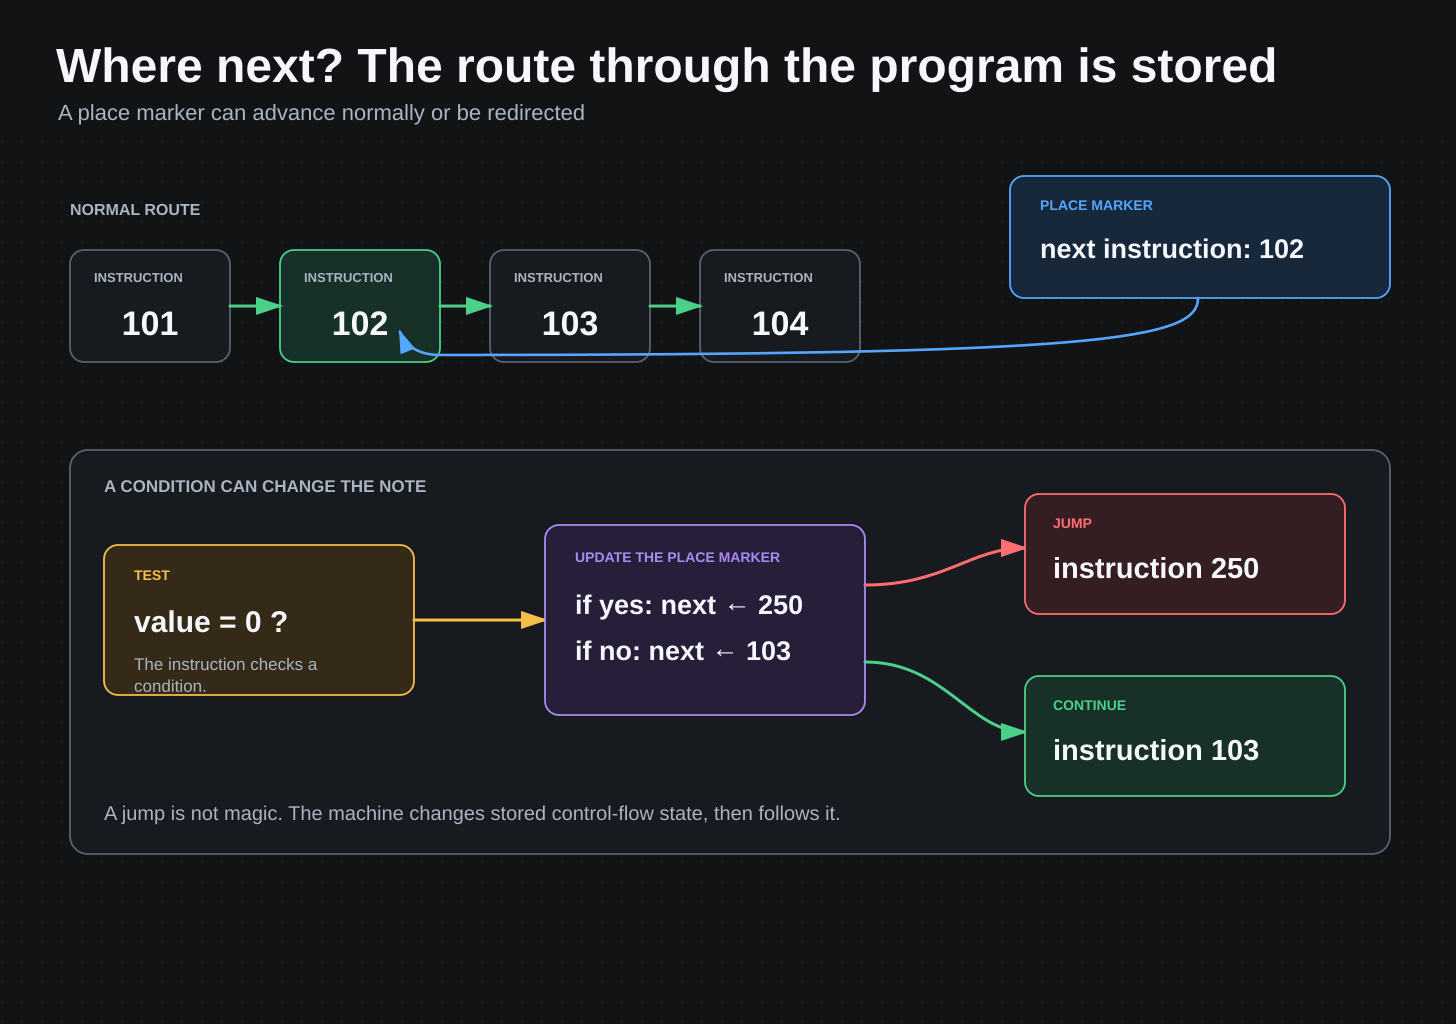
Der wirklich starke Teil ist, dass das Ablagesystem nicht nur die Daten beschreiben kann, sondern auch den Weg durch die Arbeit. Irgendwo hält der Angestellte fest, welche Anweisung als Nächstes kommt. In moderner Rechnerarchitektur heißt dieses kleine Stück Zustand gewöhnlich Programmzähler. Der Name klingt technisch; die Grundidee ist beinahe komisch einfach. Es ist der Zettel des Angestellten, auf dem sinngemäß steht: „Lies als Nächstes Anweisung 101.“
Nach Anweisung 101 könnte die normale Regel lauten, mit 102, dann 103 und dann 104 weiterzumachen. Eine Anweisung kann aber auch sagen: Geh nicht zur nächsten Karte; spring stattdessen zu Anweisung 250. Das ist ein Sprung. Ein bedingter Sprung fügt einen Test hinzu: Wenn dieser Wert null ist, geh zu 250; sonst mach mit 102 weiter.
Nichts Mystisches ist passiert. Die Maschine hat den gespeicherten Ort der nächsten Anweisung geändert. Aus genau dieser Idee entstehen dennoch Verzweigungen, Schleifen, Wiederholungsversuche und ein großer Teil der vertrauten Form eines Programms. Eine Schleife ist schlicht ein Sprung, der den Angestellten zu bereits besuchten Anweisungen zurückschickt, bis sich eine Bedingung ändert.
Es lohnt sich, dabei zu verweilen, denn ein großer Teil des Computerjargons wird damit zu gewöhnlicher Buchführung. Der Kontrollfluss der Maschine ist selbst Zustand. Die Antwort auf die Frage „Was passiert als Nächstes?“ ist irgendwo dargestellt, und Anweisungen können diese Antwort verändern.
Ein Zeiger ist nur ein notierter Ort
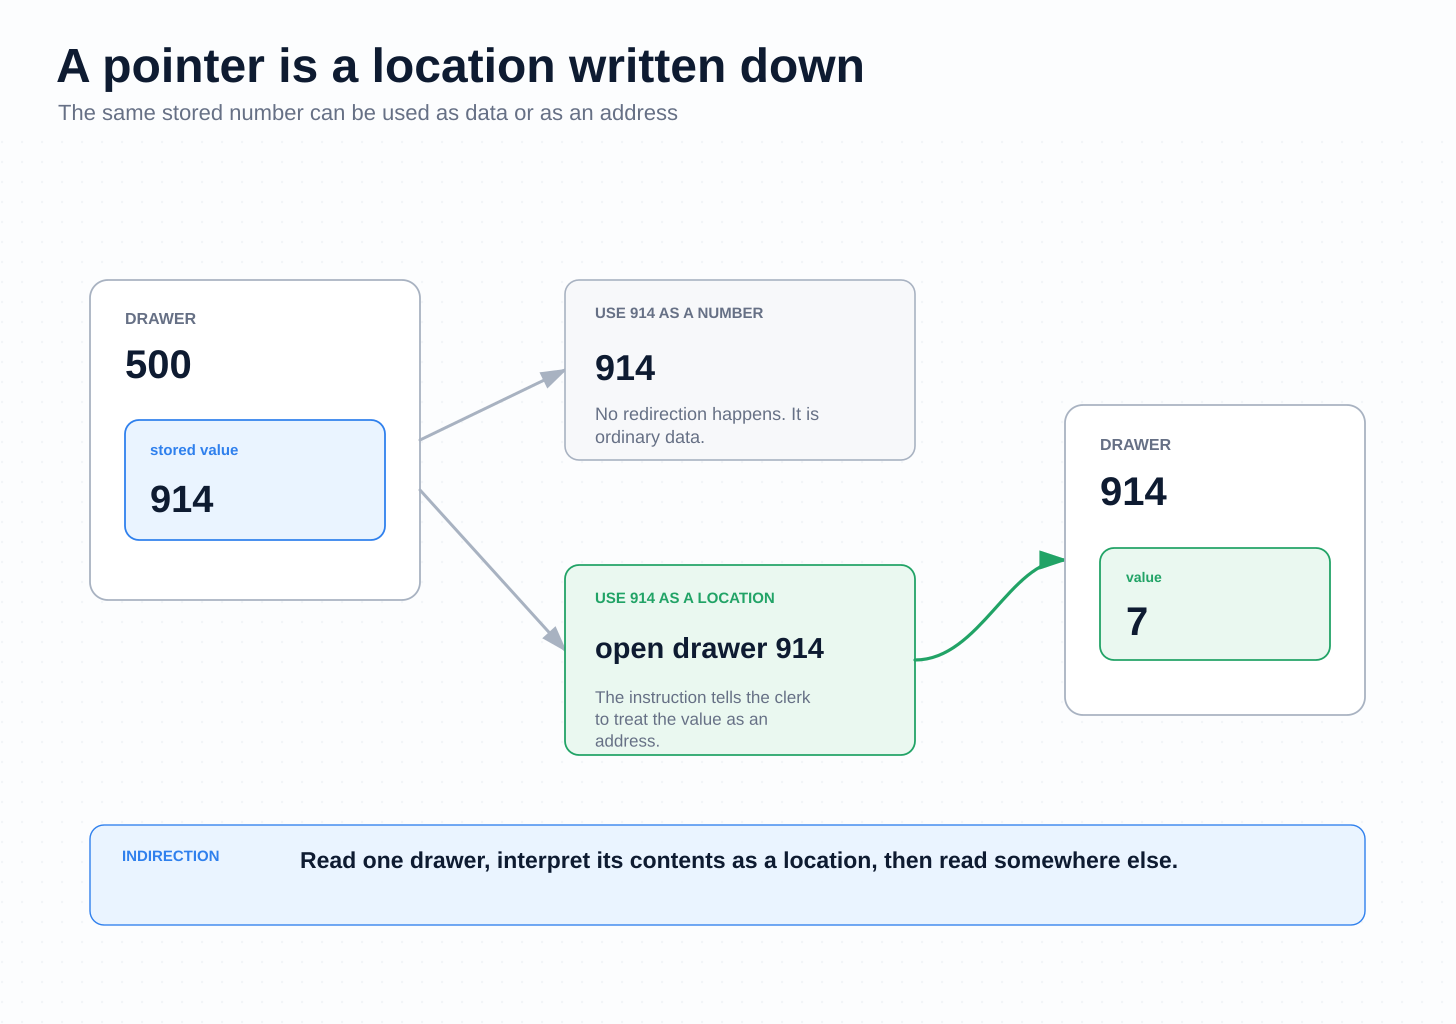
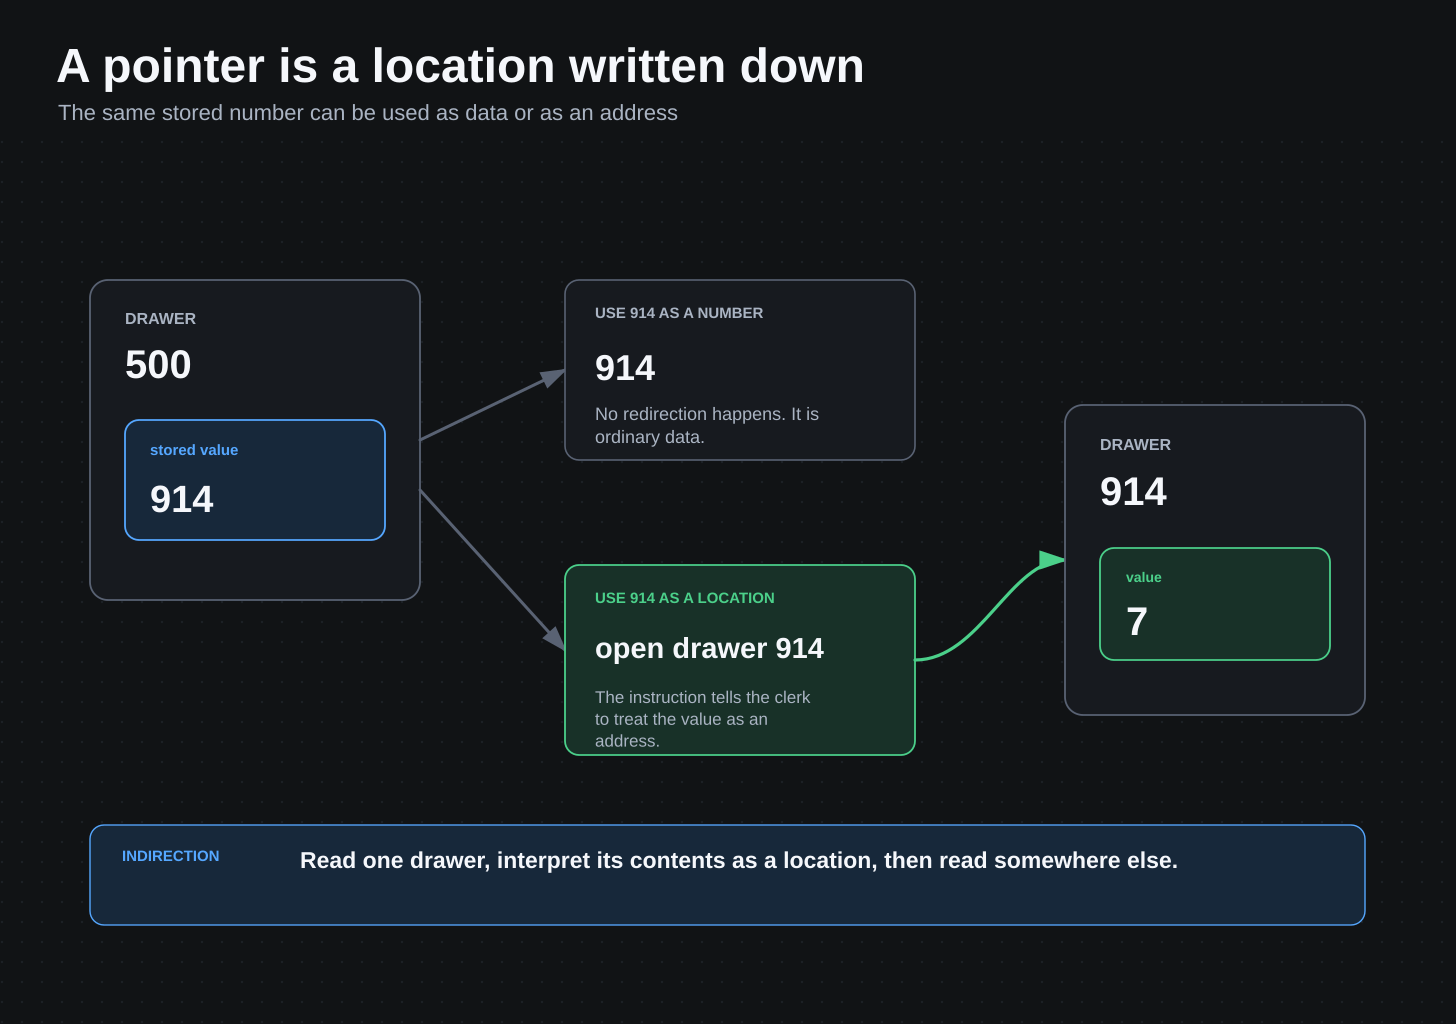
Zeiger lassen sich mit demselben Ablagesystem erklären. Nehmen wir an, Schublade 500 enthält die Zahl 914. Manchmal ist 914 einfach nur die Zahl neunhundertvierzehn. In einem anderen Zusammenhang kann sie bedeuten: Das Gesuchte liegt in Schublade 914. Wird eine Zahl so verwendet, dient sie als Zeiger, also als Adresse, die auf einen anderen Ort (eine andere Schublade) verweist.
Auch hier kommt die Kraft aus der Interpretation. Der Angestellte sieht keinen leuchtenden Pfeil im Speicher schweben. Er liest einen Wert, die aktuelle Anweisung sagt ihm, diesen Wert als Ort zu behandeln, und die nächste Operation verwendet ihn, um eine andere Schublade auszuwählen. Eine einzige gespeicherte Zahl kann also umlenken, wo spätere Arbeit liest oder schreibt.
Das ist ein Grund, warum das Modell des Ablageangestellten so gut skaliert. Daten können andere Daten benennen. Anweisungen können auf andere Anweisungen umlenken. Ein kleiner Satz von Operationen über Orte kann Strukturen aufbauen, deren Verhalten viel reicher ist als die einzelnen Operationen selbst.
Einfache Anweisungen, enormes Verhalten
Eine Schublade lesen. In eine Schublade schreiben. Zwei Werte addieren. Sie vergleichen. Einen Wert als Ort eines anderen verwenden. Ändern, welche Anweisung als Nächstes kommt. Wiederholen. Für sich genommen sind das keine beeindruckenden Handlungen.
Kombiniert man sie in einem sehr großen Ablagesystem bei außergewöhnlicher Geschwindigkeit, können sie Tabellenkalkulationen, Compiler, Spiele, Datenbanken, Bilddecoder, Webbrowser und Betriebssysteme umsetzen. Der Ablageangestellte braucht nicht für jede Anwendung eine eigene mystische Fähigkeit. Wir ordnen Daten und Anweisungen so an, dass dieselbe elementare Maschinerie unterschiedliches Verhalten erzeugt.
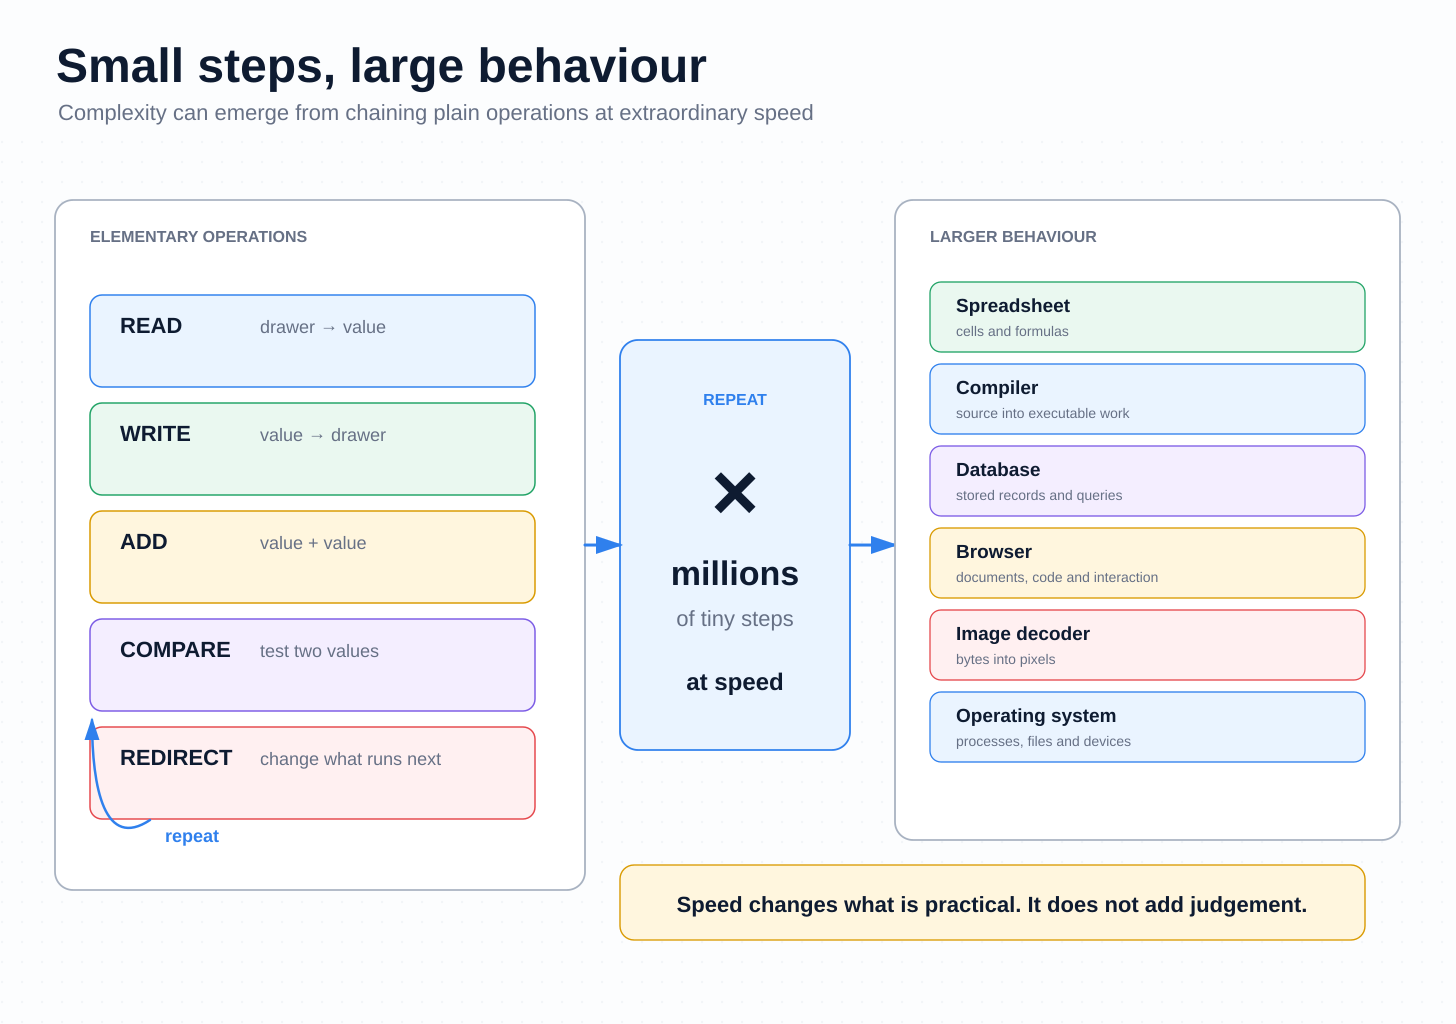
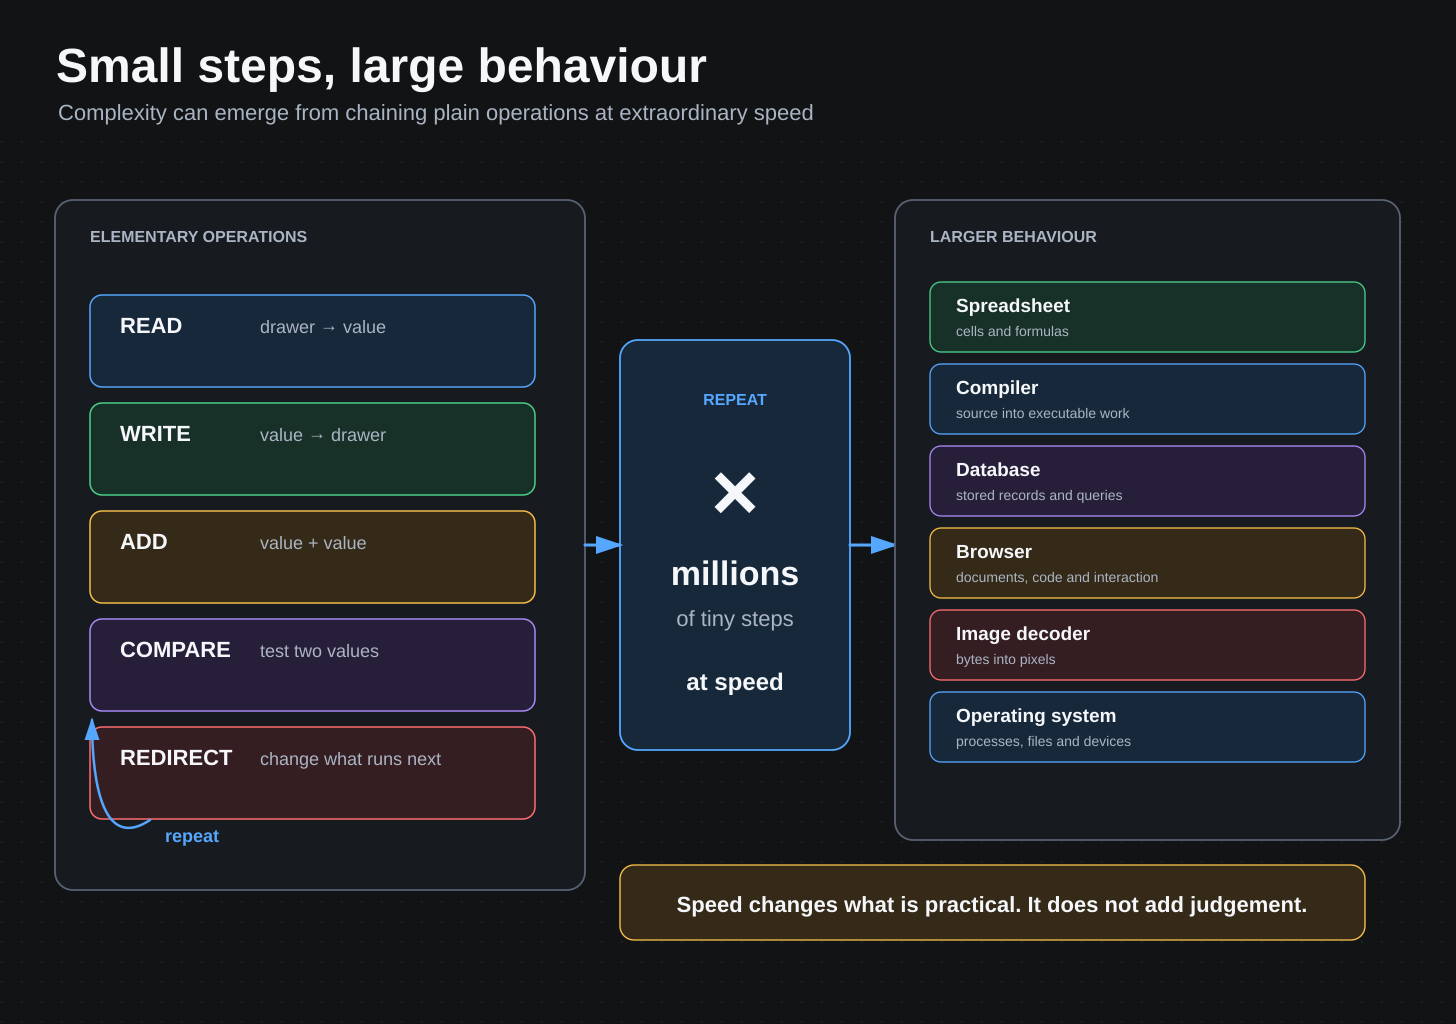
Genau darin liegt die Brillanz der Erklärung. Sie lässt Computer nicht trivial wirken. Ihre Leistung wird vielmehr beeindruckender, weil sie aus so schlichten Zutaten entsteht.
Wenn der Angestellte intelligent zu wirken beginnt
Feynman führt das Modell des Ablageangestellten schließlich zu einer schwierigeren Frage: Kann eine Maschine denken? In seiner Darstellung besteht die Schwierigkeit nicht darin, dass ein Computer niemals ein Denkverfahren ausführen könnte. Menschliches Denken liegt uns vielmehr nicht als bekanntes, vollständig bestimmtes Verfahren vor, das wir dem Angestellten einfach geben könnten.
Bevor er zum Schach kommt, macht Feynman denselben Punkt zunächst mit der Arithmetik einfacher. Die Maschine versucht nicht, das Rechenerlebnis eines Mathematikers nachzuahmen. Sie verwendet einen anderen Mechanismus, der für routinemäßige Arithmetik viel besser geeignet ist.
„Sie rechnen besser als irgendjemand, viel schneller und anders. … wir werden niemals ändern, wie sie rechnen, damit es so aussieht wie bei Menschen; das wäre ein Rückschritt. Denn von Menschen ausgeführte Arithmetik ist langsam, umständlich, verworren und voller Fehler.“
Feynmans Ziel ist hier die Arithmetik, nicht die menschliche Intelligenz im Allgemeinen. Sein Punkt betrifft die Ausführung: Bei routinemäßiger Arithmetik ist gerade die andere Methode des Computers ein Vorteil. Ihn nur deshalb ein menschliches Verfahren nachahmen zu lassen, damit er menschlich wirkt, würde diesen Vorteil wegwerfen.
Das bereitet die schwierigere Frage vor. Wenn eine Maschine Arithmetik nicht auf menschliche Weise ausführen muss, muss intelligentes Verhalten dann auf menschlichem Weg entstehen?
Schach macht die Schwierigkeit konkret. Ein starker menschlicher Spieler scheint nicht Millionen von Stellungen aufzuzählen. Er erkennt Strukturen: eine Gabel, ein schwaches Feld, eine vertraute Form, eine vielversprechende Variante. Feynman weist auf die Lücke zwischen der Aussage hin, jemand sehe ein Muster, und dem tatsächlichen Wissen darüber, durch welches mechanische Verfahren dieses nützliche Muster überhaupt bemerkt wurde.
Ein Computer kann dasselbe Problem anders angehen. Er kann weit mehr Stellungen untersuchen als ein Mensch, explizite Regeln und Bewertungen anwenden und Heuristiken nutzen, damit nicht überall gleich viel Aufwand entsteht. Er muss den inneren Weg nicht nachbilden, über den ein menschlicher Experte zum selben Zug gekommen ist.
Feynman formuliert den Unterschied wunderbar: „Wir können ihn nicht so spielen lassen, wie ein Mensch spielt, aber wir können ihn besser spielen lassen als fast alle Menschen.“ (Hervorhebung von uns)
In diesem Satz steckt eine größere technische Idee. Er trennt Ähnlichkeit von Nützlichkeit. Eine Maschine muss den menschlichen Weg nicht reproduzieren, um ein Ergebnis zu erzeugen, das wir als intelligent erkennen. Entscheidend ist, welches Verfahren sie tatsächlich ausführt, welche Muster oder Regelmäßigkeiten sie nutzen kann, wie sie Möglichkeiten durchsucht oder auswählt und wo ihre Kompetenz endet.
Das Modell des Ablageangestellten übersteht damit auch den scheinbaren Sprung zur Intelligenz. Das Ergebnis kann bemerkenswert klug aussehen, während die zugrunde liegende Maschine weiterhin Darstellungen verarbeitet, Alternativen vergleicht und sich nach bestimmten Operationen durch Zustand bewegt. Das Rätsel ist nicht in die Hardware gewandert. Es liegt nun darin, wie nützliche Struktur dargestellt wird, wie das Verfahren sie findet und wie viel aus Berechnung entstehen kann, ohne dass die Maschine auf menschliche Weise denken muss.
Der spätere Teil des Vortrags reicht viel weiter in denkende Maschinen, Intelligenz, Heuristiken und deren Grenzen hinein als dieser Artikel. Trotzdem verdient Feynmans Schlusssatz, auch in dieser engeren Betrachtung erhalten zu bleiben: „Ich denke, wir kommen intelligenten Maschinen näher, aber sie zeigen die notwendigen Schwächen der Intelligenz.“
Heute lässt sich dieser Satz kaum noch genauso hören wie damals. Er lässt Raum dafür, dass eine Maschine wirklich nützlich, sogar außerordentlich leistungsfähig sein kann, ohne fehlerlos sein zu müssen. Schwäche hebt Intelligenz nicht automatisch auf; sie zeigt uns, dass Intelligenz selbst Grenzen, blinde Flecken und charakteristische Fehlermuster haben kann. Für die Technik ist das ein viel nützlicherer Ausgangspunkt als die Vorstellung, nützliche Maschinenintelligenz müsse zuerst unfehlbar werden.
Der Angestellte nimmt die Anweisungen wörtlich
Dieselbe Intelligenz hat eine scharfe Seite: Der Angestellte darunter arbeitet weiterhin streng wörtlich. Er folgt dem Verfahren, das tatsächlich existiert, und verwendet den Zustand, der tatsächlich vorhanden ist. Er repariert unsere Absicht nicht.
Zeigt eine Anweisung auf die falsche Schublade, weiß der Angestellte nicht irgendwie, welche wir gemeint haben. Enthält Schublade 500 den Wert 915, obwohl wir 914 erwartet haben, kann ein späterer Zeiger woanders hinführen. Ist eine Sprungbedingung falsch formuliert, kann der Angestellte vollkommen korrekt dem falschen Zweig folgen. Deutet ein Teil des Systems einen Wert als Größe und ein anderer als etwas anderes, hält der Angestellte nicht an, weil ihm die Unstimmigkeit verdächtig vorkommt.
Wenn wir sagen, der Angestellte sei verwirrt, meinen wir nicht, dass der Computer menschliche Verwirrung erlebt. Wir meinen, dass Zustand, Darstellung oder Verfahren nicht mehr zu dem Modell passen, von dem der Entwickler glaubte, es werde durchgesetzt. Die Maschine kann vollkommen gehorsam bleiben, während das System falsch wird.
In realen Systemen können auch mehrere Angestellte mit denselben Schubladen arbeiten. Einer kann einen Wert lesen, während ein anderer ihn verändert, löscht oder die Schublade für etwas anderes verwendet. Der erste kann dann mit einem alten Wert weiterarbeiten oder sogar einer Notiz zu einer Schublade folgen, die nicht mehr zu dem gehört, wofür er sie hielt. Sobald mehrere Angestellte dieselben Schubladen erreichen können, wird Teil der Korrektheit des Verfahrens, wer sie wann lesen oder verändern kann.
Hier beginnt Technik interessant zu werden
Viele schwierige Softwarefehler lassen sich auf eine Variante dieses Problems zurückführen. Dem falschen Ort wurde gefolgt. Eine Entscheidung wurde mit einer Darstellung getroffen und eine Aktion mit einer anderen ausgeführt. Ein Wert wurde geprüft und änderte sich danach noch vor seiner Verwendung. Ein veralteter Datensatz wurde als aktuell behandelt. Ein Ausweichpfad leitete die Arbeit auf einen anderen Weg. Eine spätere Stufe vertraute auf eine Bedeutung, die eine frühere Stufe nie hergestellt hatte.
Von außen können solche Fehler hochentwickelte Software betreffen. Von innen nach außen betrachtet sind die Fragen oft wunderbar konkret. Welchen Wert hat der Angestellte gelesen? Welche Schublade bezeichnete dieser Wert? Welche Anweisung lief als Nächstes? Welche Bedingung löste den Sprung aus? Welchen Zustand glaubte die nächste Anweisung erhalten zu haben?
Das ist eine technische Gewohnheit, die uns wichtig ist. Wenn eine Aussage auf Systemebene vage wird, gehen wir so weit nach unten, bis der Mechanismus wieder wörtlich beschreibbar ist.
Und hier kommt Sicherheit ins Spiel
Ein gewöhnlicher Bug kann den Angestellten versehentlich in die Irre führen. Ein Sicherheitsproblem wird möglich, wenn jemand Zustand oder Anweisungen absichtlich so beeinflussen kann, dass die Maschine zu einer nützlichen Folge gelenkt wird.
Ein Angreifer muss den Computer nicht ungehorsam machen. Im Gegenteil. Einige der interessantesten Fehler entstehen gerade deshalb, weil der Computer zu treu gehorcht: Er folgt dem vom Angreifer beeinflussten Zeiger, akzeptiert die irreführende Darstellung, nimmt den erlaubten Sprung, führt die autorisierte Operation aus oder reicht einen Wert genau so an die nächste Komponente weiter, wie es das Verfahren vorsieht.
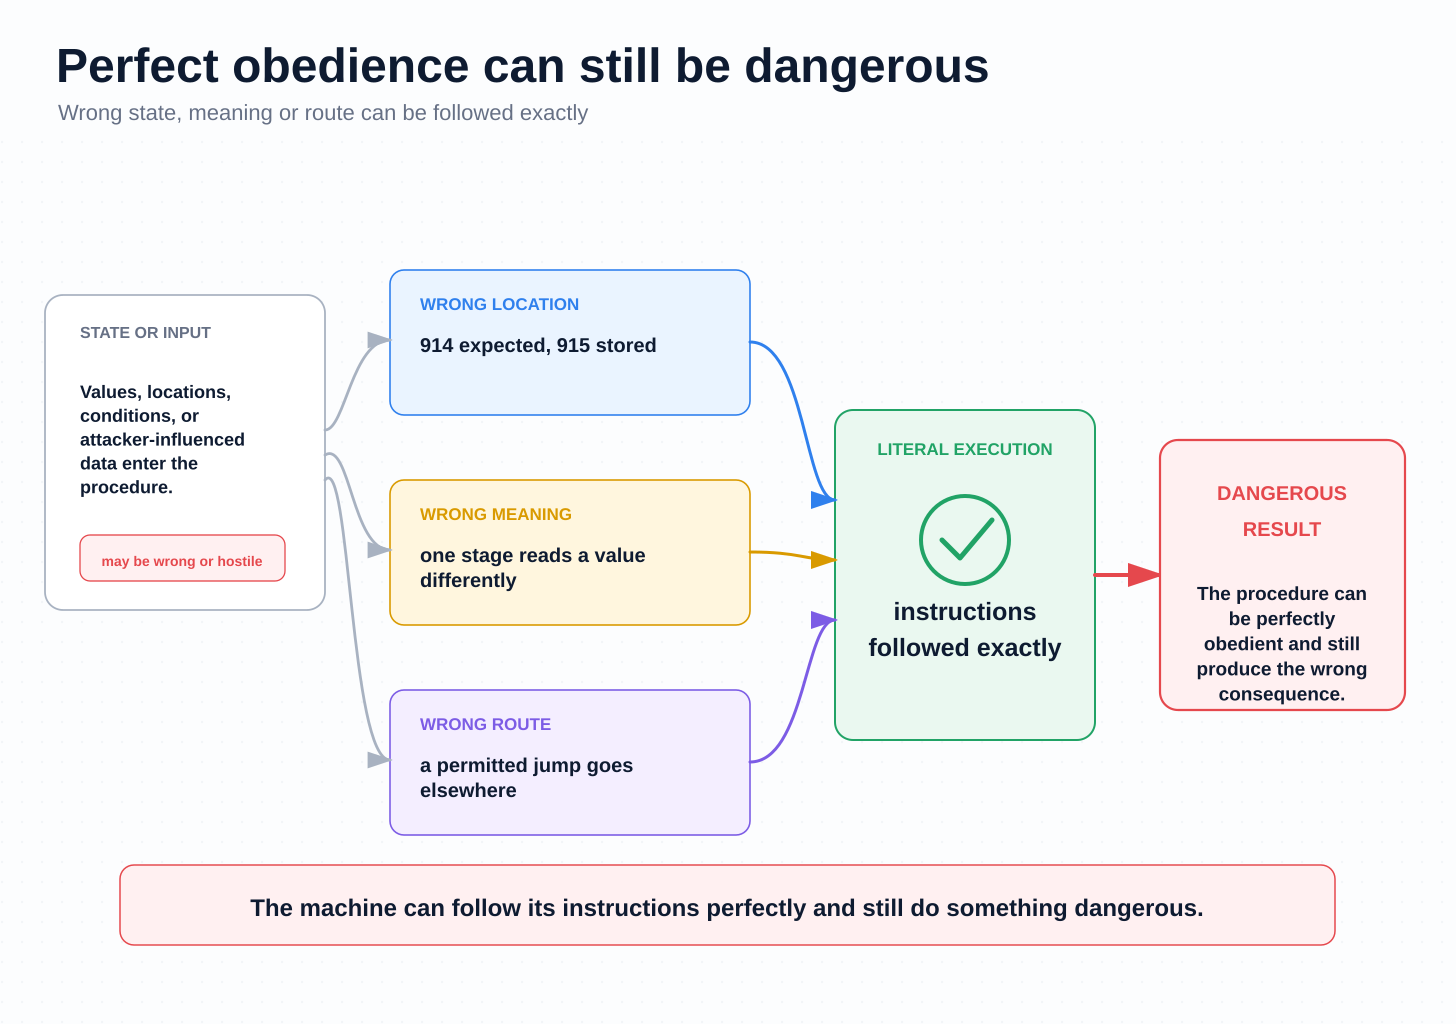
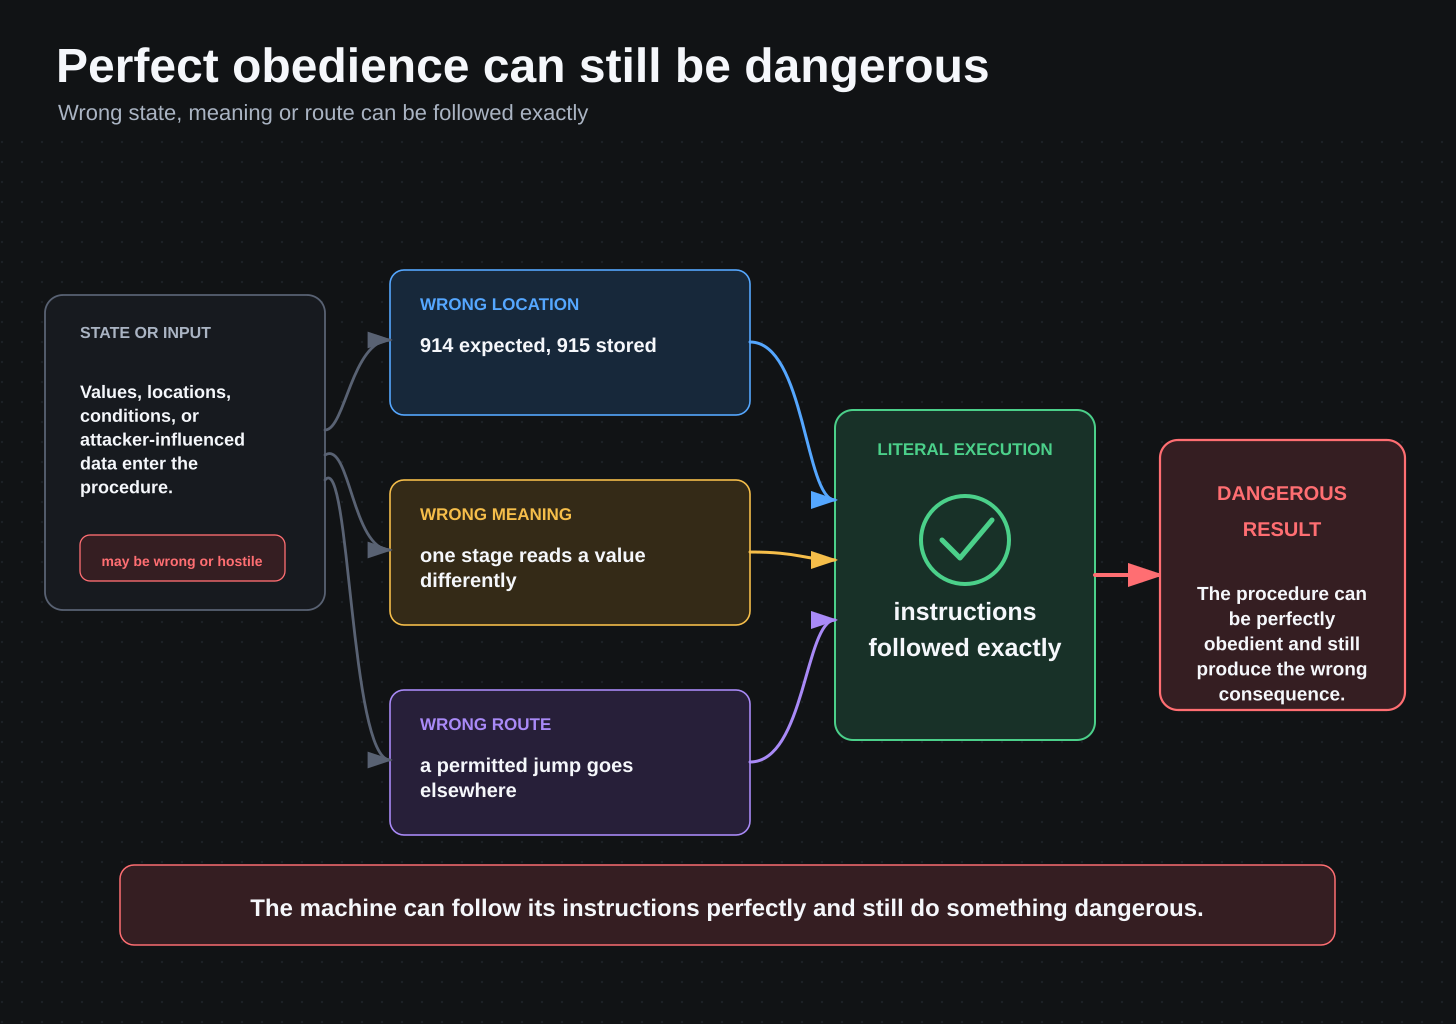
Die Folge hängt dann davon ab, was der Angestellte tun darf. Verwirrung in einem wegwerfbaren Arbeitsbereich kann harmlos sein. Dieselbe Verwirrung in der Nähe von Zugangsdaten, dauerhaftem Zustand, privaten Daten, Netzwerkzugriff oder einer anderen privilegierten Komponente kann enorm wichtig sein.
Auf diese Unterschiede werden wir an anderer Stelle zurückkommen. Dieser Artikel soll ihnen nicht vorgreifen. Er soll uns ein gemeinsames Denkmodell geben: Bevor wir über den Namen einer Sicherheitseigenschaft streiten, fragen wir, welche Informationen existieren, was sie bedeuten, wohin sie zeigen, welche Anweisung als Nächstes läuft und welche Befugnisse von dort aus erreichbar sind.
Ein Modell, das wir wiederverwenden wollen
Wir erwarten, dass der Ablageangestellte in XMAKYNA Texten immer wieder auftaucht, weil er schwierige Ideen zugänglich macht, ohne sie kindlich zu machen. Ein Zeiger wird zu einem notierten Ort. Ein Sprung wird zu einer Änderung des Zettels mit der „nächsten Anweisung“. Der Programmzähler wird zum Lesezeichen des Angestellten. Speicher wird zu Schubladen. Ausführung wird zu einer Folge winziger Operationen auf diesen Schubladen.
Steht dieses Bild einmal, haben weiterführende Argumente festen Boden. Wir können über falschen Zustand, veralteten Zustand, irreführende Darstellung, Umleitung, Befugnis und vom Angreifer steuerbare Verwirrung sprechen, ohne so zu tun, als hätte der Computer menschliches Urteilsvermögen oder als erkläre der Name einer Abstraktion schon den Mechanismus.
Das Modell ist nützlich, wenn schwierige Technik geheimnisvoller zu wirken beginnt, als sie ist. Nimmt man Maßstab und Fremdheit weg, bleibt in gewissem Sinn immer noch ein Aktenschrank: Stimmen Zustand, Darstellung und Verfahren, führt die Maschine die Arbeit aus.
Deshalb ist dieser Vortrag mehr als eine charmante alte Erklärung von Computern. Er gibt uns eine dauerhafte Art zu denken.
Metadaten des Vortrags und Hinweis zur Benennung
Sprecher: Richard P. Feynman. Die verlinkte Aufnahme selbst zeigt das Datum 26. September 1985 und nennt als Rahmen den Workshop Idiosyncratic Thinking am Esalen Institute in Big Sur, Kalifornien.
Der Vortrag ist unter verschiedenen Titeln verbreitet worden, und einige veröffentlichte Quellen datieren damit zusammenhängendes Esalen-Material anders. Der verlinkte Upload trägt den Titel Hardware, Software and Heuristics; Computers From the Inside Out und The Feynman Lecture on Heuristics erscheinen ebenfalls andernorts. Hier bezeichnen wir den Vortrag als Computers From the Inside Out.
Vortrag ansehen: Richard Feynman, Computers From the Inside Out (YouTube).
Unterm Strich
Zerlegt man einen Computer weit genug, bleibt ein überraschend dauerhaftes Bild: ein sehr schneller, sehr wörtlich arbeitender Ablageangestellter mit einer faktisch riesigen Menge nummerierter Schubladen und einem kleinen Repertoire an Operationen. Werte können andere Schubladen benennen. Anweisungen können ändern, welche Anweisung als Nächstes kommt. Der Programmzähler ist lediglich der Platzhalter des Angestellten. Ein Sprung verändert diesen Platzhalter. Enormes Verhalten entsteht daraus, dass diese einfachen Bewegungen mit außergewöhnlicher Geschwindigkeit wiederholt werden.
Das Modell ist einfach, aber nicht oberflächlich. Es erinnert uns daran, dass die Maschine auf dem Zustand und der Darstellung arbeitet, die wir tatsächlich codiert haben, nicht auf der Absicht, von der wir hofften, sie werde irgendwie verstanden. Ein verwirrter Angestellter ist ein Korrektheitsproblem. Kann ein Angreifer ihn absichtlich verwirren und ist damit nutzbare Befugnis verbunden, ist es ein Sicherheitsproblem. Zu diesem Gedanken werden wir immer wieder zurückkehren.