
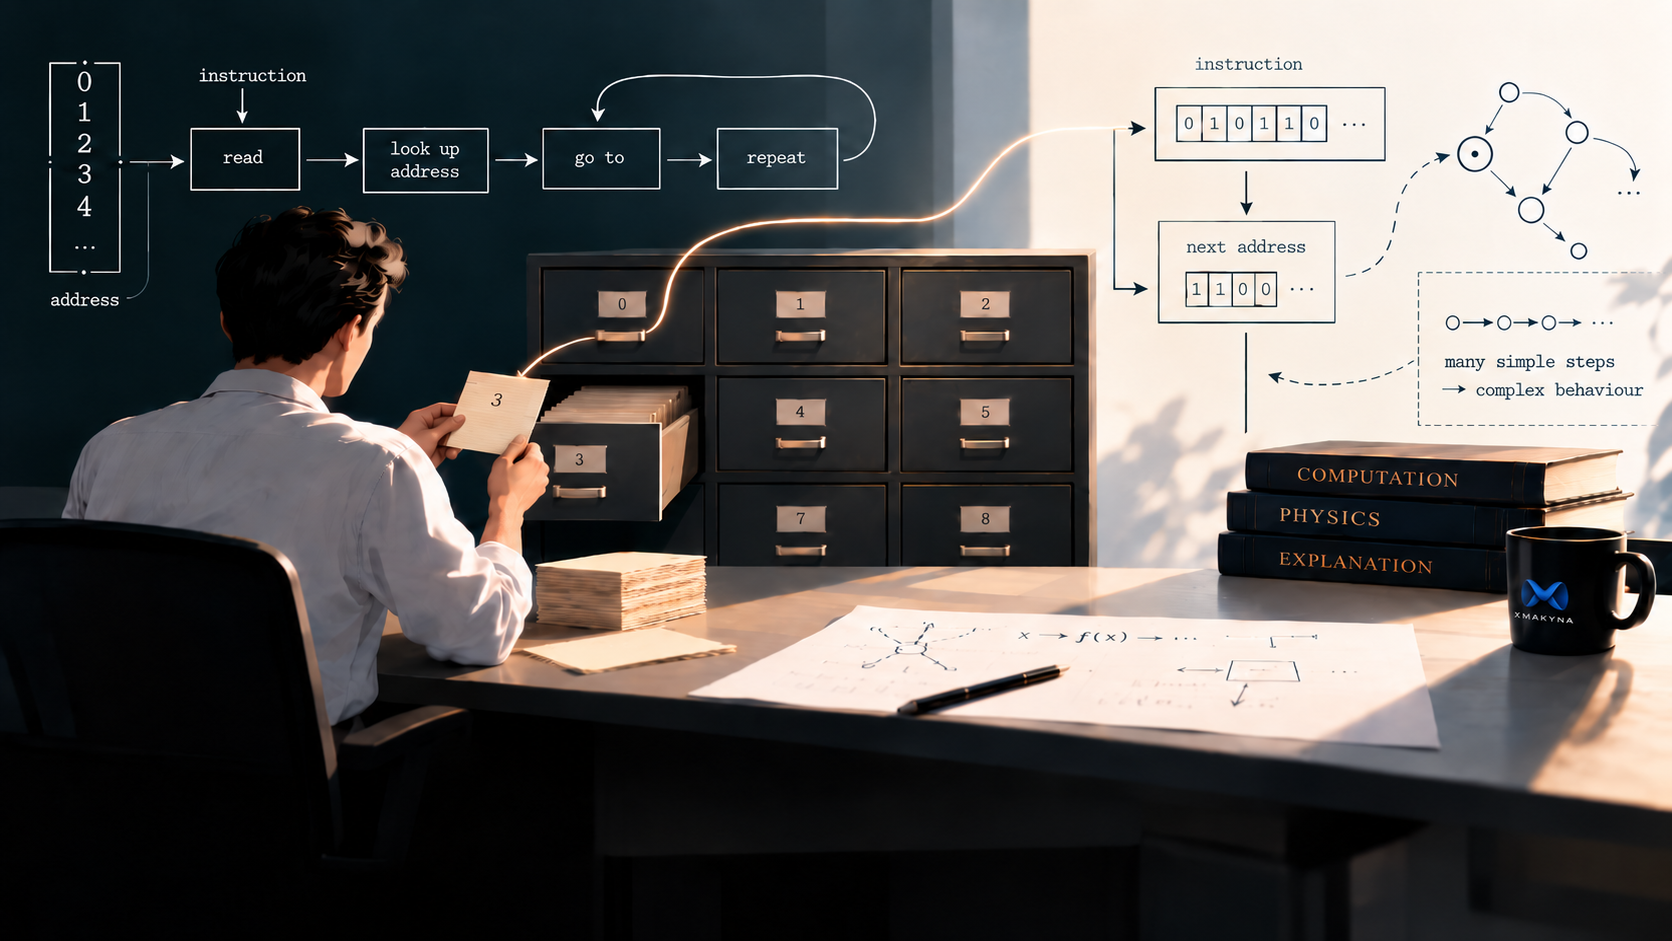
Richard Feynman es una figura legendaria de la ciencia, pero eso, por sí solo, no explica por qué abrimos el blog técnico de XMAKYNA con esta conferencia. Empezamos aquí porque gran parte de la ingeniería que nos importa acaba reduciéndose a preguntas muy sencillas: ¿qué leyó la máquina?, ¿qué almacenó?, ¿qué hizo después? y ¿sobre qué se le permitía actuar? El modelo del empleado de archivo de Feynman nos da un lenguaje común para esas preguntas. Los artículos posteriores pueden construir sobre esa base en lugar de explicarla de nuevo desde cero.
Más de cuarenta años después (el seminario se grabó en 1985), la conferencia sigue pareciendo sorprendentemente actual. Puede aportar algo a casi cualquier persona que sienta curiosidad por los ordenadores, porque Feynman no empieza con jerga técnica. Nos da un empleado, cajones numerados, instrucciones sencillas, una nota que le indica adónde ir después y valores que pueden apuntar a otros cajones. Con esos elementos, el funcionamiento básico de un ordenador empieza a hacerse visible.
Ni la conferencia ni este artículo explican todo sobre los ordenadores. Sí explican un núcleo útil: la información se almacena en algún lugar, las instrucciones determinan qué ocurre después, los valores almacenados pueden dirigir la máquina a otro lugar y las operaciones simples pueden combinarse para producir un comportamiento mucho más complejo.
Esto también importa para la seguridad. Muchos fallos graves resultan mucho menos misteriosos cuando se reducen a esta imagen. La máquina puede leer del lugar equivocado, seguir el siguiente paso incorrecto, confiar en un valor que significa algo distinto de lo que esperaba otra parte del sistema o ser dirigida deliberadamente por alguien capaz de influir en lo que hay en un cajón o en dónde mira el empleado a continuación.
La máquina puede seguir sus instrucciones a la perfección y aun así hacer algo peligroso. Entenderlo es uno de los fundamentos a los que volveremos una y otra vez.
La conferencia resuena de otra manera ahora que convivimos con grandes modelos de lenguaje (LLM) y otros sistemas cuyas salidas pueden parecer extraordinariamente capaces. Feynman no estaba explicando la IA moderna, y este artículo no va a fingir que lo hacía. Lo que su conferencia nos ofrece es algo más fundamental: una forma de mirar más allá de una salida impresionante y preguntar qué está haciendo realmente la máquina, cómo llegó hasta ahí, en qué puede equivocarse y qué ocurre cuando esos errores importan. Para nosotros, esta es una preocupación central de ingeniería al usar IA: que el código pueda construirse (compile), se ejecute y parezca plausible no basta; todavía tenemos que establecer que es correcto.
Por eso este artículo empieza deliberadamente por los fundamentos. Sigue las metáforas sencillas de Feynman lo bastante lejos como para que una persona no especialista pueda construir una imagen sólida de cómo un ordenador encuentra información, sigue instrucciones, cambia de dirección y produce un comportamiento complejo a partir de pasos simples. Necesitaremos esa imagen muchas veces más adelante.
Empezar con un empleado y unos cajones
Imaginemos a un empleado en una habitación llena de cajones numerados. Cada cajón puede contener un número u otra pieza sencilla de información. El empleado puede abrir un cajón, leer lo que hay dentro, copiar un valor, escribir un valor nuevo en otro lugar, comparar dos valores y seguir una instrucción que le dice qué hacer después.
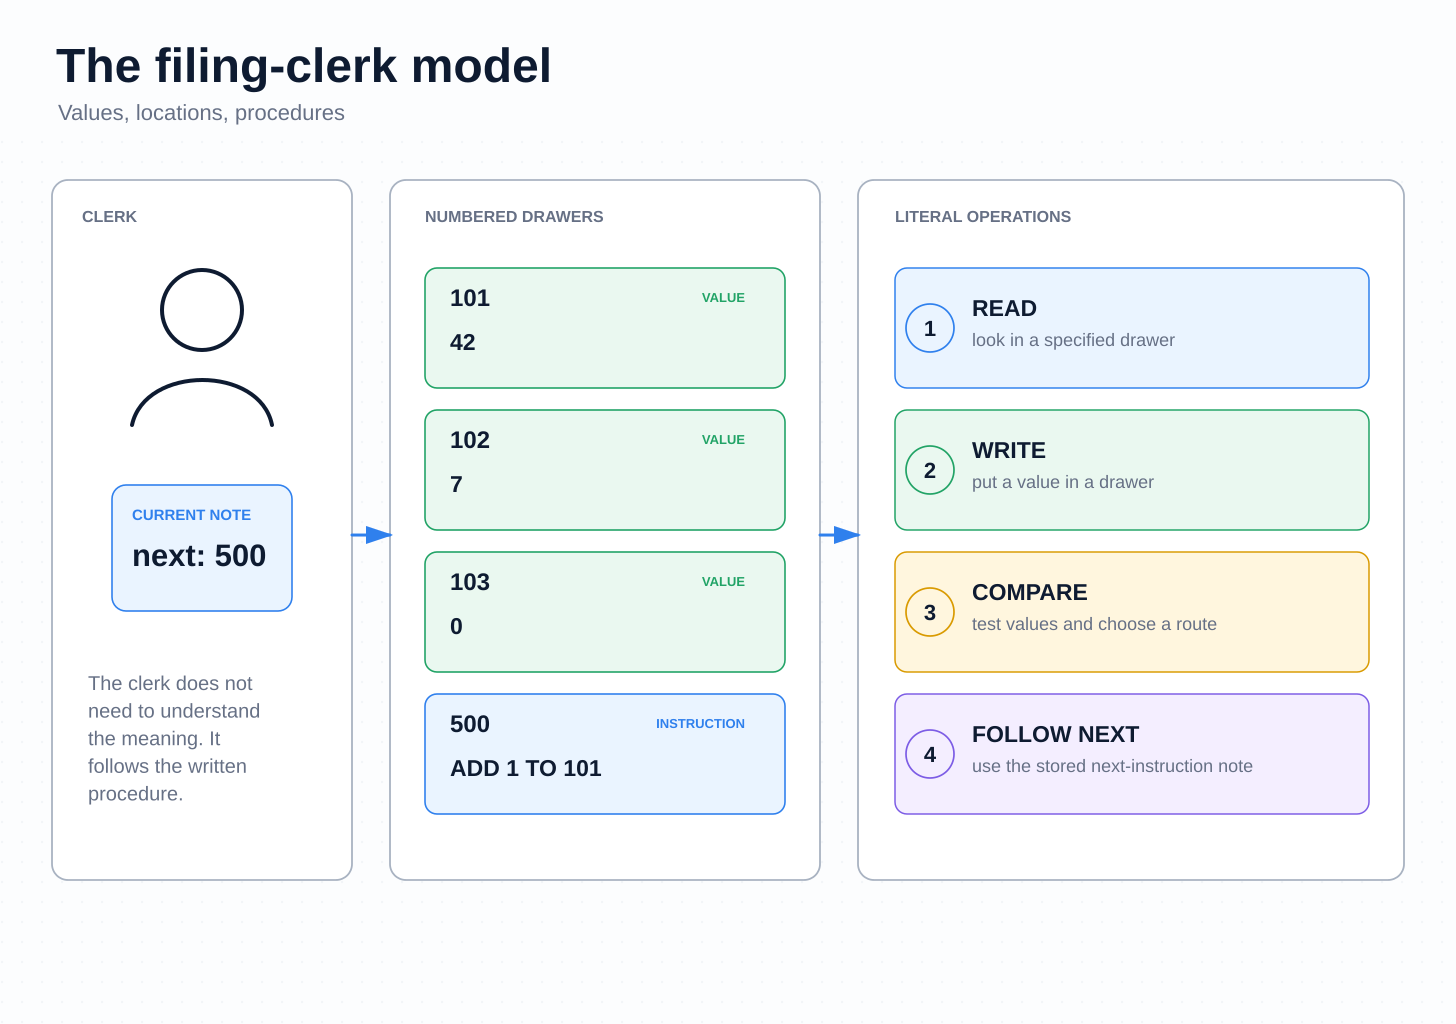
Es deliberadamente poco glamuroso. El empleado no necesita saber si un número representa dinero, un color, una letra, una temperatura, una posición en un tablero de ajedrez o la dirección de otro cajón. El significado lo imponemos nosotros mediante la representación. Para el empleado hay valores, ubicaciones y procedimientos.
Esta es una de las formas más útiles de desmitificar un ordenador. Una máquina puede producir un comportamiento que desde fuera parece asombroso y, aun así, estar construida con operaciones que, por separado, son casi ridículamente sencillas. La sofisticación surge de la organización: qué se almacena, cómo se representa, qué instrucción se ejecuta después y cuántas operaciones de ese tipo pueden encadenarse.
La ruta por el programa también está almacenada
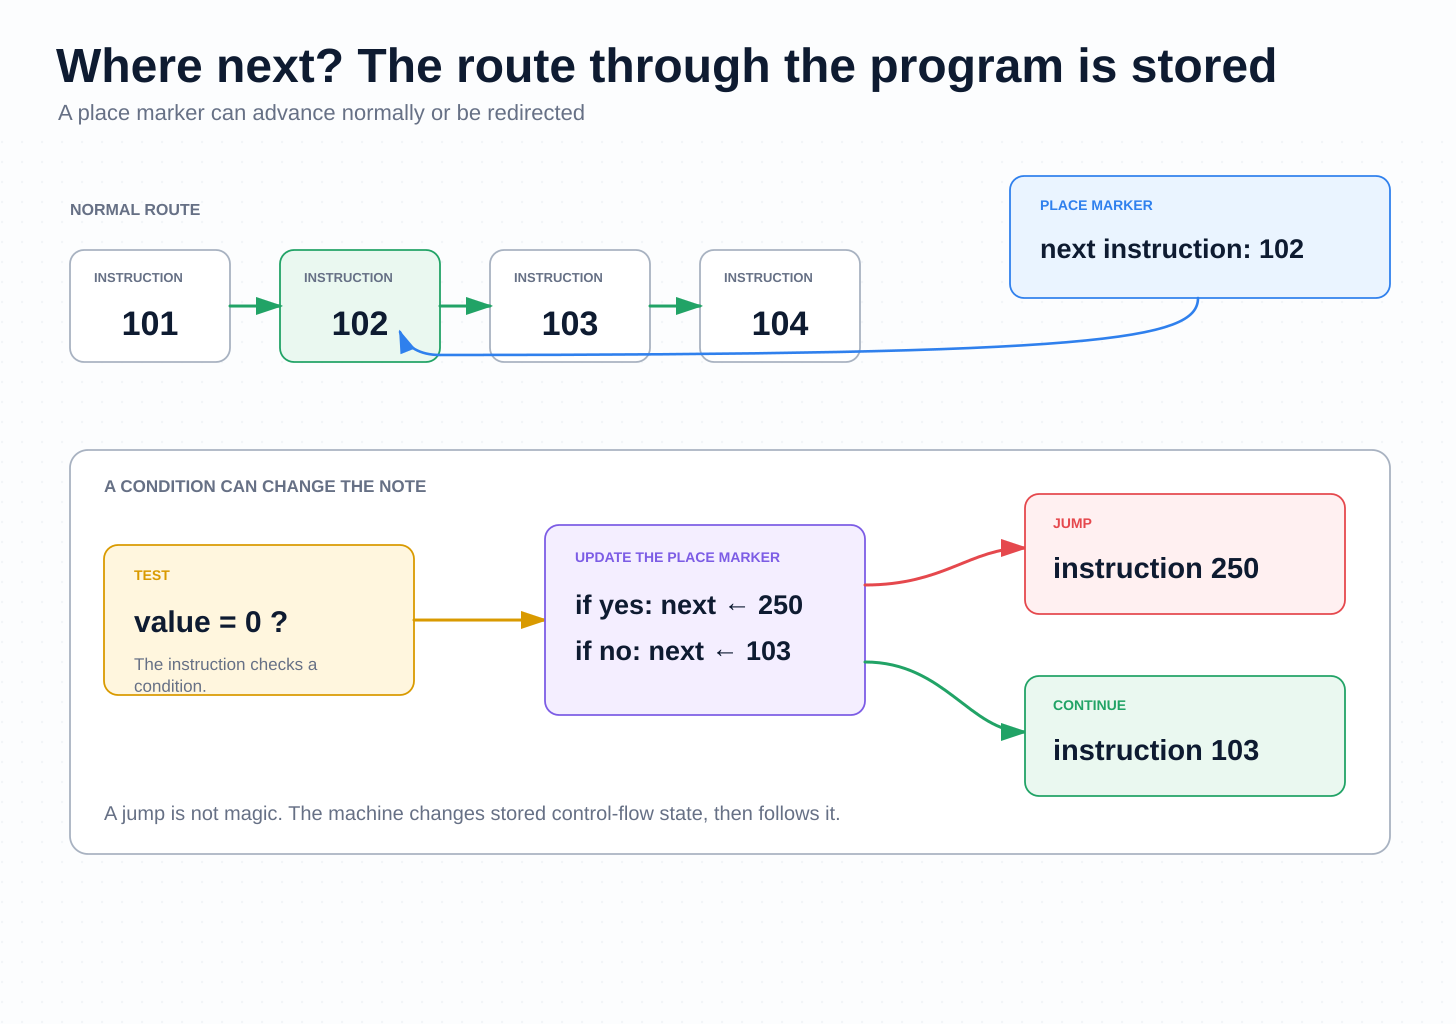
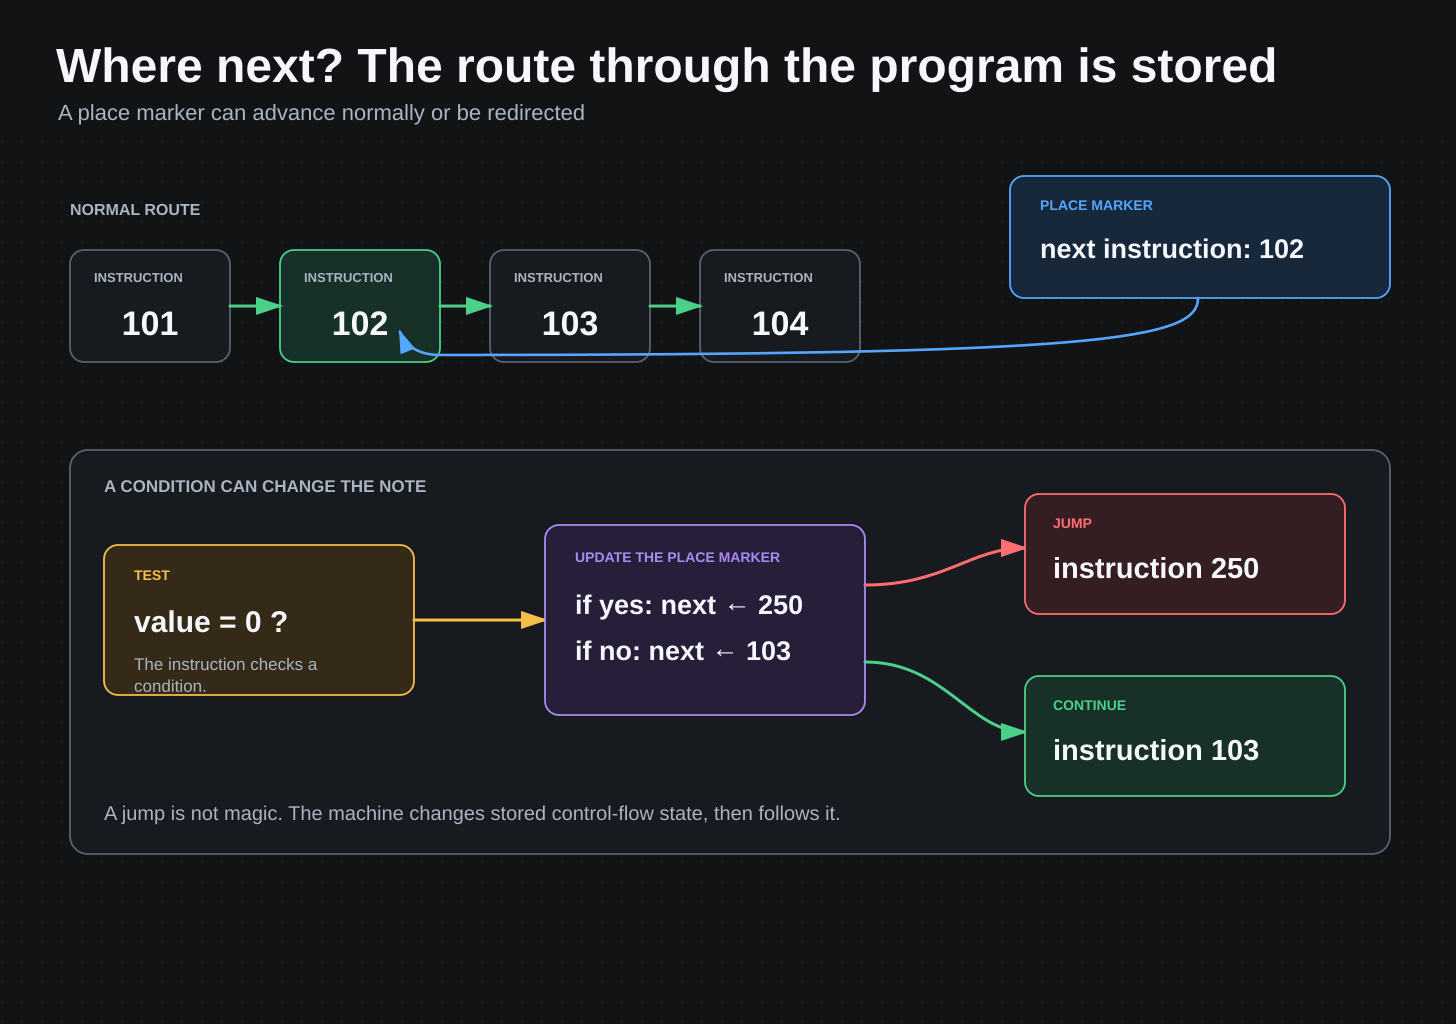
La parte realmente potente es que el sistema de archivo puede describir no solo los datos, sino también el recorrido del trabajo. En algún lugar, el empleado lleva la cuenta de qué instrucción viene a continuación. En la arquitectura informática moderna, ese pequeño fragmento de estado suele llamarse contador de programa. El nombre puede sonar técnico; la idea subyacente es casi cómicamente sencilla. Es la nota del empleado que, en esencia, dice: «lee la instrucción 101 a continuación».
Después de la instrucción 101, la regla normal podría ser continuar con 102, después 103 y después 104. Pero una instrucción también puede decir: no sigas con la tarjeta siguiente; ve a la instrucción 250. Eso es un salto. Un salto condicional añade una prueba: si este valor es cero, ve a 250; de lo contrario, continúa con 102.
No ha ocurrido nada misterioso. La máquina ha cambiado la ubicación almacenada de la siguiente instrucción. Sin embargo, de esa sola idea obtenemos ramas, bucles, reintentos y gran parte de la forma habitual de un programa. Un bucle es simplemente un salto que devuelve al empleado a instrucciones ya visitadas hasta que cambia alguna condición.
Vale la pena detenerse aquí porque una gran cantidad de jerga informática se reduce a algo parecido a llevar un registro. El flujo de control de la máquina es, en sí mismo, estado. La respuesta a «¿qué ocurre después?» está representada en algún lugar, y las instrucciones pueden cambiarla.
Un puntero es solo una ubicación anotada
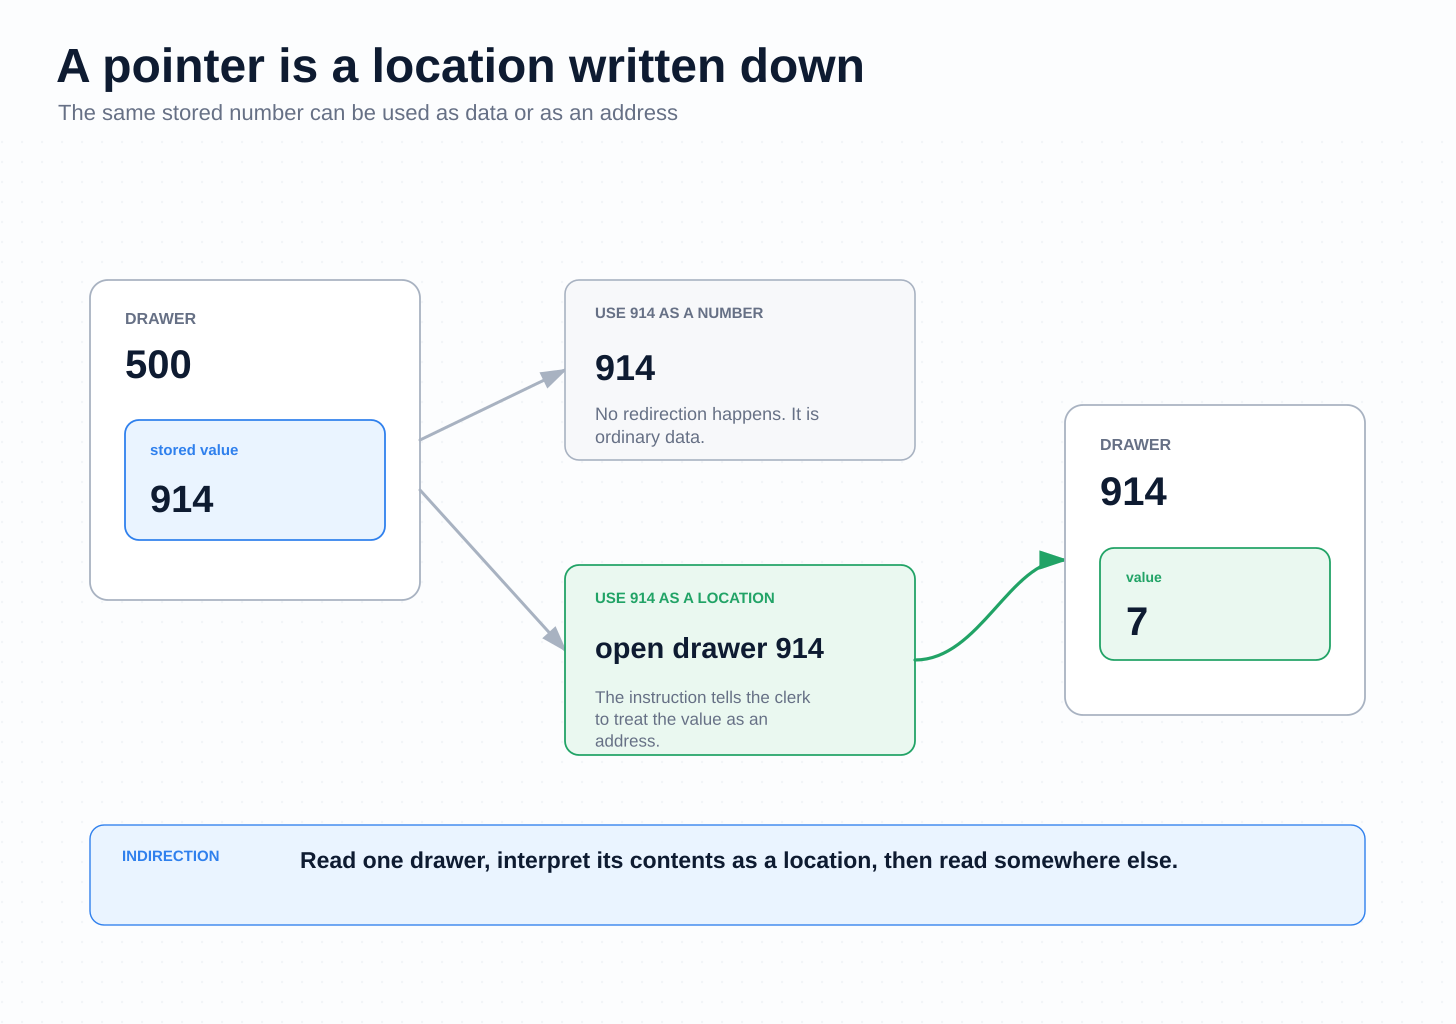
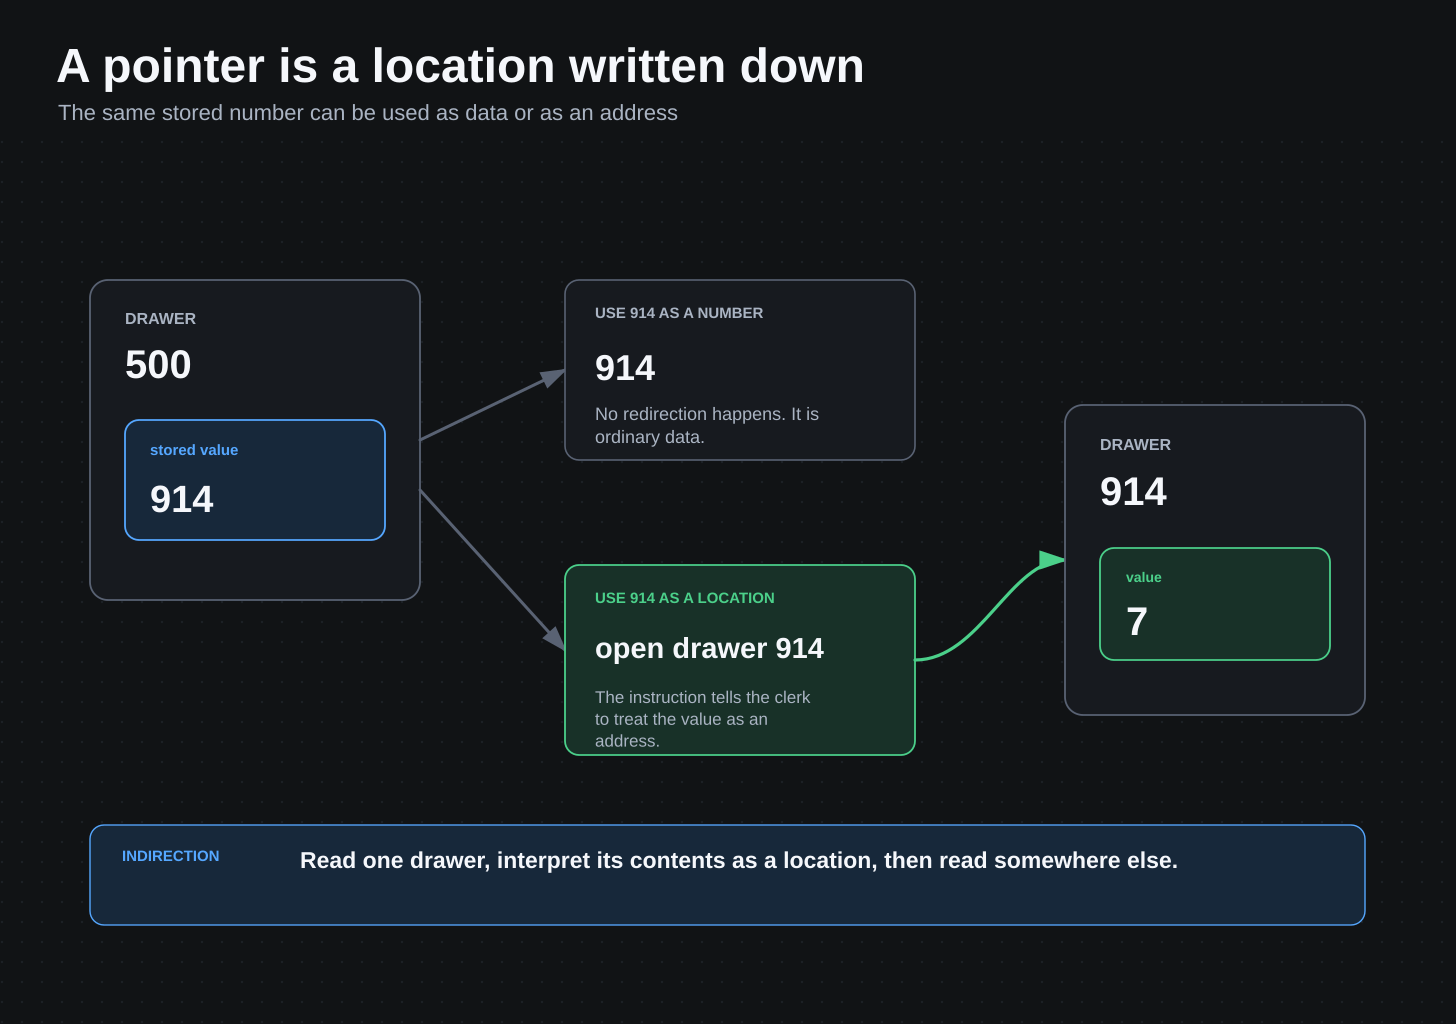
Los punteros pueden explicarse con el mismo sistema de archivo. Supongamos que el cajón 500 contiene el número 914. A veces 914 es simplemente el número novecientos catorce. En otro contexto puede significar: lo que buscas está guardado en el cajón 914. Cuando un número se usa de esa manera, actúa como un puntero, es decir, como una dirección que hace referencia a otra ubicación (otro cajón).
Una vez más, la potencia viene de la interpretación. El empleado no ve una flecha brillante flotando por la memoria. Lee un valor, la instrucción actual le dice que trate ese valor como una ubicación y la siguiente operación lo utiliza para elegir otro cajón. Un único número almacenado puede, por tanto, redirigir el lugar del que el trabajo posterior lee o en el que escribe.
Esta es una de las razones por las que el modelo del empleado de archivo escala tan bien. Los datos pueden nombrar otros datos. Las instrucciones pueden redirigir a otras instrucciones. Un pequeño conjunto de operaciones sobre ubicaciones puede construir estructuras cuyo comportamiento es mucho más rico que las propias operaciones.
Instrucciones simples, comportamiento enorme
Leer un cajón. Escribir en un cajón. Sumar dos valores. Compararlos. Usar un valor como ubicación de otro. Cambiar qué instrucción viene después. Repetir. Por separado, no son acciones impresionantes.
Combinadas en un sistema de archivo muy grande y a una velocidad extraordinaria, pueden implementar hojas de cálculo, compiladores, juegos, bases de datos, decodificadores de imágenes, navegadores web y sistemas operativos. El empleado de archivo no necesita una capacidad misteriosa diferente para cada aplicación. Organizamos los datos y las instrucciones para que la misma maquinaria elemental produzca comportamientos distintos.
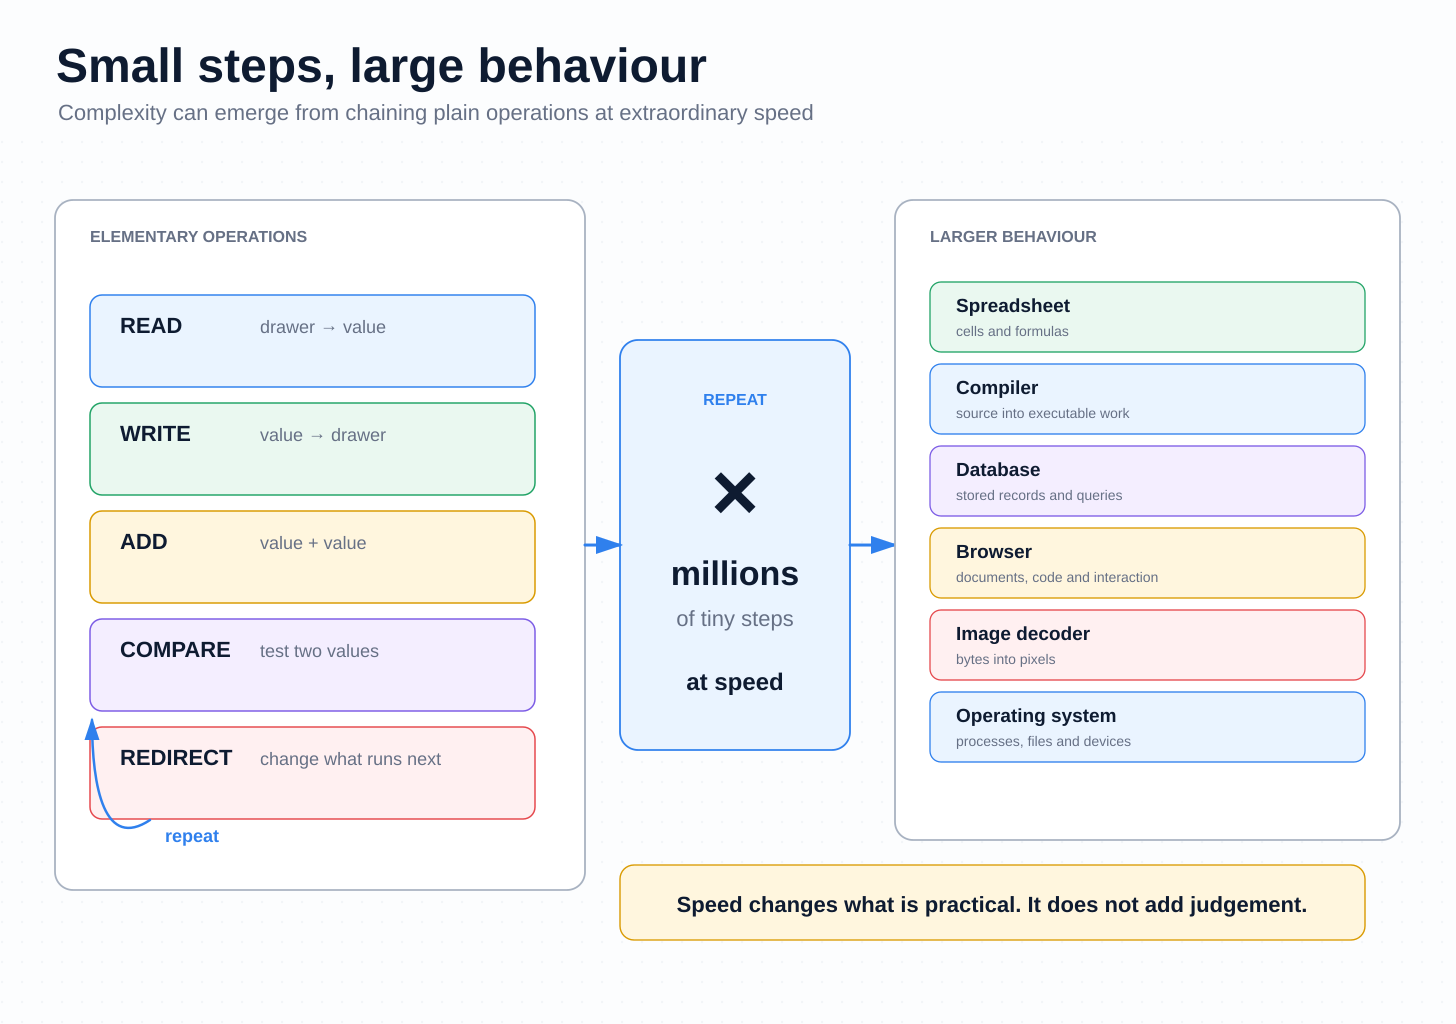
Ahí está la brillantez de la explicación. No hace que los ordenadores parezcan triviales. Hace que su potencia resulte aún más impresionante precisamente porque está construida con ingredientes tan sencillos.
Cuando el empleado empieza a parecer inteligente
Feynman acaba llevando el modelo del empleado de archivo hacia una pregunta más difícil: ¿puede pensar una máquina? En su planteamiento, la dificultad no es que un ordenador jamás pudiera ejecutar un procedimiento de pensamiento. Es que el pensamiento humano no viene acompañado de un procedimiento conocido y completamente definido que podamos entregar sin más al empleado.
Antes de llegar al ajedrez, Feynman plantea una versión más sencilla del mismo punto con la aritmética. La máquina no intenta imitar la experiencia de un matemático al calcular. Utiliza un mecanismo distinto, mucho más adecuado para la aritmética rutinaria.
«Hacen aritmética mejor que cualquiera, mucho más rápido y de otra manera. … nunca vamos a cambiar la forma en que hacen aritmética para que parezca humana; eso sería retroceder. Porque la aritmética hecha por humanos es lenta, engorrosa, confusa y está llena de errores.»
El objetivo de Feynman aquí es la aritmética, no la inteligencia humana en general. Su punto se refiere a la ejecución: para la aritmética rutinaria, el método distinto del ordenador es una ventaja. Hacer que imite un procedimiento humano solo para parecer humano supondría tirar esa ventaja.
Eso prepara la pregunta más difícil. Si una máquina no necesita hacer aritmética al modo humano, ¿debe el comportamiento inteligente producirse también por la ruta humana?
El ajedrez vuelve concreta la dificultad. Un jugador humano fuerte no parece enumerar millones de posiciones. Percibe estructura: un tenedor, una casilla vulnerable, una forma familiar, una línea prometedora. Feynman llama la atención sobre la distancia entre decir que una persona ve un patrón y saber realmente cuál es el procedimiento mecánico por el que ese patrón útil se detectó en primer lugar.
Un ordenador puede abordar el mismo problema de otra manera. Puede examinar muchas más posiciones que una persona, aplicar reglas y evaluaciones explícitas y utilizar heurísticas para no dedicar el mismo esfuerzo a todas partes. No necesita recrear el recorrido interior por el que un experto humano llegó a la misma jugada.
Feynman expresa la distinción de forma magnífica: «No podemos hacer que juegue como juega un humano, pero podemos hacer que juegue mejor que casi todos los humanos.» (énfasis nuestro)
Esa frase contiene una idea de ingeniería más amplia. Separa la semejanza de la utilidad. Una máquina no tiene que reproducir la ruta humana para producir un resultado que reconocemos como inteligente. Lo que importa es qué procedimiento está ejecutando realmente, qué patrones o regularidades puede aprovechar, cómo busca o selecciona entre posibilidades y dónde termina su competencia.
El modelo del empleado de archivo sobrevive, por tanto, al aparente salto hacia la inteligencia. El resultado puede parecer extraordinariamente inteligente mientras la máquina subyacente sigue manipulando representaciones, comparando alternativas y recorriendo estados según operaciones definidas. El misterio no se ha trasladado al hardware. Se ha trasladado a cómo se representa una estructura útil, cómo la encuentra el procedimiento y cuánto puede surgir del cálculo sin exigir que la máquina piense como una persona.
La parte final de la conferencia se adentra mucho más que este artículo en las máquinas pensantes, la inteligencia, las heurísticas y sus límites. Aun así, la frase final de Feynman merece conservarse tras este recorte: «Creo que nos estamos acercando a máquinas inteligentes, pero están mostrando las debilidades necesarias de la inteligencia.»
Es difícil no escuchar hoy esa frase de otra manera. Deja espacio para que una máquina sea genuinamente útil, incluso extraordinariamente capaz, sin exigir que sea impecable. La debilidad no cancela automáticamente la inteligencia; nos dice que la propia inteligencia puede tener límites, puntos ciegos y modos de fallo característicos. Para la ingeniería, ese es un punto de partida mucho más útil que fingir que una inteligencia de máquina útil debe convertirse primero en infalible.
El empleado es literal
Esa misma inteligencia tiene un filo: el empleado que hay debajo sigue siendo literal. El empleado sigue el procedimiento que existe realmente, utilizando el estado que existe realmente. No corrige nuestra intención.
Si una instrucción apunta al cajón equivocado, el empleado no sabe de algún modo qué cajón queríamos decir. Si el cajón 500 contiene 915 cuando esperábamos 914, un puntero posterior puede llevar a otro lugar. Si una condición de salto está escrita incorrectamente, el empleado puede seguir perfectamente la rama equivocada. Si una parte del sistema interpreta un valor como un tamaño mientras otra lo interpreta como algo distinto, el empleado no se detiene porque la discrepancia le parezca sospechosa.
Cuando decimos que el empleado está confundido, no queremos decir que el ordenador experimente confusión humana. Queremos decir que el estado, la representación o el procedimiento ya no coinciden con el modelo que el diseñador creía que se estaba aplicando. La máquina puede seguir siendo perfectamente obediente mientras el sistema se vuelve incorrecto.
Los sistemas reales también pueden tener más de un empleado trabajando con los mismos cajones. Uno puede leer un valor mientras otro lo cambia, lo borra o reutiliza el cajón para otra cosa. El primero puede entonces seguir utilizando un valor antiguo o incluso seguir una nota hasta un cajón que ya no pertenece a aquello a lo que creía que pertenecía. Cuando varios empleados pueden acceder a los mismos cajones, quién puede leerlos o cambiarlos, y cuándo, pasa a formar parte de la corrección del procedimiento.
Ahí es donde la ingeniería empieza a ponerse interesante
Muchos fallos difíciles de software pueden reducirse a alguna variante de este problema. Se siguió la ubicación equivocada. Se tomó una decisión utilizando una representación y se realizó una acción utilizando otra. Se comprobó un valor y después cambió antes de usarse. Se trató un registro obsoleto como actual. Una ruta alternativa envió el trabajo por otro camino. Una etapa posterior confió en un significado que una etapa anterior nunca había establecido.
Vistos desde fuera, estos fallos pueden afectar a software sofisticado. Vistos de dentro hacia fuera, las preguntas suelen ser maravillosamente concretas. ¿Qué valor leyó el empleado? ¿Qué cajón nombraba ese valor? ¿Qué instrucción se ejecutó después? ¿Qué condición provocó el salto? ¿Qué estado creía haber recibido la siguiente instrucción?
Es un hábito de ingeniería que nos importa. Cuando una afirmación a nivel de sistema se vuelve vaga, descendemos hasta que el mecanismo vuelve a poder describirse literalmente.
Y ahí es donde entra la seguridad
Un bug normal puede confundir accidentalmente al empleado. Un problema de seguridad se vuelve posible cuando alguien puede influir deliberadamente en el estado o las instrucciones de forma que conduzca a la máquina hacia una consecuencia útil.
Un atacante no necesita que el ordenador se vuelva desobediente. Todo lo contrario. Algunos de los fallos más interesantes ocurren porque el ordenador obedece con demasiada fidelidad: sigue el puntero influido por el atacante, acepta la representación engañosa, toma el salto permitido, ejecuta la operación autorizada o entrega un valor al siguiente componente exactamente como dice el procedimiento.
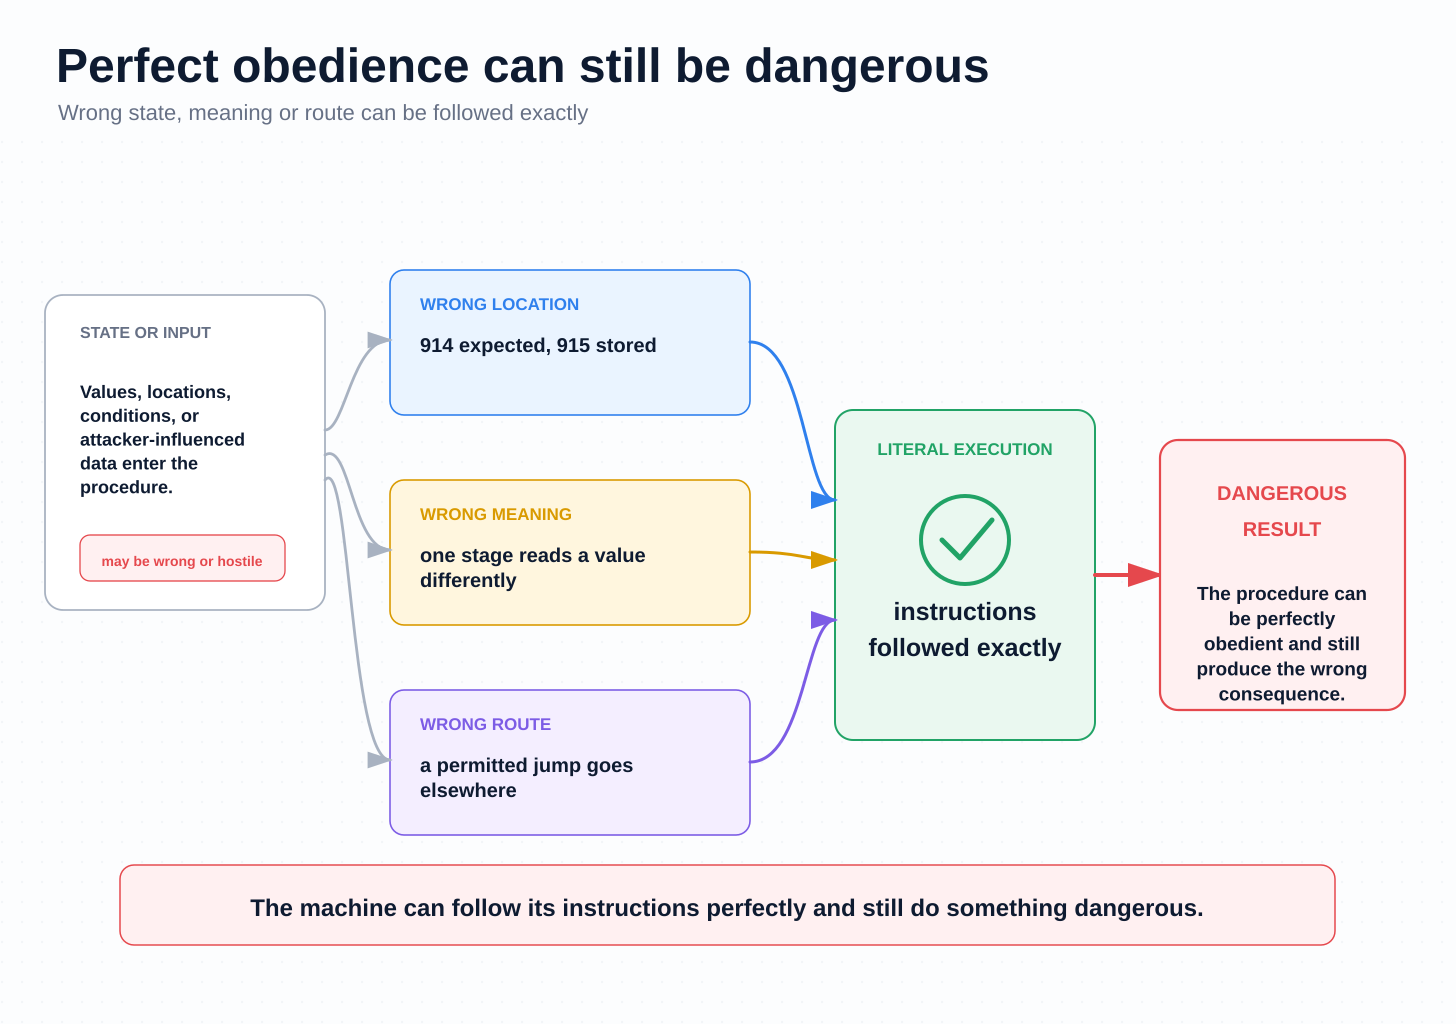
La consecuencia depende entonces de lo que el empleado tenga permitido hacer. Una confusión en una zona temporal y desechable puede ser inocua. La misma confusión cerca de credenciales, estado duradero, datos privados, acceso a la red u otro componente privilegiado puede importar enormemente.
Volveremos a estas distinciones en otros lugares. Este artículo no pretende anticiparlas. Su propósito es darnos un modelo mental común: antes de discutir el nombre de una propiedad de seguridad, preguntemos qué información existe, qué significa, a dónde apunta, qué instrucción se ejecuta después y qué poder es alcanzable desde allí.
Un modelo que esperamos reutilizar
Esperamos que el empleado de archivo se convierta en un lenguaje recurrente en los textos de XMAKYNA porque hace accesibles ideas difíciles sin volverlas infantiles. Un puntero pasa a ser una ubicación anotada. Un salto, un cambio en la nota de «siguiente instrucción». El contador de programa, el marcador de posición del empleado. La memoria, cajones. La ejecución, una secuencia de operaciones diminutas sobre esos cajones.
Una vez establecida esa imagen, los argumentos más avanzados tienen un suelo firme sobre el que apoyarse. Podemos hablar de estado incorrecto, estado obsoleto, representación engañosa, redirección, autoridad y confusión controlada por un atacante sin fingir que el ordenador tiene juicio humano ni que el nombre de una abstracción explica por sí solo el mecanismo.
El modelo es útil cuando la ingeniería difícil empieza a parecer más misteriosa de lo que es. Si quitamos la escala y la falta de familiaridad, sigue siendo, en cierto sentido, un archivador: si acertamos con el estado, la representación y el procedimiento, la máquina hará el trabajo.
Por eso esta conferencia es más que una encantadora explicación antigua de los ordenadores. Nos da una forma duradera de pensar.
Metadatos de la conferencia y nota sobre el nombre
Ponente: Richard P. Feynman. La propia grabación enlazada muestra la fecha 26 de septiembre de 1985 e identifica el contexto como el taller Idiosyncratic Thinking en el Esalen Institute, Big Sur, California.
La conferencia ha circulado con distintos títulos, y algunas referencias publicadas fechan de manera diferente material relacionado con Esalen. La subida enlazada se titula Hardware, Software and Heuristics; Computers From the Inside Out y The Feynman Lecture on Heuristics también aparecen en otros lugares. Aquí nos referimos a la conferencia como Computers From the Inside Out.
Ver la conferencia: Richard Feynman, Computers From the Inside Out (YouTube).
En resumen
Si reducimos lo suficiente un ordenador, queda una imagen sorprendentemente duradera: un empleado de archivo muy rápido y muy literal, con un conjunto efectivamente enorme de cajones numerados y un pequeño repertorio de operaciones. Los valores pueden nombrar otros cajones. Las instrucciones pueden cambiar qué instrucción viene después. El contador de programa es simplemente el marcador de posición del empleado. Un salto cambia ese marcador. Un comportamiento enorme emerge de repetir estos movimientos simples a una velocidad extraordinaria.
El modelo es simple, pero no superficial. Nos recuerda que la máquina actúa sobre el estado y la representación que realmente codificamos, no sobre la intención que esperábamos que de algún modo entendiera. Un empleado confundido es un problema de corrección. Un empleado al que un atacante puede confundir deliberadamente, con autoridad útil asociada, es un problema de seguridad. Esperamos volver a esta idea una y otra vez.