
In den vorherigen Grundlagenartikeln „Wie Computer funktionieren: Feynmans ultraschneller Ablageangestellter“ und „Wie Computer aus Nullen und Einsen Wörter und Bilder machen“ ging es darum, wie ein Computer Anweisungen ausführt und Informationen als gespeicherte Werte darstellt. Diese Informationen zu einem anderen Computer zu übertragen, ist eine andere Aufgabe: Die beiden Maschinen teilen sich keinen Arbeitsspeicher, und eine direkte Verbindung zwischen ihnen muss es nicht geben. Feynmans Ablageangestellter kann eine nummerierte Schublade öffnen, um etwas zu finden, das in seiner Nähe abgelegt wurde. Benötigt er Informationen von einem entfernten Computer, muss er dagegen eine Anfrage verschicken und auf die Antwort warten. Das ähnelt eher einem Brief an ein anderes Büro als dem Öffnen einer zweiten Schublade. Die Verarbeitung kann längst bereit sein weiterzugehen, während die Antwort noch unterwegs ist.
Das Internet ermöglicht solche Vorgänge, indem es Netzwerke verbindet, die von unterschiedlichen Organisationen betrieben werden. Informationen können vom ersten Netzwerk eines Geräts über mehrere weitere Netze zu einem Dienst gelangen, der eine Antwort liefern kann, und anschließend über eine andere Folge von Verbindungen zurückkehren. Wer sowohl den Weg als auch die Systeme versteht, die die Antwort bereitstellen, kann erklären, warum sich der Zugang je nach Standort unterscheidet, weshalb manche Anfragen langsam sind und warum scheinbar unabhängige Dienste gleichzeitig ausfallen können.
Vom Gerät ins größere Netzwerk
Ein Smartphone, Laptop oder anderes Gerät baut zunächst eine lokale Verbindung auf, oft über WLAN, Mobilfunk oder ein Kabel. Von dort leiten nahegelegene Netzwerkgeräte den Datenverkehr in ein größeres Netz weiter. Bei privaten und geschäftlichen Anschlüssen stellt meist ein Internetdienstanbieter (ISP) den Zugang zum übrigen Internet bereit; bei Mobilfunkanschlüssen erfüllt das Netz des jeweiligen Anbieters eine ähnliche Aufgabe. Jeder Anbieter kann Datenverkehr mit anderen Netzen austauschen. So können Verbindungen große Entfernungen und Organisationsgrenzen überwinden, ohne dass zwischen den beiden Endgeräten eine eigens dafür verlegte physische Leitung nötig wäre.
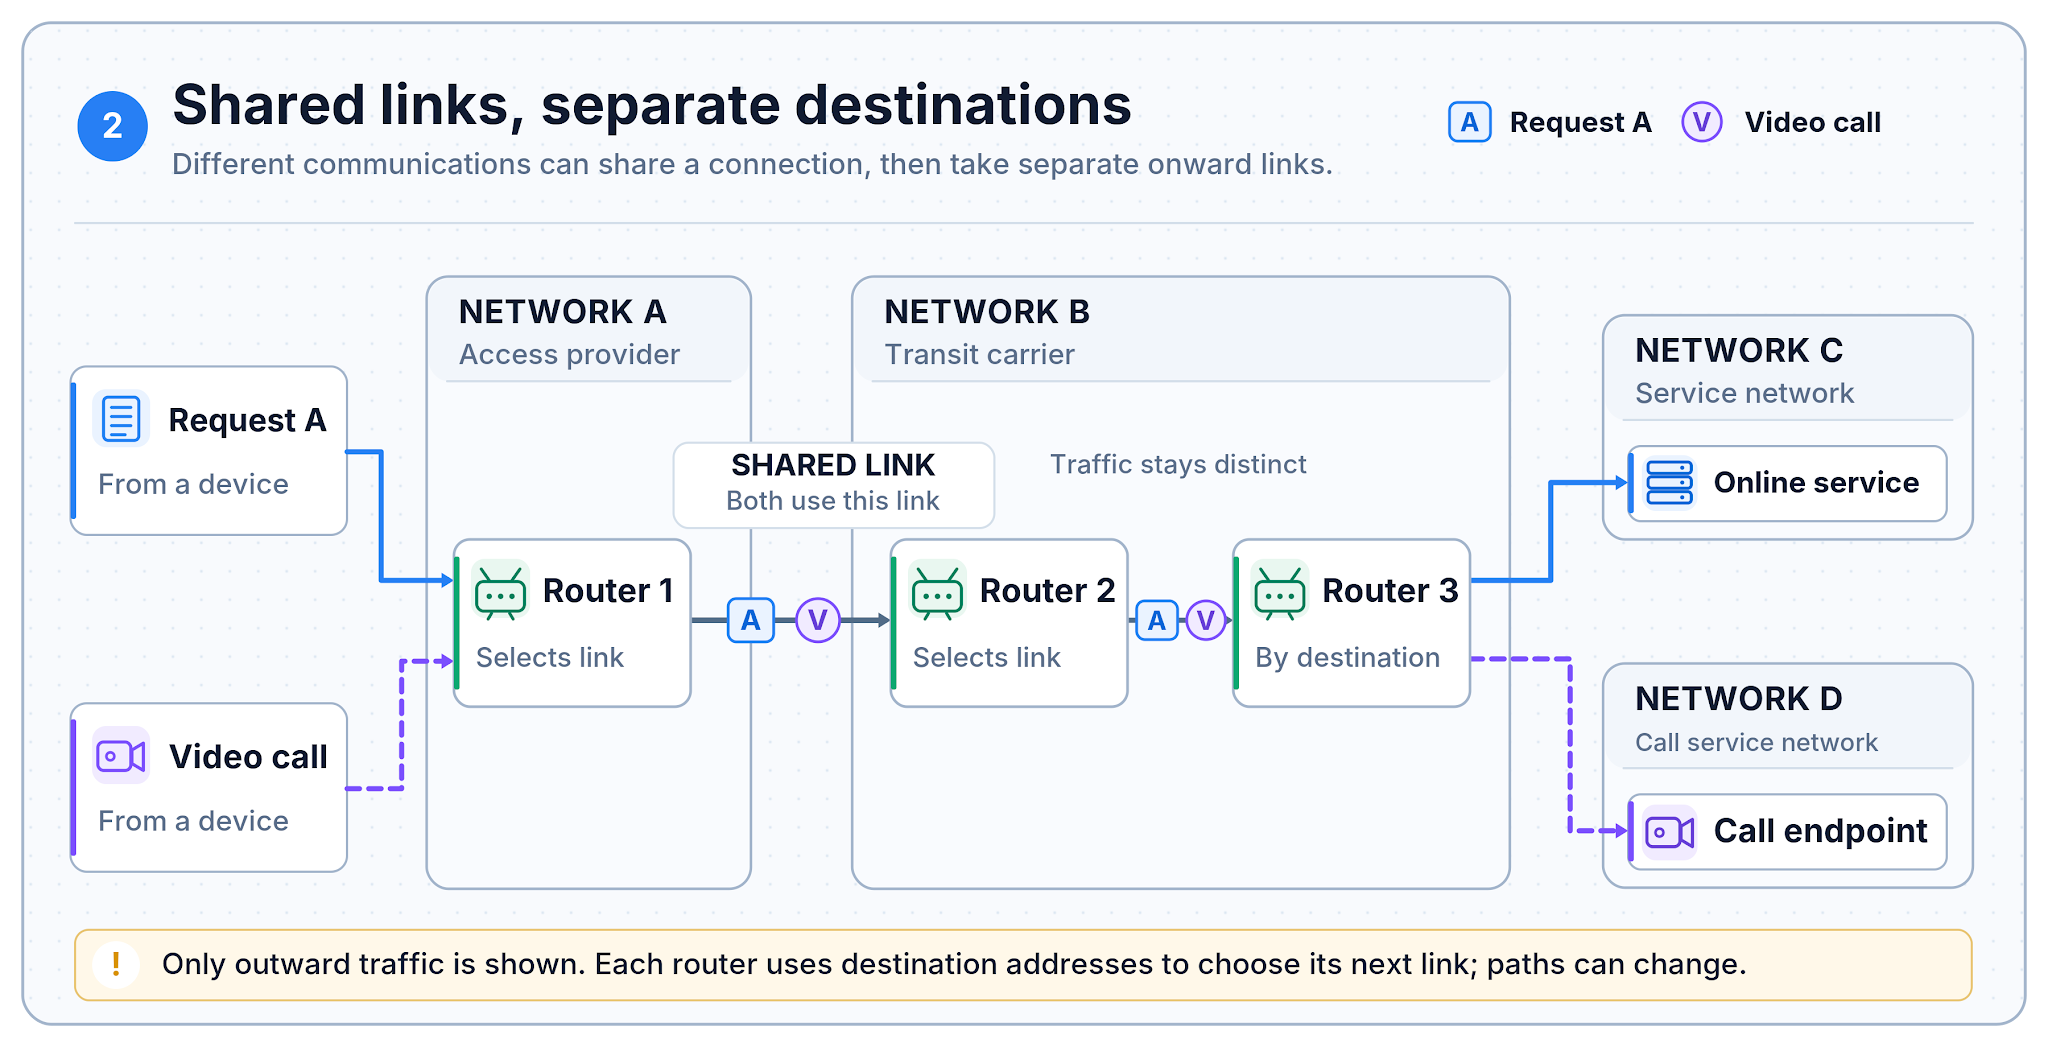
Das Internet funktioniert in diesem Maßstab, weil viele Übertragungen dieselben Leitungen und Geräte nutzen können. Ein Videoanruf, eine Nachricht, ein Dateidownload und eine Anfrage an einen Dienst können sich einen Teil des Netzwerks und damit dessen verfügbare Kapazität teilen. Das Internetprotokoll (IP) stellt Zieladressen bereit, anhand derer Router entscheiden, wohin sie den Verkehr als Nächstes weiterleiten. Ein Dienst kann mehrere Adressen besitzen, und hinter einer einzigen Adresse können mehrere Rechner stehen. Eine Adresse macht die Zustellung möglich, legt aber weder einen eindeutigen physischen Weg noch einen bestimmten Rechner fest.
Wie aus einem Dienstnamen eine Adresse wird
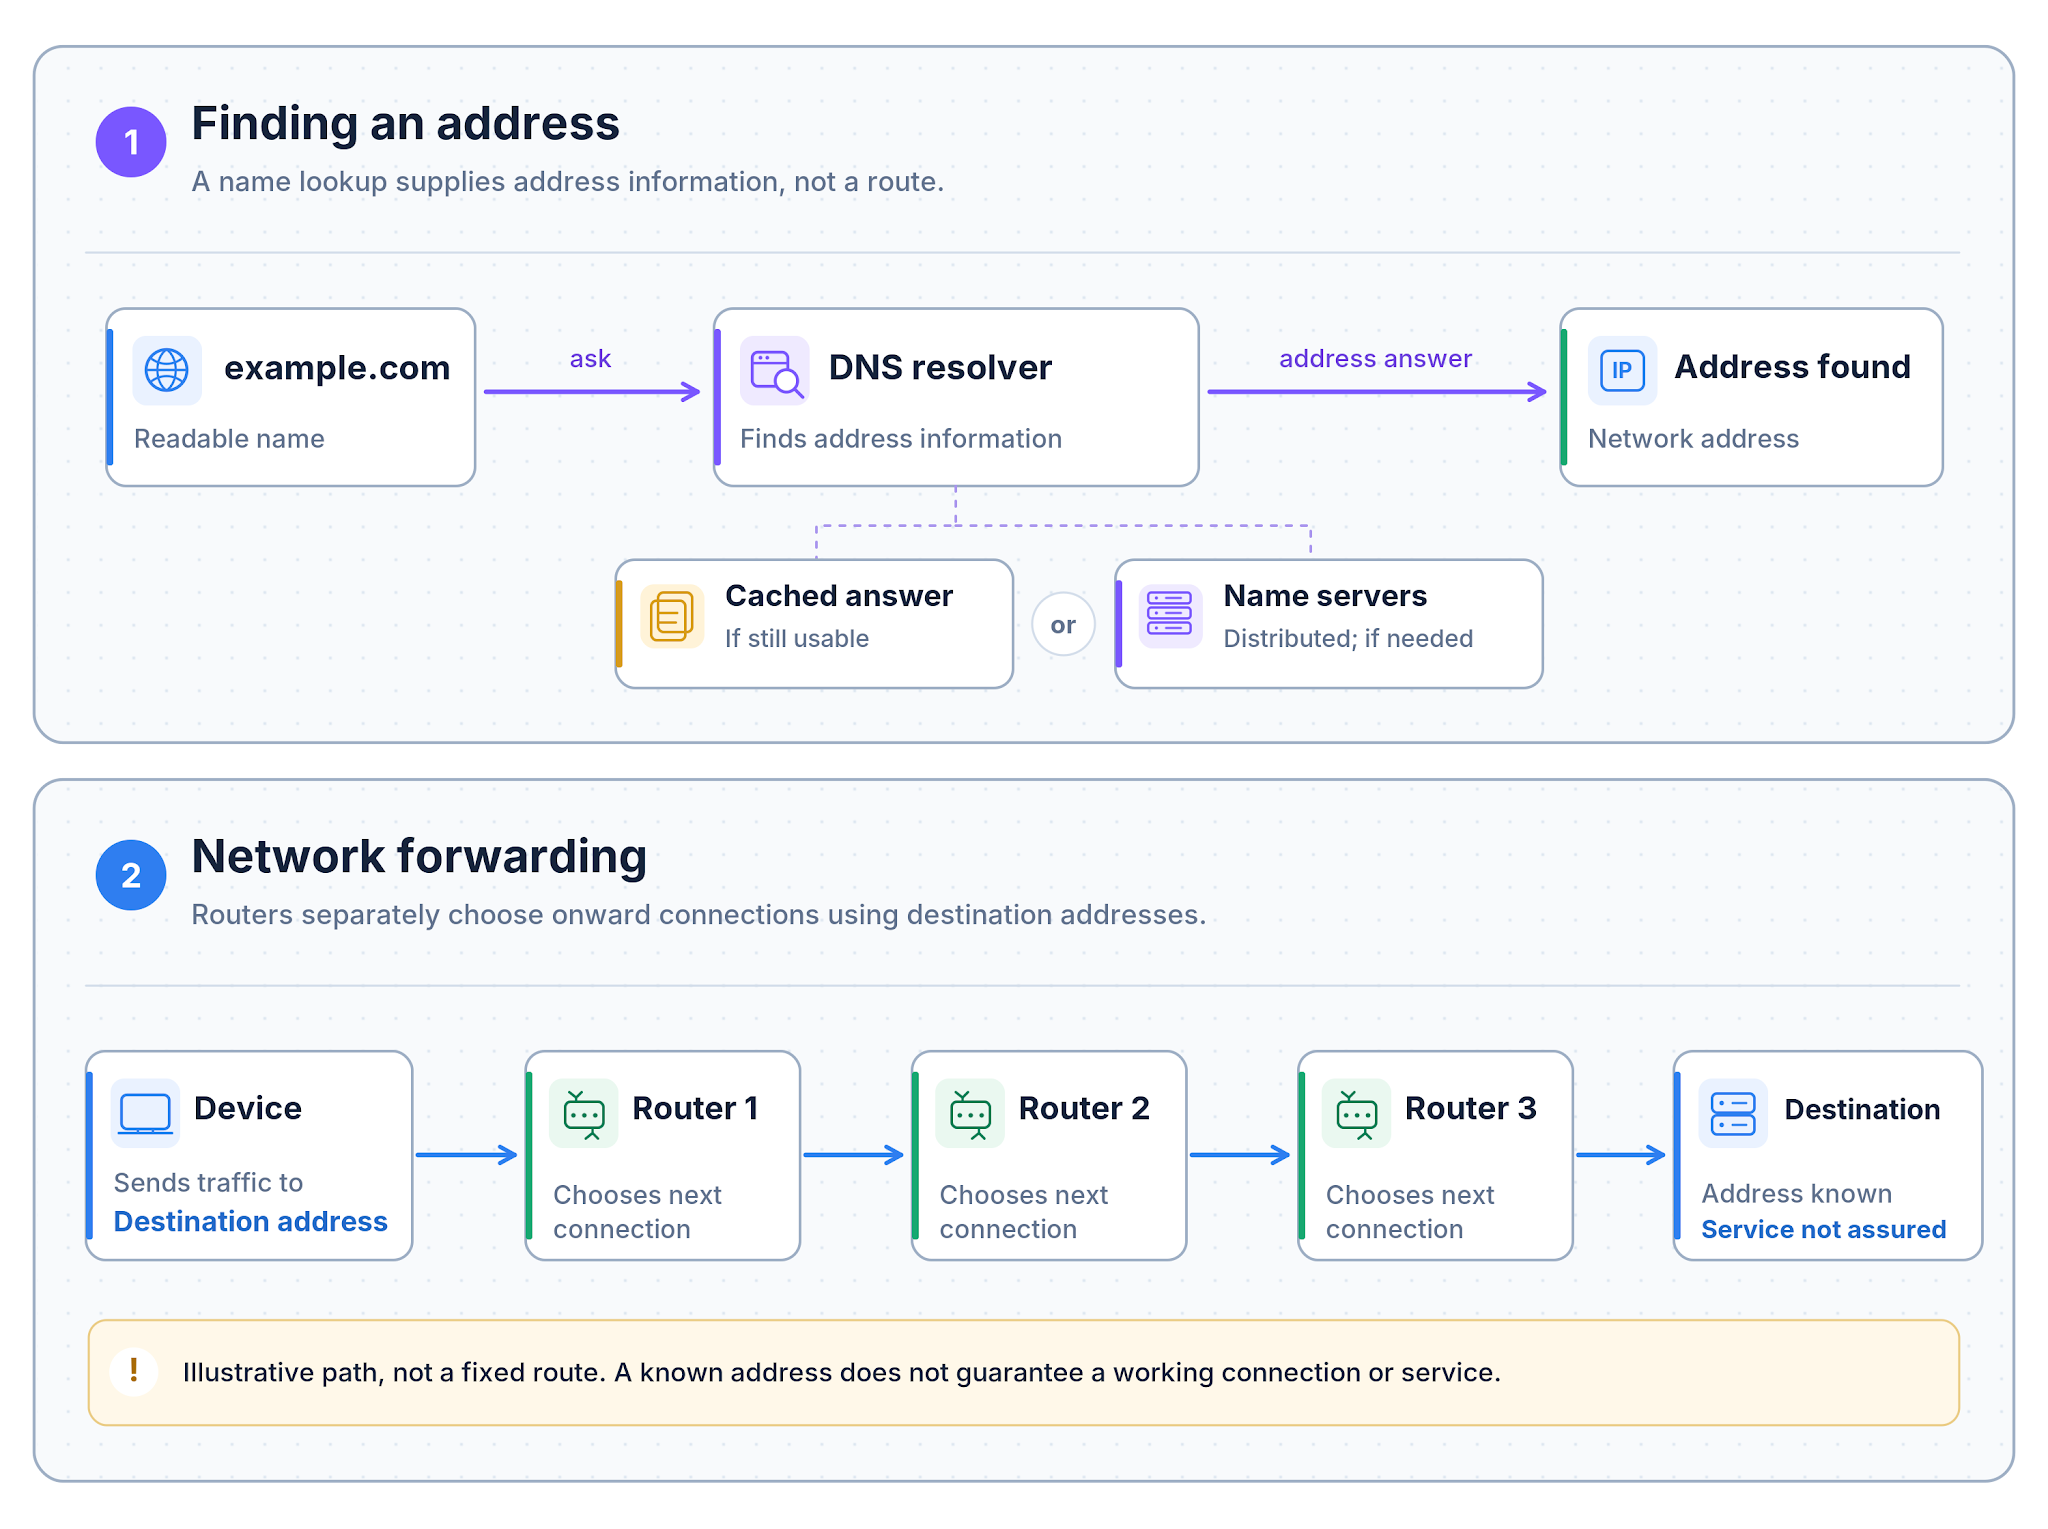
Bevor eine Anwendung einen Dienst mit einem Namen wie example.com erreichen kann, braucht sie normalerweise eine Netzwerkadresse. Das Domain Name System (DNS) hilft, diese Adresse zu finden, ähnlich wie ein Adressverzeichnis den Versand eines Briefs an ein Büro ermöglicht. Die Adresse kann bereits auf dem Gerät gespeichert sein; andernfalls fragt es einen DNS-Resolver. Der Resolver kann eine zwischengespeicherte Antwort zurückgeben oder weitere Nameserver befragen. Namensinformationen sind auf viele Systeme verteilt und liegen nicht in einem einzigen weltweiten Verzeichnis. Für einen Dienst können mehrere gültige Adressen existieren, die sich mit der Zeit ändern.
Ist die benötigte Antwort nicht im Cache vorhanden, können für die Suche weitere Netzwerkabfragen erforderlich sein. Das kostet Zeit, bevor die Anwendung ihre eigentliche Anfrage sendet. Scheitert die Namensauflösung, kann ein Dienst unter seinem Namen unerreichbar sein, obwohl die Zielsysteme einwandfrei arbeiten. Auch mit der Adresse steht der Weg noch nicht fest. Sobald die Anwendung eine Adresse hat, schickt sie den Verkehr zum Ziel; die Router unterwegs wählen anhand ihrer eigenen Routinginformationen die nächsten Verbindungen. Die Namensauflösung bestimmt weder die Route noch, ob der Dienst antwortet.
Wie Netzwerke Informationen weiterleiten
Wenn die Zieladresse bekannt ist, beginnt die Reise über das lokale Gateway des Geräts, meist einen Router. Dieses Gateway leitet den Verkehr an einen weiteren Router weiter, der anhand der Zieladresse und seiner Routinginformationen die nächste Verbindung auswählt. Dabei können Netze mehrerer Organisationen durchlaufen werden: Ein lokaler Anbieter übergibt den Verkehr möglicherweise an einen anderen Netzbetreiber, der ihn zum Netz des Ziels bringt. Jeder Router trifft eine eigene lokale Weiterleitungsentscheidung. Es gibt keine zentrale Leitstelle, die für jede Anfrage den gesamten Weg vorgibt. Unterschiedliche Verbindungen können teilweise dieselben Leitungen nutzen, obwohl sie von verschiedenen Quellen stammen und an unterschiedliche Ziele gehen.
Ein Weiterleitungsschritt von einem Router zum nächsten heißt in der Netzwerktechnik oft Hop. Eine größere Anzahl von Hops bedeutet für sich genommen keine längere Verzögerung. Auch die zurückgelegte Entfernung, verfügbare Verbindungen, Überlastungen und der Standort des antwortenden Systems spielen eine Rolle. Netzwerke tauschen Informationen darüber aus, welche Ziele über welche benachbarten Netze erreichbar sind. Fällt eine Verbindung oder ein Netz aus, können sich diese Angaben ändern; Router können andere Wege wählen, wenn brauchbare Alternativen vorhanden sind und die Richtlinien der Netzbetreiber sie zulassen. Bis solche Informationen aktualisiert sind, kann Zeit vergehen, und für manche Ziele gibt es keinen alternativen Weg. Selbst wenn die Anfrage ihr Ziel erreicht, kann die Antwort über andere Router zurückkommen.
Woher Antworten kommen und warum sie Zeit brauchen
Erreicht eine Anfrage die Infrastruktur für ihr Ziel, muss dort noch ein System die Antwort vorbereiten. Es kann gespeicherte Informationen abrufen, eine Berechnung ausführen, Berechtigungen prüfen oder einen Eintrag aktualisieren. Die Organisation, die den Dienst anbietet, kann die Maschinen selbst betreiben oder einen Hostinganbieter damit beauftragen. Ein funktionierender Netzwerkweg garantiert deshalb noch keine rechtzeitige Antwort: Software, Speicher und andere Systeme können nach dem Eintreffen der Anfrage langsam, überlastet, falsch konfiguriert oder nicht verfügbar sein. Auch bei öffentlich zugänglichen Inhalten kann es Zeit und Netzkapazität verschwenden, immer wieder dasselbe unveränderte Bild oder dieselbe Datei von einem entfernten Rechner anzufordern.
Geeignete Inhalte lassen sich als Kopien an verschiedenen Orten vorhalten. Ein Content Delivery Network (CDN), also ein Netz zur Verteilung von Inhalten, kann manche Anfragen direkt aus einer zwischengespeicherten Kopie bedienen, statt die ursprüngliche Quelle, den sogenannten Origin, zu kontaktieren. Fehlt eine passende Kopie, muss das Auslieferungssystem den Inhalt möglicherweise erst aus einem anderen Cache oder vom Origin holen. Andere Vorgänge, etwa eine Anmeldung, das Ändern gespeicherter Daten oder eine Abfrage aktueller Informationen, erfordern unter Umständen neue Verarbeitung. Die Systeme für Speicherung, Verarbeitung und Auslieferung können verschiedenen Organisationen gehören und trotzdem nach außen wie ein einziger Dienst erscheinen. Danach reist die Antwort durch das Netzwerk zurück zum anfragenden Gerät, das sie interpretiert.
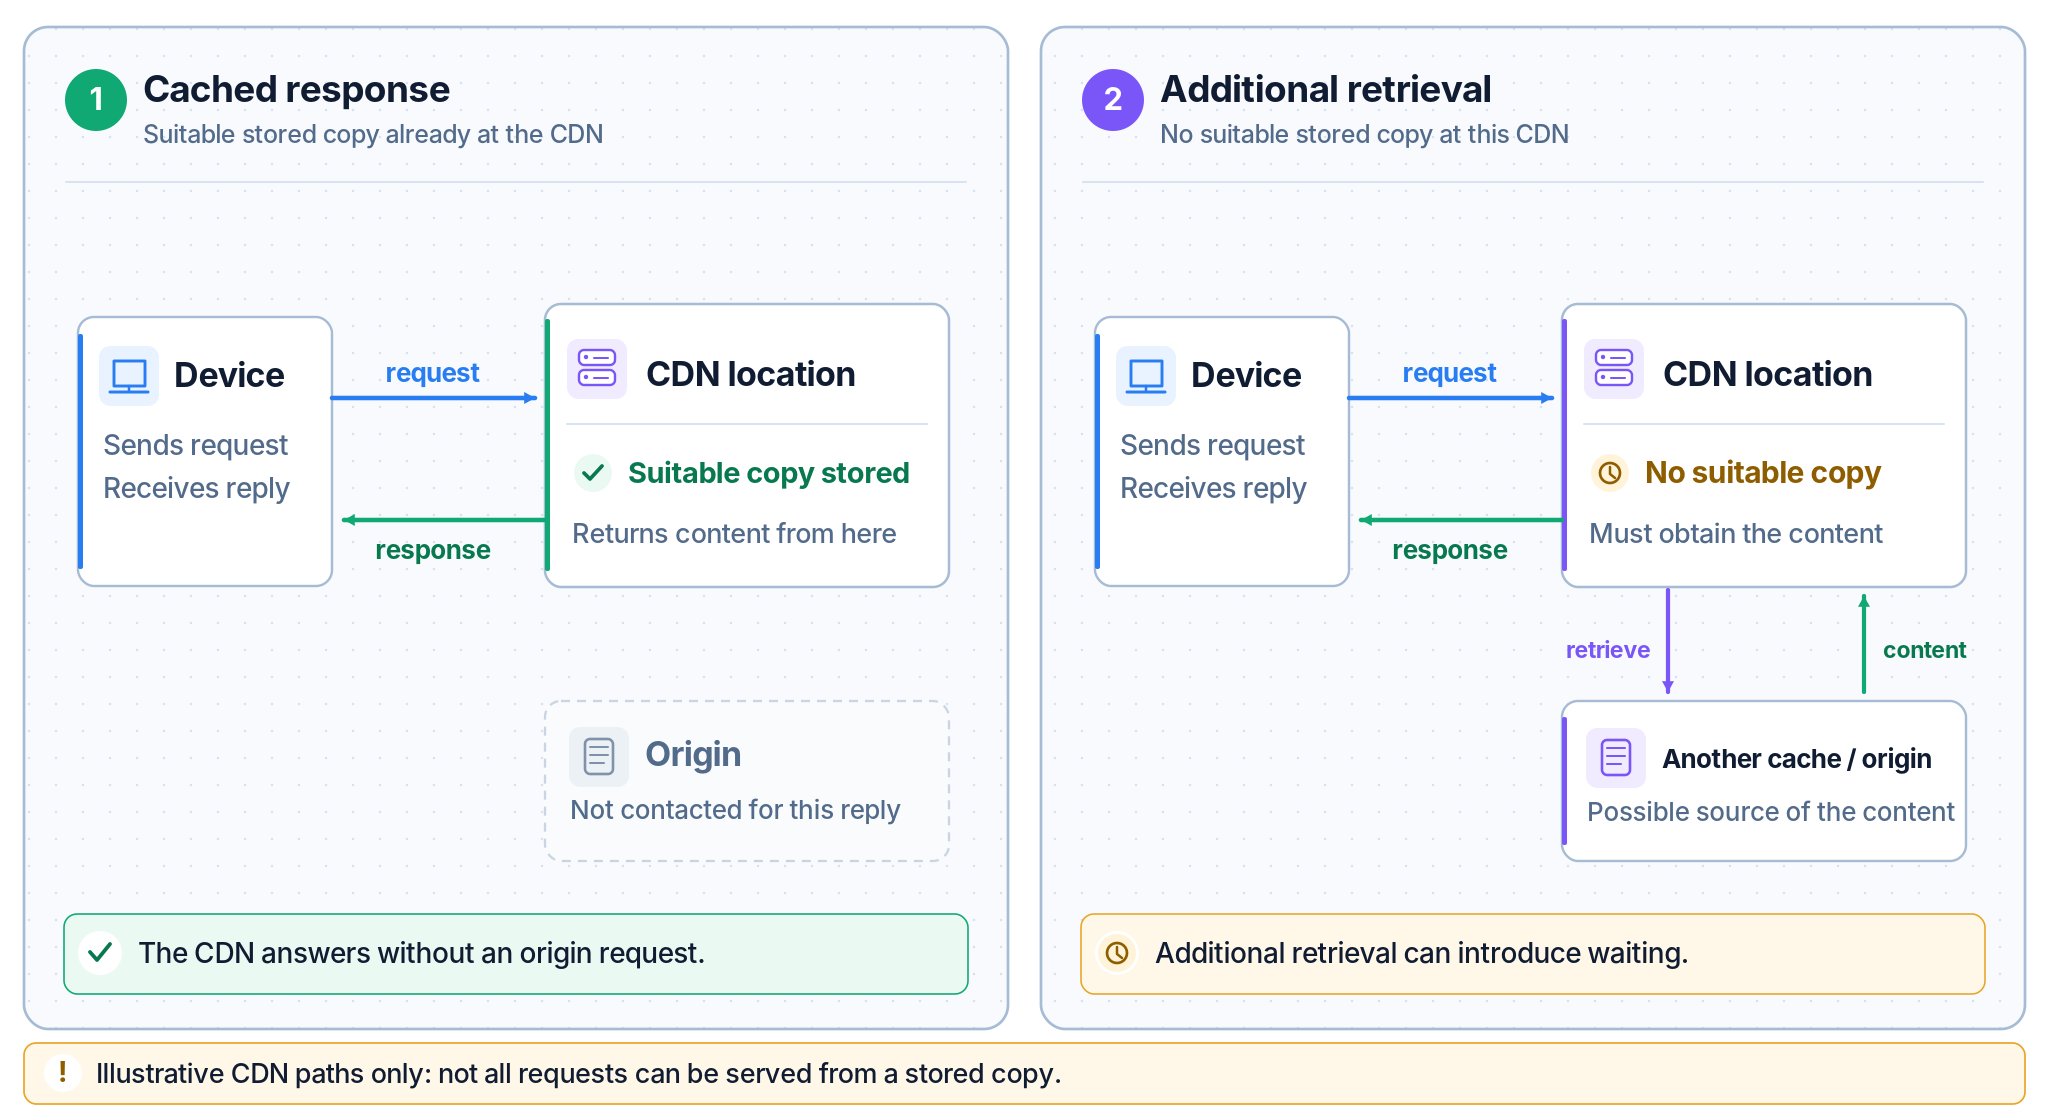
Derselbe Dienst kann an einem Ort schnell und an einem anderen träge wirken. Ein Nutzer erreicht vielleicht einen Server oder einen nahegelegenen CDN-Standort über gut angebundene Netze; bei einem anderen führt die Anfrage über längere, stärker ausgelastete oder weniger direkte Verbindungen. Netzwerklatenz bezeichnet die Zeit, die für die Übertragung im Netz benötigt wird. Sowohl die ausgehende Anfrage als auch die zurückkehrende Antwort tragen zur Wartezeit bei. Der geografisch nächste Server ist deshalb nicht zwangsläufig der am schnellsten erreichbare. Die Anzahl der Router auf dem Weg sagt etwas über die Strecke aus, ersetzt aber nicht die Messung der tatsächlich benötigten Zeit. Fehlt eine passende DNS-Antwort im Cache, kann die Namensauflösung schon vor dem Beginn der eigentlichen Anfrage zusätzliche Wartezeit verursachen.
Zur Gesamtdauer gehört außerdem die Arbeit, die nach Ankunft der Anfrage erledigt werden muss. Das antwortende System muss vielleicht Daten aus einem Speicher lesen, ein Ergebnis erzeugen, einen nicht zwischengespeicherten Inhalt abrufen oder auf einen anderen Dienst warten. Eine Verbindung, die große Datenmengen schnell übertragen kann, beseitigt diese Verzögerungen nicht. Kommt eine Antwort zu spät oder gar nicht, kann die Anwendung eine Zeitüberschreitung melden und je nach Aufbau einen neuen Versuch unternehmen. Wo Informationen gespeichert und verarbeitet werden, beeinflusst daher mehr als die Geschwindigkeit: Es legt fest, welche Systeme verfügbar sein müssen, damit die Anfrage gelingt. Besonders wichtig ist diese Abhängigkeit, wenn mehrere Dienste dieselbe Infrastruktur nutzen.
Warum Dienste gemeinsam ausfallen können
Eine Einkaufswebsite, eine Banking-App und ein Videodienst können unterschiedliche Eigentümer und Aufgaben haben und dennoch von derselben Infrastrukturkomponente abhängen. Anbieter wie Amazon Web Services, Microsoft Azure und Google Cloud stellen Rechen- und Speicherdienste bereit; Cloudflare, Akamai und Amazon CloudFront bieten Formen der Inhaltsauslieferung sowie weitere Netzwerkdienste an. Diese Kategorien können sich überschneiden, und jeder Anbieter betreibt zahlreiche voneinander getrennte Komponenten. Der Name eines Zulieferers belegt deshalb weder eine gemeinsame technische Abhängigkeit noch die Ursache eines bestimmten Ausfalls. Entscheidend ist, welche konkreten Komponenten jeder Dienst benötigt, um einen bestimmten Vorgang auszuführen.
Ein Single Point of Failure (SPoF) ist eine für einen Vorgang notwendige Komponente, für die keine wirksame Alternative existiert. Das muss nicht eine einzelne physische Maschine sein. Eine Plattform kann auf Tausenden Computern laufen und für Identitätsprüfungen, Konfigurationen oder den Zugriff auf gespeicherte Informationen trotzdem von einem einzigen logischen System abhängen. Fällt dieses System aus, können auch intakte Rechner eine Anfrage möglicherweise nicht mehr abschließen. Räumliche Trennung hilft nur, wenn wichtige Abhängigkeiten ausreichend unabhängig sind. Mehrere Rechenzentren können denselben Kontrolldienst benötigen; umgekehrt können mehrere Anwendungen denselben Anbieter nutzen, ohne von den gleichen Komponenten betroffen zu sein. Die Widerstandsfähigkeit hängt davon ab, welche Ausfälle ein System verkraftet, nicht nur davon, wie viele Maschinen oder Standorte es besitzt.
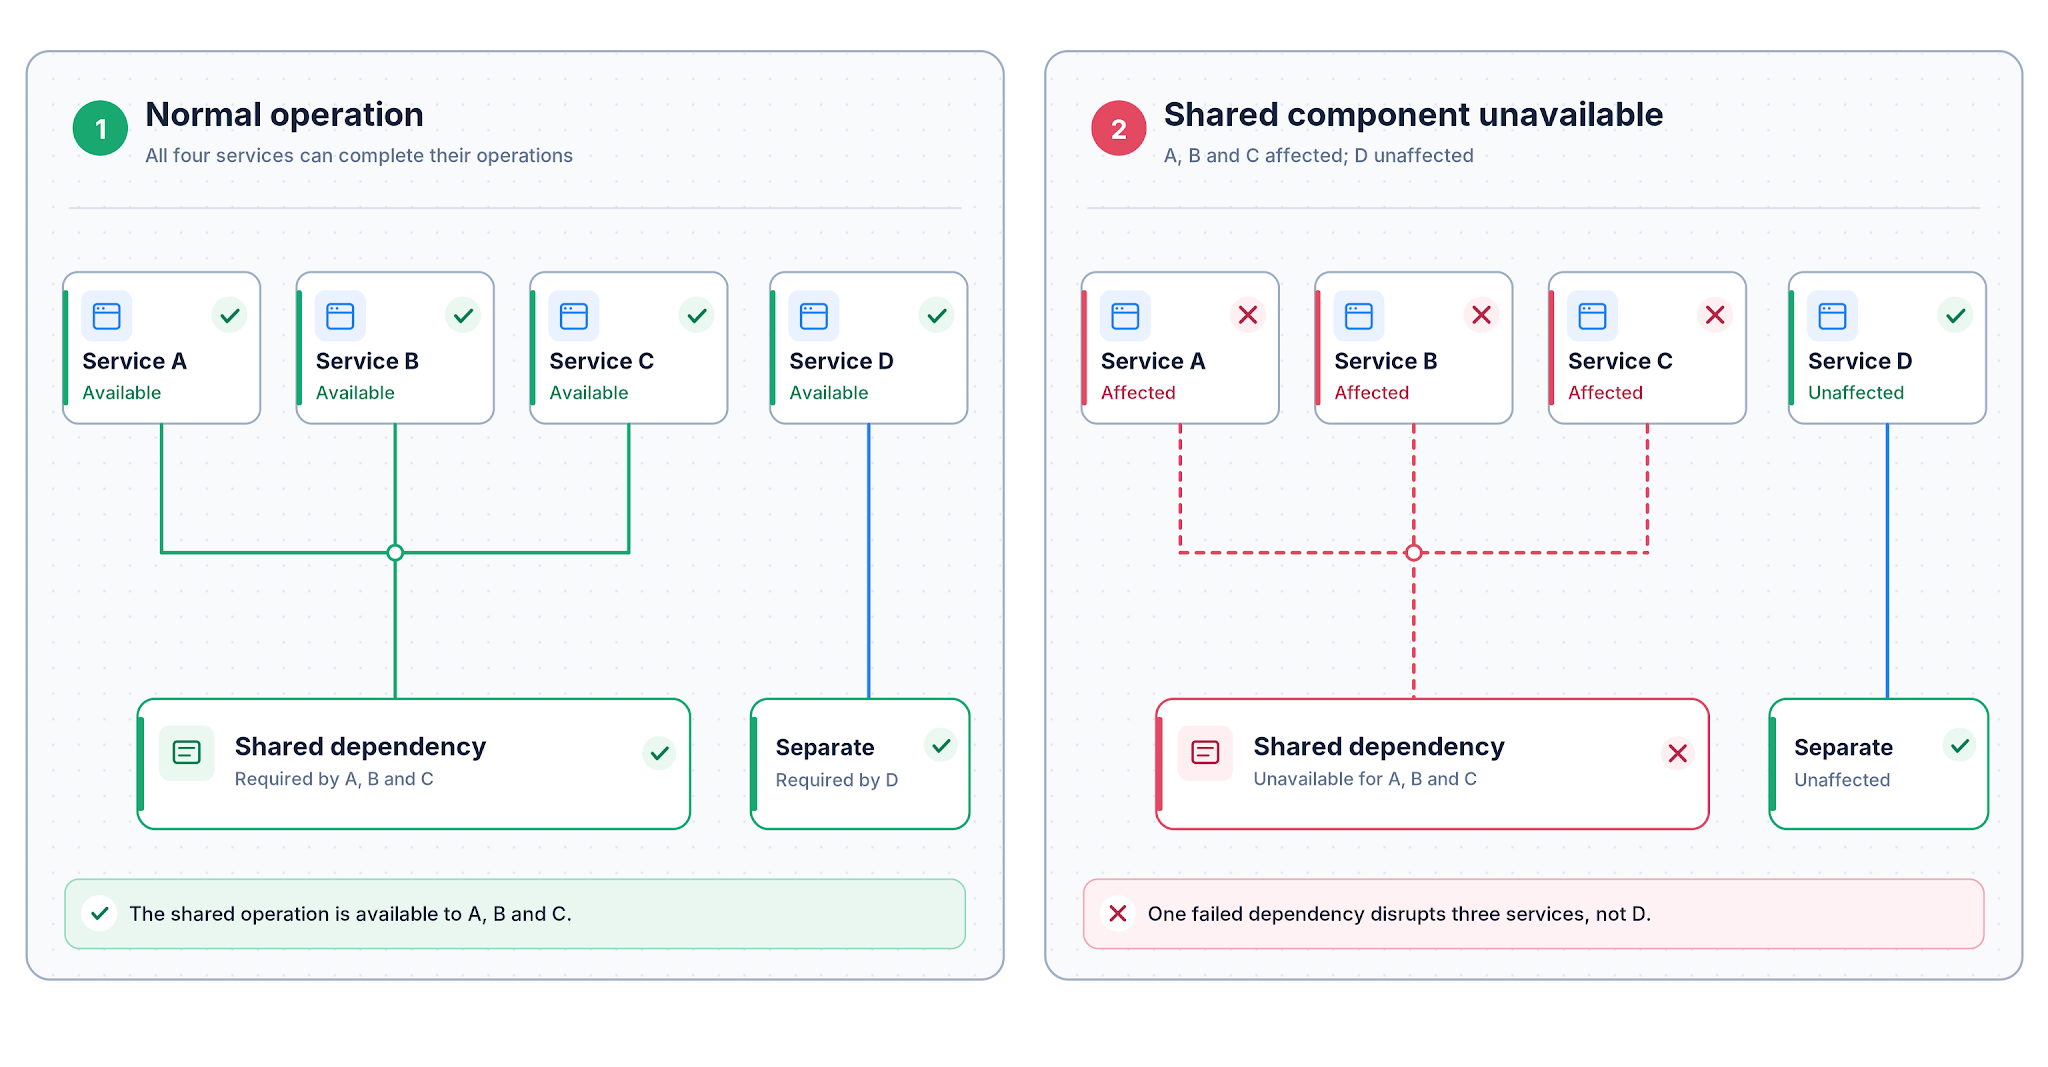
Störungen auf verschiedenen Ebenen können für Nutzer nahezu gleich aussehen. Ein Zugangsnetz kann die Verbindung zu einem eigentlich gesunden Dienst verlieren; Systeme für Namensauflösung, Hosting oder Auslieferung können ausfallen; oder eine einzelne Anwendung kann versagen, obwohl ihr Netz verfügbar bleibt. Ein Ausfall bei mehreren Organisationen deutet daher möglicherweise auf gemeinsame Abhängigkeiten hin, verrät aber für sich genommen nicht, welche Komponente ausgefallen ist.
Am 20. Oktober 2026 störte ein Stromversorgungsereignis Dienste von Google Cloud in der Region London. Zugleich meldeten Kunden von Revolut, Lloyds und HSBC Probleme beim Zugriff auf Bankdienstleistungen. Im vorläufigen Ereignisbericht beschrieb Google, dass der Ausfall einer Rechenzentrumszone auch Dienste in anderen Teilen der Region beeinträchtigte: Arbeit wurde auf die verbleibende Infrastruktur verlagert, während einige regionale Systeme weiterhin Komponenten in der nicht verfügbaren Zone benötigten. Reuters berichtete über einen Zusammenhang zwischen dem Ausfall bei Revolut und dem Vorfall bei Google Cloud. Die genauen technischen Fehlerpfade für die einzelnen Institute wurden öffentlich jedoch nicht nachgewiesen.
Ein solcher Vorfall zeigt, warum zusätzliche Maschinen oder alternative Netzwerkwege allein nicht genügen. Eine andere Route repariert keine ausgefallene Anwendung, und weitere Server helfen womöglich nicht, wenn alle denselben Kontrolldienst benötigen. Eine Ersatzlösung ist nur dann sinnvoll, wenn sie nach dem Ausfall genau jener Abhängigkeit noch funktioniert, gegen die sie schützen soll. Für die Beurteilung der Zuverlässigkeit kommt es darauf an, welche Komponente ausfallen kann, ohne den erwarteten Vorgang des Dienstes zu verhindern.
Wie Nachrichten-Apps an Artikel kommen
Eine Nachrichten-App zeigt anschaulich, wie die Softwarearchitektur die Reichweite eines Ausfalls verändert. Sie kann Beiträge direkt bei mehreren Verlagen abrufen und bei Bedarf jede Quelle einzeln kontaktieren. Ist ein Verlag nicht erreichbar, können Anfragen an die anderen weiterhin funktionieren, sofern ihre Abrufwege intakt bleiben. Dadurch sind die Verlage nicht vollständig unabhängig: Sie können dieselben Namens-, Hosting- oder Auslieferungsdienste nutzen. Die App hat aber keinen zusätzlichen zentralen Remotedienst eingeführt, der für den Abruf aller neuen Beiträge erreichbar sein müsste.
Eine andere Nachrichten-App kann die Beiträge derselben Verlage von einer zentralen Plattform beziehen, die sie sammelt und dann an die App ausliefert. Eine solche Plattform kann viele Server an zahlreichen Orten betreiben. Gibt es für die App aber keinen alternativen Weg, neue Inhalte zu erhalten, wird der zentrale Dienst für jede darüber angezeigte Quelle zur notwendigen Abhängigkeit. Ein Ausfall der Plattform kann neue Beiträge blockieren, obwohl die Verlage selbst weiterarbeiten. Die Oberflächen beider Apps mögen für Leser fast identisch aussehen; der Unterschied liegt darin, welche Systeme für die nächste erfolgreiche Anfrage funktionieren müssen.
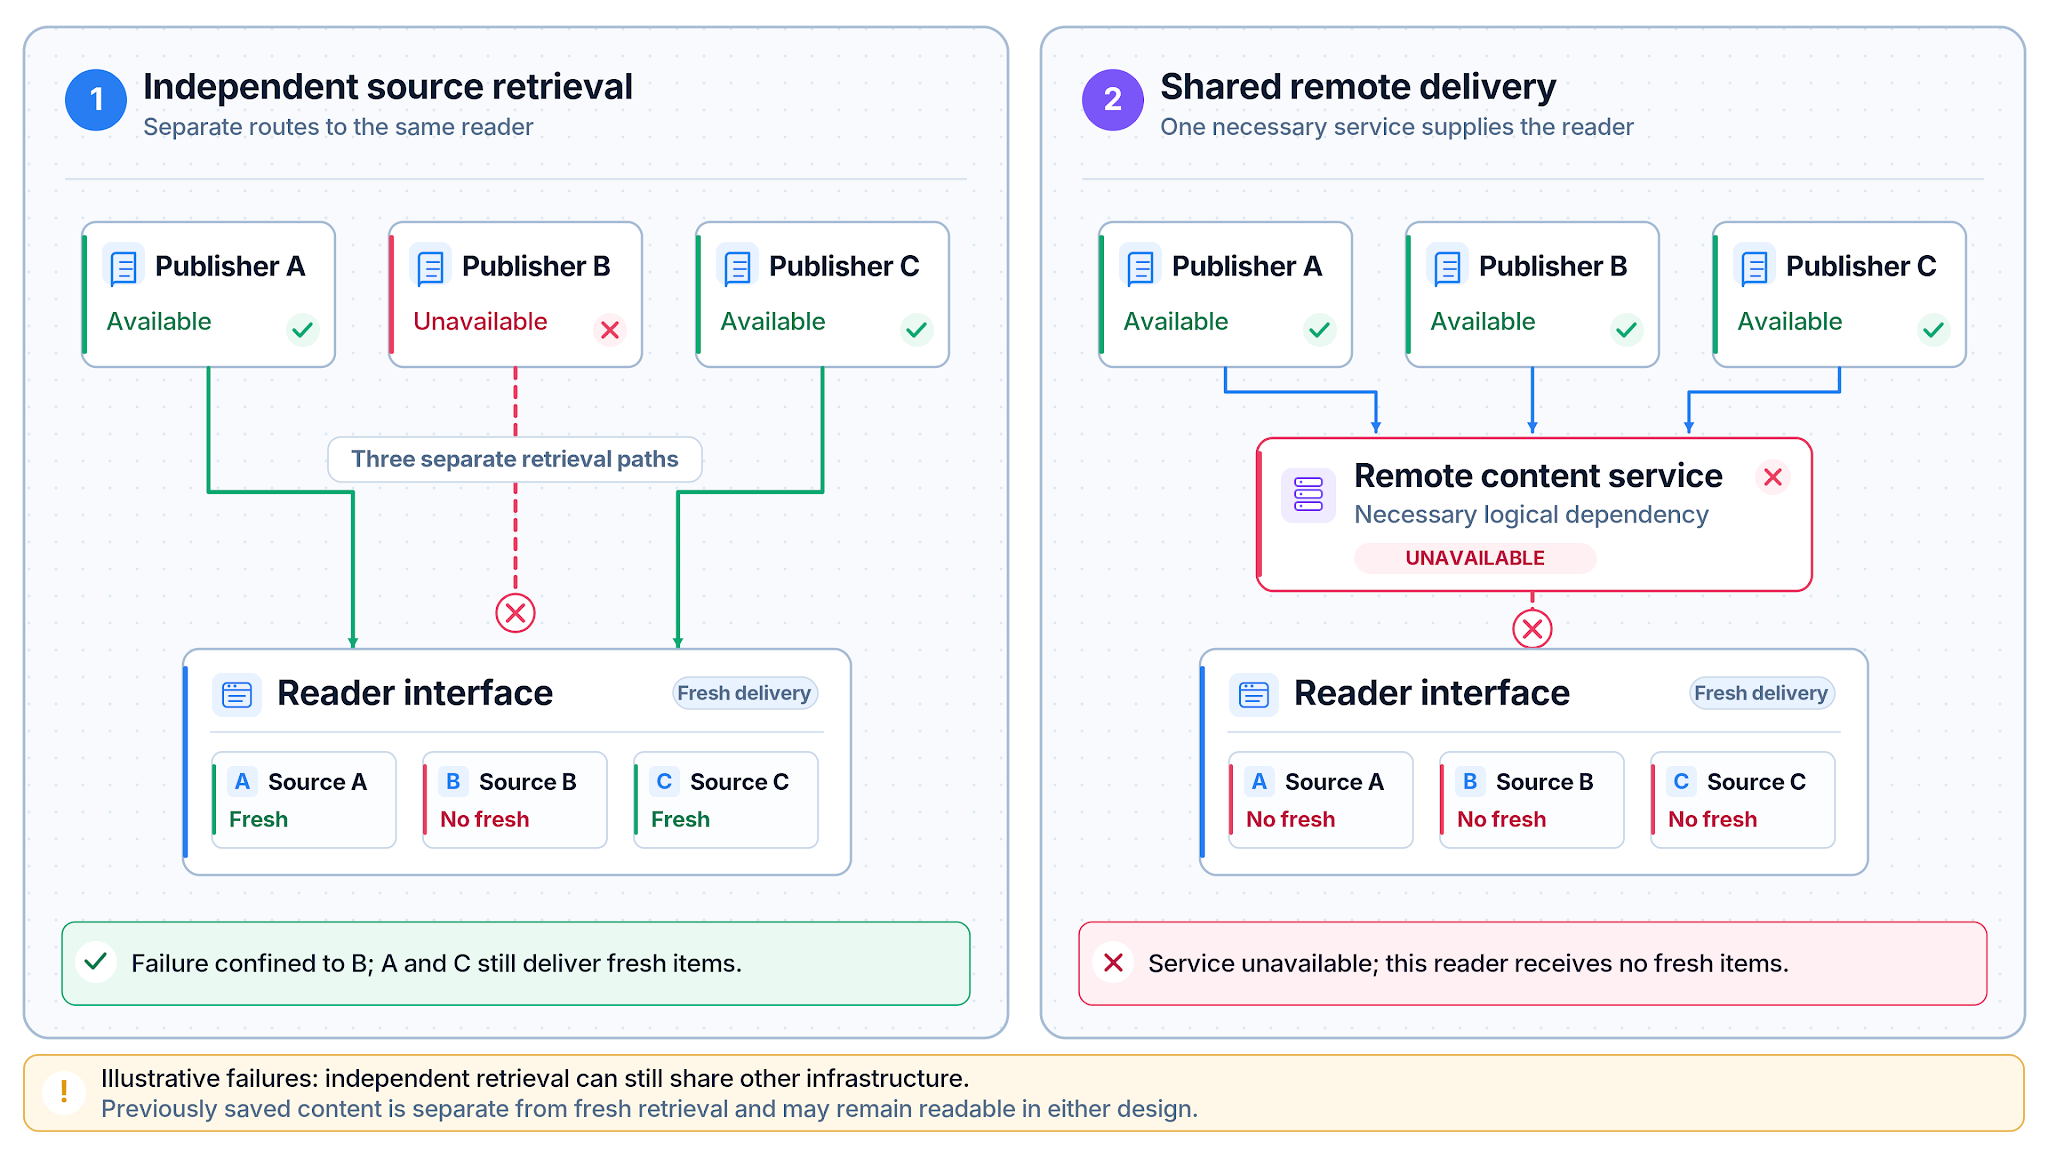
Bereits auf dem Gerät gespeicherte Inhalte können während beider Ausfallarten lesbar bleiben. Das bedeutet allerdings nicht, dass neue Inhalte abrufbar sind. Die Auslieferungsarchitektur beeinflusst außerdem, welche Parteien mit Informationen umgehen. Verschlüsselung schützt üblicherweise die Übertragung durch Netzwerke und beschränkt, was unbeteiligte Betreiber auf dem Weg lesen können. Eine zentrale Plattform, die eine Verbindung beendet oder deren Inhalte verarbeitet, kann die von ihr ausgelieferten Daten dennoch einsehen. Verschlüsselung während der Übertragung entscheidet weder darüber, ob diese Plattform vertrauenswürdig ist, noch darüber, ob die Informationen richtig sind. Für die Verfügbarkeit und den Umgang mit Daten ist dieser Unterschied wichtig, auch wenn die Oberfläche nichts davon erkennen lässt.
Unterm Strich
Internetzugang setzt mehr voraus als eine funktionierende Verbindung des Geräts. Jede brauchbare Antwort erfordert einen Weg durch unabhängig betriebene Netze und eine Reihe von Systemen, die die Antwort tatsächlich liefern können. Verzögerungen können auf beiden Seiten dieser Kette entstehen; Ausfälle breiten sich so weit aus, wie notwendige Abhängigkeiten betroffen sind. Gerade dort, wo die Architektur am wenigsten sichtbar ist, spielt sie eine entscheidende Rolle: Mehrere Organisationen können von einer kritischen Komponente abhängen, während eine einzelne Anwendung zuvor getrennte Quellen zu einer einzigen Abhängigkeit bündelt. Wer weiß, woher eine Antwort wirklich kommt und was ihre Ankunft verhindern könnte, kann scheinbar unverbundene Ausfälle besser verstehen und technische Entwürfe fundierter beurteilen.
Wichtige Begriffe
| Nr. | Begriff | Bedeutung |
|---|---|---|
| 1 | Content Delivery Network (CDN) | Kann passende Inhaltskopien an verschiedenen Orten bereitstellen, statt stets die ursprüngliche Quelle zu kontaktieren. |
| 2 | Domain Name System (DNS) | Hilft, zu einem Namen wie example.com eine Adresse zu finden, legt aber die Route nicht fest. |
| 3 | Internetdienstanbieter (ISP) | Das Unternehmen, das die Verbindung zum größeren Internet bereitstellt. |
| 4 | Internetprotokoll (IP) | Das Adressierungssystem, das Informationen durch verschiedene Netze zu ihrem Ziel gelangen lässt. |
| 5 | Single Point of Failure (SPoF) | Eine für einen Vorgang notwendige Komponente ohne wirksame Alternative. Fällt sie aus, kann der Vorgang nicht abgeschlossen werden. |
Quellen
- Google Cloud Service Health (22. Oktober 2026). Vorläufiger Bericht über die Störung vom 20. Oktober in der Region europe-west2. ↗
- Reuters (21. Oktober 2026). „Europe's financial regulators query Google over cloud outage that hit banks“. ↗
- Synergy Research Group (30. Juli 2026). „Q2 Cloud Market Passes $143 Billion; Highest Growth Rate in Eight Years“. Weltweite Umsatzanteile bei Cloud-Infrastrukturdiensten im zweiten Quartal 2026: Amazon 28 %, Microsoft 20 %, Google 15 %. ↗
- W3Techs (abgerufen am 22. Oktober 2026). „Usage statistics and market shares of reverse proxy services for websites“. Erfasst die beobachtete Nutzung von Diensten wie Cloudflare, Amazon CloudFront, Fastly und Akamai auf Websites, nicht Umsatzanteile oder Verkehrsanteile von CDNs. ↗