
⚠️ Algunos pasajes profundizan en detalles técnicos. El símbolo ⚠️ señala párrafos o secciones opcionales. Puede saltárselos si prefiere una explicación general, sin perder el argumento principal.
Introducción
El software puede parecer terminado mucho antes de que se haya determinado su comportamiento en condiciones adversas. Las herramientas con IA pueden ayudar a crear interfaces y funcionalidades rápidamente, pero una demostración solo prueba las rutas preseleccionadas. Aporta poca información sobre si se rechaza una solicitud de la cuenta incorrecta, si un archivo con formato incorrecto puede provocar un fallo grave o si una dependencia fallida deja información expuesta. Demostrar un comportamiento útil y establecer límites fiables requiere pruebas diferentes.
Un sistema debe respetar sus límites a pesar de las instrucciones erróneas, el robo de credenciales, los cambios de estado y los intentos deliberados de provocar su fallo. Estos límites se extienden más allá de las funcionalidades visibles de la aplicación, abarcando sistemas de identidad, servicios privilegiados, bibliotecas, sistemas operativos, hardware y mantenimiento. Cada componente puede parecer funcionar correctamente, pero una decisión errónea entre ellos puede dar lugar a un resultado perjudicial.
La seguridad se suele abordar en términos de confidencialidad, integridad y disponibilidad: prevenir la divulgación no autorizada, prevenir la alteración no autorizada y mantener los servicios utilizables bajo condiciones definidas. Estas etiquetas identifican resultados, no medidas de seguridad. Un historial médico, un saldo de cuenta y un horario de transporte tienen reglas y consecuencias diferentes. El trabajo comienza por identificar qué debe protegerse, qué acciones podrían infringir sus requisitos y qué rutas podrían seguir dichas acciones. Recopilar y conservar información menos sensible también puede reducir el daño de una posterior violación de seguridad, incluso cuando los controles de acceso son sólidos. [1]
Un control de seguridad solo es útil en la medida en que regula las operaciones. Un sitio web puede bloquear una descarga no autorizada, mientras que una función de exportación libera el mismo registro. El cifrado puede proteger un archivo, pero su clave de descifrado es accesible para terceros no autorizados. Una aplicación puede aprobar un archivo y posteriormente abrir otro con el mismo nombre. En cada caso, una medida de seguridad local puede indicar que la operación completa está protegida cuando no lo está.
Un modelo de amenazas identifica qué necesita protección, qué puede modificar un atacante, dónde se toman decisiones privilegiadas y qué supuestos podrían fallar. Ayuda a exponer posibles vías de daño sin pretender predecir todos los ataques. [2]
Identificar esas rutas también revela la superficie de ataque del sistema: los puntos por donde un atacante podría introducir datos, solicitar una operación u obtener información. Los servicios de red, las interfaces de inicio de sesión y administración, y las funciones de importación de archivos son posibles puntos de entrada, incluso cuando no son evidentes en la pantalla. Reducir esta superficie implica deshabilitar funciones y servicios innecesarios, limitar quién o qué puede acceder a los que permanecen y restringir los permisos que no necesitan. Menos rutas expuestas pueden reducir las oportunidades de ataque, pero las restantes aún requieren controles y mantenimiento rigurosos.
Donde la seguridad falla en primer lugar
Muchos incidentes graves no requieren técnicas extraordinarias. Siguen existiendo cuentas con contraseñas proporcionadas por el fabricante, compartidas entre usuarios o reutilizadas en servicios no relacionados. Una vez que un atacante descubre una contraseña de este tipo, el sistema puede aceptar el inicio de sesión tal como fue diseñado. Los intentos de adivinar contraseñas, los intentos automatizados con credenciales filtradas y las solicitudes fraudulentas de códigos de un solo uso explotan las vulnerabilidades relacionadas con la identidad, en lugar de los errores en el código que verifica las contraseñas. Las credenciales únicas y difíciles de adivinar, una sólida recuperación de cuentas, los límites a la frecuencia de intentos y los métodos de inicio de sesión más robustos pueden reducir estas oportunidades. La autenticación multifactor y las claves de acceso ofrecen una protección importante, pero ningún método de inicio de sesión puede determinar de forma independiente si una instrucción emitida después del inicio de sesión es sensata o legítima. [3] [4]
A veces, las personas olvidan su contraseña o pierden el dispositivo que usan para iniciar sesión. Un servicio debe ofrecer una forma de recuperar el acceso, pero también debe distinguir al titular legítimo de la cuenta de alguien que intenta usurparla. Si restablecer el acceso solo requiere información que otros pueden obtener fácilmente, un impostor podría eludir incluso las medidas de seguridad más estrictas. Por lo tanto, la recuperación de la cuenta debe proporcionar una vía práctica para que los usuarios legítimos regresen sin facilitar el acceso a los atacantes.
Iniciar sesión es solo el comienzo de la protección de una cuenta. Para evitar solicitar una contraseña o clave de acceso para cada acción, muchos servicios emiten un identificador de sesión o token de acceso que representa una sesión autenticada. Si un atacante obtiene una credencial reutilizable de este tipo, el servicio puede aceptar solicitudes como si fuera la cuenta que ha iniciado sesión, sin requerir nuevamente los factores de inicio de sesión originales. Esto se conoce como secuestro de sesión. Por lo tanto, la seguridad depende de cómo se emiten, almacenan, limitan, expiran y revocan las sesiones, especialmente después de una posible vulneración o recuperación de la cuenta. La protección sólida del inicio de sesión y la protección de la autoridad que se conserva después de iniciar sesión son responsabilidades distintas. [5]
La ingeniería social ataca el factor humano en la toma de decisiones. Un mensaje puede afirmar que un proveedor ha cambiado sus datos bancarios, que una cuenta debe verificarse urgentemente o que un documento está disponible tras una página de inicio de sesión. El enlace malicioso puede conducir a una imitación convincente de un servicio legítimo, o una descarga puede intentar explotar una aplicación vulnerable. Simplemente abrir una dirección web no equivale a entregar una cuenta o infectar un ordenador: el resultado depende del destino, las protecciones del navegador y del dispositivo, la versión del software y lo que ocurra a continuación. La distinción importante radica entre una página que llega a través de una conexión protegida y la fiabilidad de dicha página. El cifrado puede proteger los datos en tránsito hacia el sitio web contactado; sin embargo, no puede garantizar que se trate del sitio que la persona pretendía visitar. [3]
El phishing no se reduce simplemente a comprobar si una persona puede reconocer un mensaje sospechoso. El SoK de Zhuo y sus colegas de 2023 revisó 52 estudios empíricos y organizó los factores asociados a la susceptibilidad en torno a las características individuales, las condiciones situacionales y las circunstancias en las que se recibe un mensaje. Su síntesis no respalda un perfil universal de quién será engañado. Por lo tanto, la protección combina una autenticación adecuada, un diseño de interfaz apropiado, procedimientos de confirmación para las instrucciones pertinentes y capacitación, en lugar de asumir que la vigilancia por sí sola siempre tendrá éxito. [6]
La configuración puede exponer un sistema innecesariamente o limitar el alcance de un atacante. Una carpeta destinada a un equipo puede quedar pública, una interfaz de administración puede ser accesible desde internet cuando debería ser interna, una base de datos puede conservar credenciales predeterminadas o un entorno de prueba puede contener datos reales con restricciones menos estrictas. Estas son configuraciones erróneas: el software puede comportarse exactamente como se programó, pero su configuración permite accesos u operaciones no previstas. Las configuraciones predeterminadas inseguras, la copia de configuraciones y las excepciones acumuladas contribuyen al riesgo.
La configuración deliberada puede, en cambio, reducir la superficie de ataque. Esto se conoce como endurecimiento: habilitar solo los servicios y capacidades necesarios, restringir su acceso y verificar que las restricciones surtan efecto. Un servicio SSH utilizado para administrar un servidor de forma remota, por ejemplo, puede limitarse a cuentas autorizadas y rutas de red aprobadas, configurarse para impedir el inicio de sesión directo como root en sistemas tipo Unix y, cuando sea apropiado, utilizar el inicio de sesión basado en claves en lugar de contraseñas. Si no se necesita la administración remota, SSH puede deshabilitarse por completo. Estas medidas eliminan o limitan las formas de acceder al servicio, pero no garantizan que el código restante esté libre de vulnerabilidades. El endurecimiento también debe preservar el acceso legítimo y verificarse en el sistema implementado. [4]
Las credenciales son más amplias que las contraseñas. Los servicios de software utilizan claves secretas y tokens de acceso para comunicarse entre sí, y los empleados o contratistas pueden tener cuentas administrativas con gran capacidad de acceso. Una clave publicada accidentalmente en un repositorio de código, incluida en un registro o conservada tras la finalización del contrato de un proveedor puede otorgar acceso sin necesidad de intentar descifrar la encriptación. La encriptación no puede impedir la divulgación si un atacante obtiene la clave de descifrado necesaria o controla un servicio autorizado para revelar el texto sin cifrar. Por lo tanto, la protección de la información almacenada depende del manejo de claves y del acceso al descifrado, no solo del algoritmo. Una organización también puede otorgar a su personal de rutina mucho más acceso del que necesitan para sus funciones. La respuesta adecuada implica controlar dónde se almacenan las credenciales, limitar su alcance, retirarlas cuando ya no sean necesarias y poder identificar usos sospechosos. Los registros pueden ayudar a determinar qué sucedió, aunque por sí solos no pueden prevenir el mal uso y pueden introducir información confidencial si se diseñan de forma negligente. La preocupación subyacente es la misma que con las contraseñas predeterminadas: una credencial técnicamente válida puede otorgar autoridad mucho más allá del propósito para el que debería haberse emitido. [2]
Estos casos comparten una característica importante: una credencial aceptada, un mensaje plausible o una configuración permisiva pueden dar lugar a una acción no autorizada. Proteger la decisión implica más que simplemente advertir a los usuarios que tengan cuidado. Los servicios pueden limitar las conjeturas, hacer que los permisos de alto riesgo sean excepcionales y proporcionar confirmación independiente de los cambios consecuentes. Otra dificultad reside en garantizar que estos controles rijan la operación real, incluso cuando un componente con mayores privilegios actúa en nombre de un tercero.
Identidad, autorización y autoridad delegada
La autenticación establece de qué cuenta u otra identidad parece provenir una solicitud. La autorización decide qué puede hacer esa identidad con un registro u operación en particular. Un empleado puede haber iniciado sesión correctamente y aun así no tener derecho a leer los archivos de otro empleado. Conocer un número de registro o poseer un enlace no implica, por sí solo, permiso para recuperar el registro. Un sistema que oculta un botón de exportación pero deja una interfaz subyacente libre para exportar la misma información ha protegido la pantalla, no la operación. Cada ruta relevante, incluidas las solicitudes directas, los procesos en segundo plano y los servicios internos, debe llevar la decisión de permiso necesaria hasta el punto en que se produce el efecto protegido. [7]
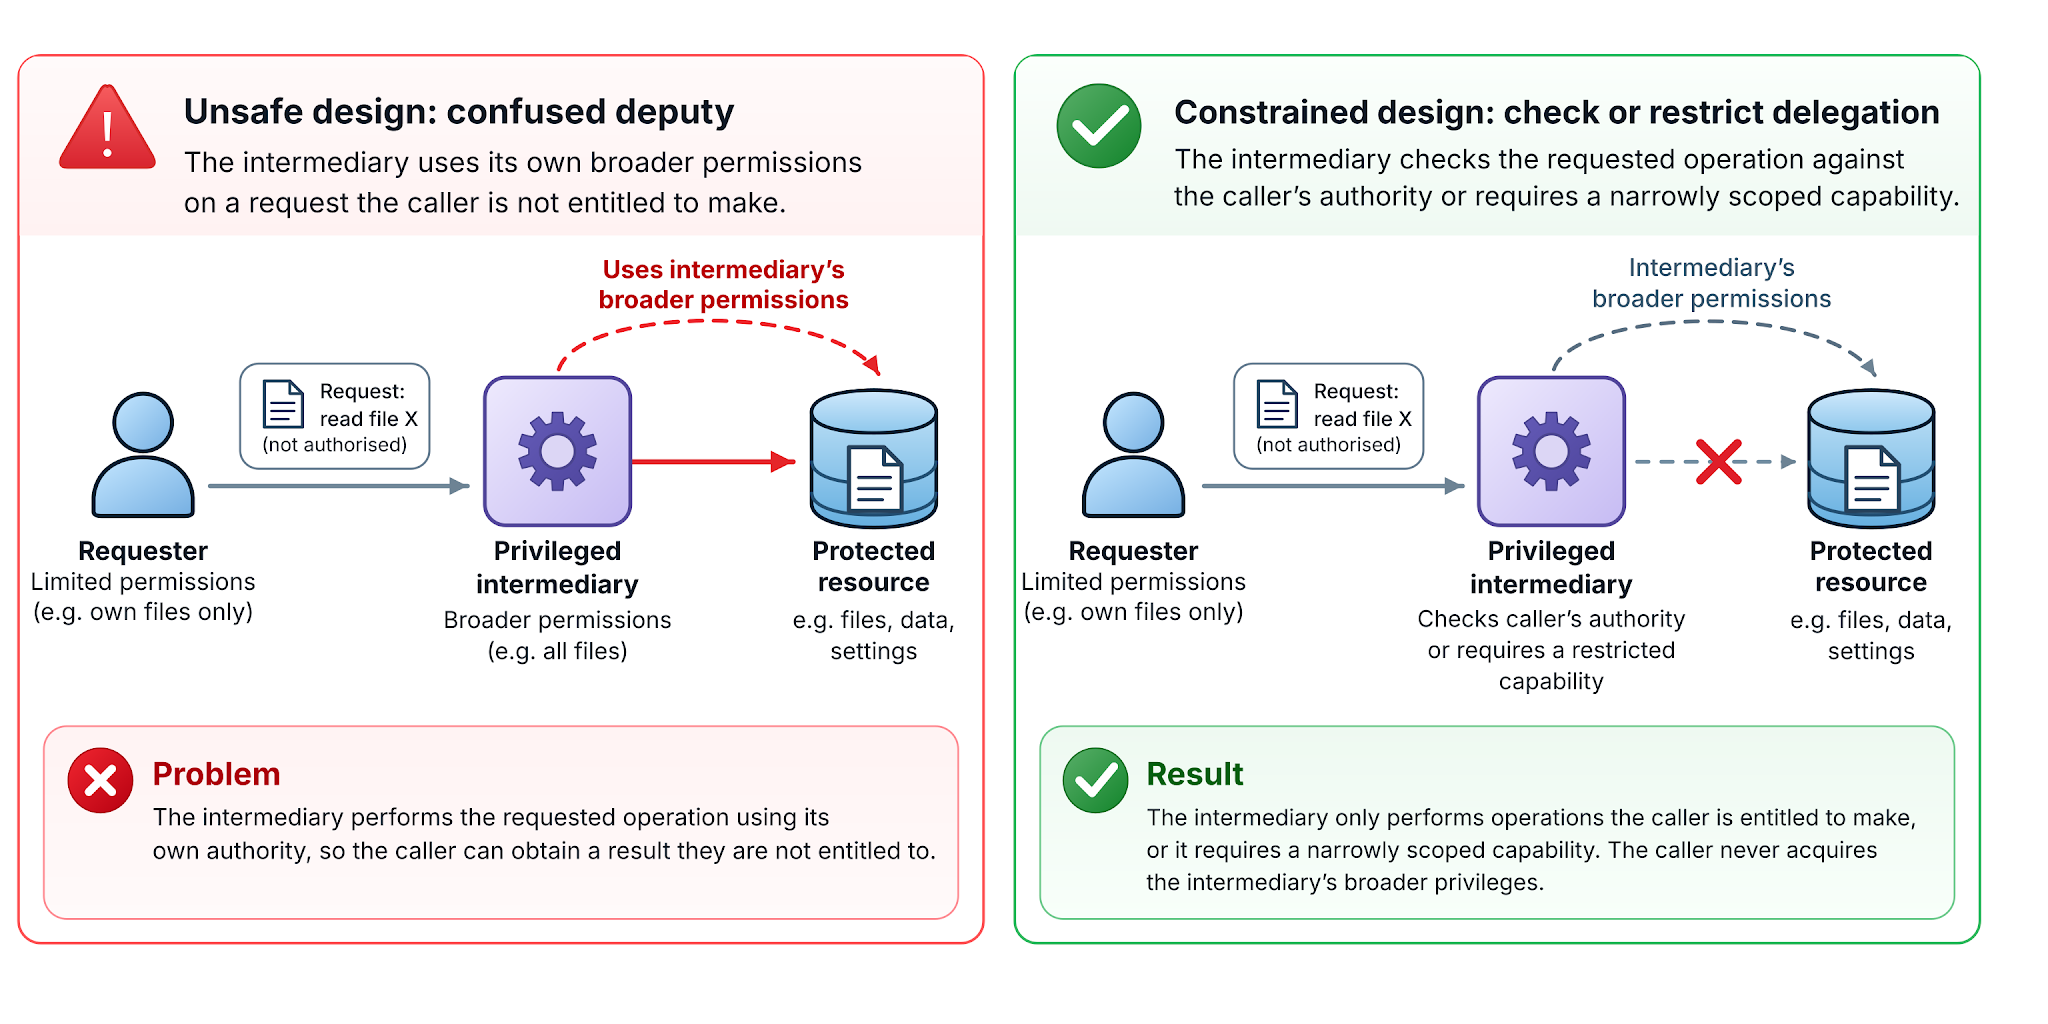
El problema del intermediario privilegiado (confused deputy) surge cuando un software utiliza sus propios permisos más amplios para ejecutar una solicitud que el solicitante no tiene derecho a realizar. Por ejemplo, un servicio de registros puede estar autorizado a leer todos los archivos, mientras que un usuario común solo debería recuperar los suyos. Si el servicio acepta cualquier identificador de registro sin verificar los derechos del solicitante, puede devolver información de otra persona. El usuario nunca adquiere los permisos principales del servicio; el servicio los utiliza indebidamente en nombre del usuario. Por lo tanto, aislar los registros protegidos resulta insuficiente si un intermediario privilegiado los recupera para cualquiera que los solicite. [8]
Una interfaz de delegación adecuada limita el trabajo que el componente privilegiado acepta realizar. En lugar de aceptar una ruta de archivo sin restricciones, puede aceptar una operación específica permitida vinculada a los derechos del solicitante, o una capacidad de alcance limitado que demuestre autoridad sobre un recurso en particular. Esto es una aplicación del principio de mínima autoridad: las cuentas, los componentes y los servicios reciben solo el acceso y las operaciones que requieren sus funciones. También limita el alcance de un error, es decir, la información y las acciones que un fallo puede afectar, incluso a través de otros componentes dispuestos a actuar en su nombre. Un componente puede no tener acceso directo a archivos privados y, sin embargo, exponerlos indirectamente a través de un servicio más potente si sus solicitudes no están suficientemente restringidas. [9] [10]
La autoridad no puede determinarse únicamente mediante la identidad técnica. Un empleado legítimo puede recibir instrucciones fraudulentas para modificar los datos de pago, y un administrador legítimo puede aprobar una configuración peligrosa. El sistema informático puede verificar correctamente la cuenta del empleado sin tener motivos para confiar en el origen declarado de la solicitud. Para cambios de gran importancia, la confirmación mediante datos de contacto establecidos de forma independiente puede garantizar que la instrucción provenga de la persona o entidad prevista. Estos procedimientos ayudan a prevenir instrucciones fraudulentas, pero no solucionan la falta de una verificación de autorización en la aplicación. Las vulnerabilidades específicas requieren protecciones específicas.
Otro peligro reside en el uso indebido deliberado del acceso otorgado legítimamente. Alguien puede haber iniciado sesión correctamente y tener permiso para ver registros confidenciales, pero aun así divulgarlos a una persona no autorizada o utilizar una función administrativa con fines maliciosos. Si bien la autenticación y la autorización funcionan según su configuración, no pueden determinar las intenciones de una persona. La limitación de permisos, la separación de funciones confidenciales, el registro adecuado de las acciones consecuentes y la revisión independiente pueden limitar o detectar este tipo de uso indebido por parte de personal interno. [11]
El permiso para realizar una operación no garantiza su validez en cada etapa de un proceso mayor. Un pedido no debe procesarse antes de que se cumplan las condiciones de pago requeridas. Un cupón destinado a un solo uso no debe canjearse repetidamente simplemente porque cada solicitud esté bien formulada y provenga de una cuenta elegible. Se trata de fallos de lógica empresarial: la aplicación no ha aplicado los prerrequisitos, la secuencia válida ni los límites que rigen las acciones relacionadas. Dichas reglas deben verificarse con respecto al estado autorizado en la transición correspondiente, en lugar de inferirse de una pantalla mostrada o de un paso declarado por el solicitante. El fallo puede existir sin una condición de carrera, un comando malicioso o una cuenta robada. [12]
Cuando una comprobación correcta ya no se aplica
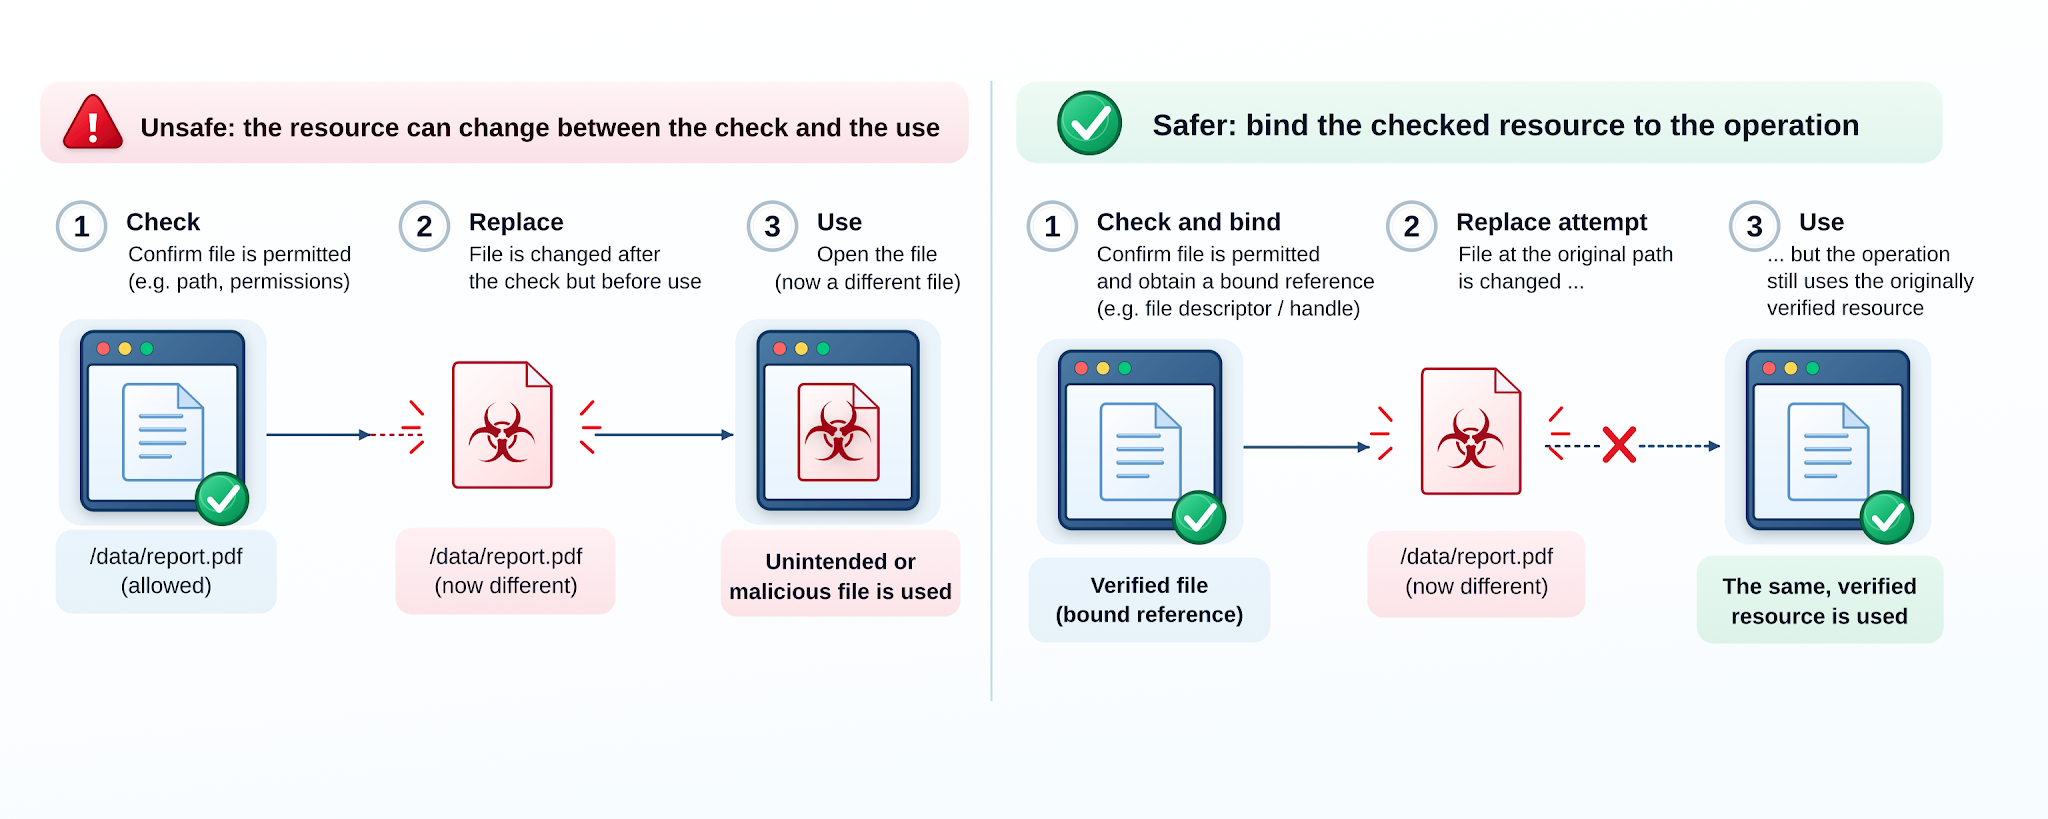
Una comprobación de permisos puede ser correcta en el momento de su ejecución y, aun así, dejar de proteger una acción posterior. Un archivo puede aprobarse y luego reemplazarse antes de que el programa lo abra. Dos trabajadores pueden ver suficiente stock cada uno y luego consumirlo ambos. Estos son problemas de tiempo de comprobación a tiempo de uso (TOCTOU): el estado inspeccionado ya no es el estado sobre el que actúa la operación subsiguiente. Se convierten en vulnerabilidades de seguridad cuando otra parte puede explotar la brecha para violar una regla requerida. Algunos surgen de operaciones concurrentes; otros se refieren a recursos cuya identidad o permisos cambian mientras se está trabajando. [13]
Consideremos un programa que verifica la ruta de un archivo comparándola con una ubicación aprobada y luego abre dicha ruta. Si un atacante logra modificar el nombre de la ruta durante ese intervalo, el programa podría procesar un archivo distinto al aprobado. La solución consiste en aplicar la decisión al recurso y estado que se esté utilizando realmente. Dependiendo del sistema, esto podría implicar operar sobre un identificador de archivo ya abierto y verificado, usar una operación o transacción atómica, mantener un bloqueo adecuado o definir cómo afecta la revocación al trabajo ya iniciado. Repetir la verificación sin cerrar la siguiente brecha no garantiza la seguridad.
La concurrencia genera fallos relacionados que van más allá del acceso a archivos. Varias solicitudes individualmente válidas pueden exceder colectivamente el límite de una cuenta si se comparan con un estado obsoleto. Un privilegio puede revocarse mientras se ejecuta una tarea de larga duración, o un identificador puede reasignarse mientras otro componente asume que aún se refiere al mismo objeto. Un diseño seguro debe especificar qué estado es el principal y cómo la verificación y la operación resultante se mantienen coherentes.
Cuando se permite que la información dirija el trabajo
Los programas procesan datos suministrados mediante solicitudes de usuario, archivos importados, mensajes de red y otros servicios. Un valor puede estar bien formado y aun así ser inapropiado para la operación que controla. Un nombre de archivo puede llevar a una ubicación fuera de la carpeta prevista. Un identificador de registro puede seleccionar datos de otra persona. Procesar un archivo comprimido pequeño puede exigir una cantidad desmesurada de trabajo. Considerar este material como entrada no confiable significa que aún no se han establecido las propiedades necesarias para su uso particular. Esto no implica que todos los remitentes sean maliciosos. El mismo fallo puede producirse por manipulación deliberada, un archivo corrupto o un error común. [14]
Se produce una transición peligrosa cuando se permite que los datos se conviertan en instrucciones. Una consulta a una base de datos o un comando del sistema operativo, ensamblado mediante la combinación de texto de programa con un valor externo, puede permitir que dicho valor modifique el comando. Esto constituye una vulnerabilidad de inyección. Una página web puede fallar de forma similar cuando se incorpora texto externo a un contenido que el navegador interpreta como código en lugar de mostrarlo como texto. Esto se conoce como secuencias de comandos entre sitios (XSS); para prevenirlo, es necesario gestionar el contenido en el contexto específico en el que el navegador lo interpretará. Las interfaces más seguras mantienen la operación prevista separada de los datos variables, como por ejemplo, mediante el uso de consultas a bases de datos parametrizadas cuando la interfaz lo permite. La solución no consiste en una lista genérica de caracteres sospechosos: un valor que es seguro como texto plano puede ser inseguro cuando se interpreta como un comando, una ruta de archivo o parte de otro lenguaje. Incluso una consulta a una base de datos correctamente construida requiere una verificación independiente para asegurar que el solicitante esté autorizado a obtener su resultado. [15] [16]
Algunas entradas dañinas no contienen ningún comando. Un decodificador multimedia puede verse obligado a asignar más memoria de la prevista, un documento complejo puede consumir un tiempo de procesamiento excesivo y las solicitudes repetidas permitidas pueden sobrecargar un servicio compartido. Los límites de recursos deben aplicarse antes y durante el trabajo costoso, no después de que este ya se haya pagado. El fallo resultante puede ser una denegación controlada, un bloqueo o la indisponibilidad del servicio para otros usuarios. Por ello, la seguridad también se centra en si los sistemas pueden seguir realizando sus funciones legítimas. Las condiciones bajo las cuales un servicio promete permanecer disponible, y los límites de dicha promesa, merecen tanta precisión como sus reglas de acceso. [14]
Estos fallos difieren en el punto donde la información no confiable traspasa un límite. A veces se interpreta como una instrucción, a veces agota un recurso y a veces es procesada por código que no puede gestionar su propia memoria de forma segura. Este último caso merece una atención especial, ya que un archivo o mensaje mal formado puede aprovecharse de la forma en que un programa almacena y accede a los datos, incluso cuando la entrada no contiene ningún comando.
Seguridad de memoria y garantías de los lenguajes
Todo programa en ejecución necesita espacio de almacenamiento, denominado memoria. El programa coloca valores en áreas reservadas para ellos, los utiliza y, finalmente, libera el espacio que ya no necesita. Un requisito fundamental es que ninguna operación debe leer ni escribir fuera del área asignada. Otro requisito es que el espacio de almacenamiento no debe seguir utilizándose como si perteneciera a un objeto una vez que este haya finalizado su ciclo de vida. Estas dos medidas de protección son esenciales para la seguridad de la memoria. Se refieren a la validez de las operaciones de memoria, más que a si una persona tenía permiso para solicitar la operación en primer lugar.
El archivista (véase «Cómo funcionan los ordenadores: El archivista de alta velocidad de Feynman») ofrece una analogía directa. Una bandeja de archivo tiene espacio para 100 fichas, pero una instrucción exige que se inserten 120. Sin una regla que restrinja el espacio de la bandeja, las fichas adicionales podrían colocarse donde corresponden otros registros. En un ordenador, una escritura sin control más allá de una región asignada puede corromper datos no relacionados; una lectura sin control puede exponer información de otra región. Dependiendo del programa y de las protecciones existentes, las consecuencias pueden variar desde un fallo o un resultado incorrecto hasta una vulnerabilidad que un atacante puede explotar. Una operación controlada, en cambio, impide el acceso no válido. La tarea de archivo solicitada puede fallar, pero este límite en particular se conserva. Las fichas son una metáfora de las ubicaciones de memoria, no una afirmación de que cada desbordamiento otorgue automáticamente el control a un atacante.
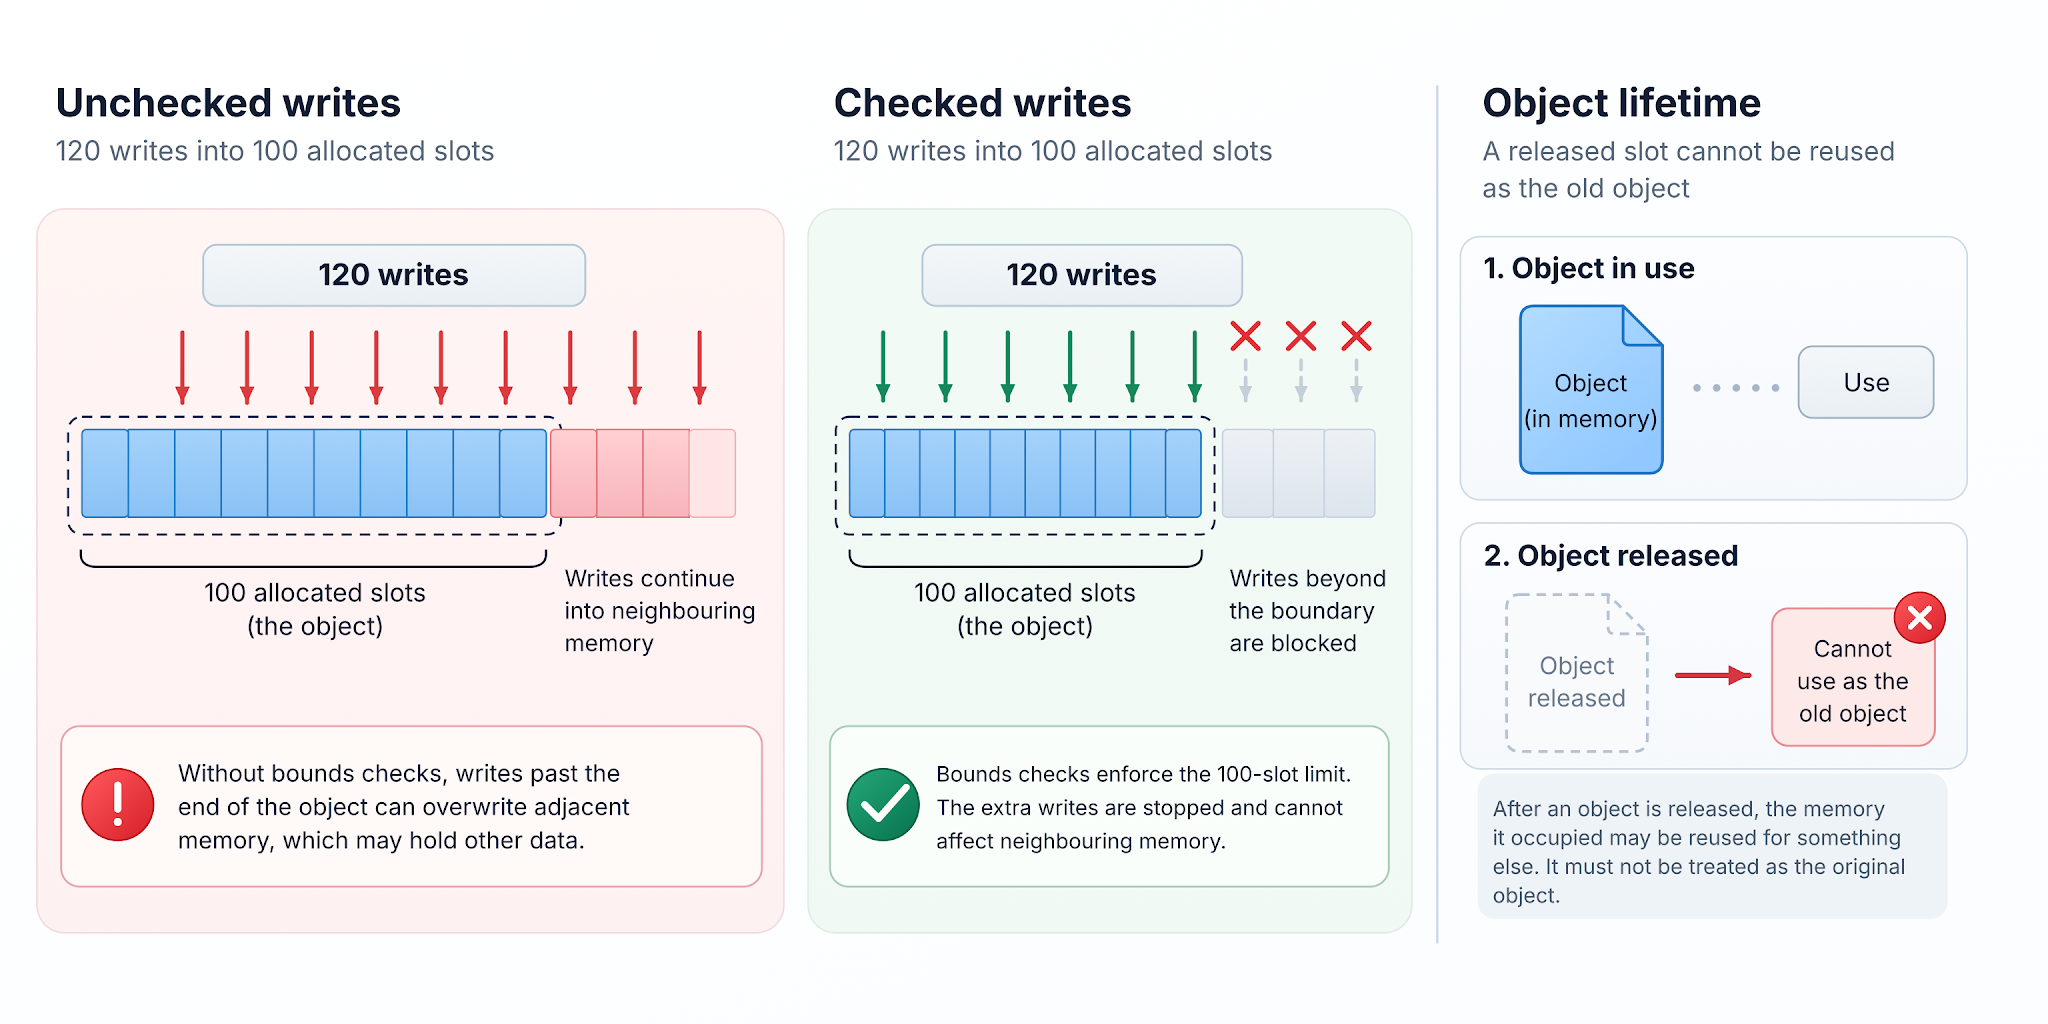
Se produce un error de memoria diferente cuando un programa mantiene una referencia a un objeto después de que su memoria haya sido liberada. Si posteriormente se reutiliza la misma región para otro objeto, la referencia obsoleta puede leer o sobrescribir información irrelevante. Este es un error de uso de memoria liberada. Una simple comprobación de límites no basta para validar el acceso: la dirección puede estar dentro de una región asignada, pero el objeto que originalmente dio sentido a la referencia ya no existe. Las protecciones espaciales y de tiempo de vida abordan fallos distintos.
Los lenguajes de sistemas más antiguos y ampliamente utilizados, como C y C++, permiten la manipulación directa de la memoria, para lo cual el programador debe establecer los límites y las reglas de tiempo de vida necesarios. Este control ha posibilitado el desarrollo de software importante, pero los errores en rutas inseguras pueden ser graves y difíciles de detectar. Una implementación cuidadosa, la revisión del código, el análisis automatizado, las opciones de protección del compilador y las pruebas reducen el riesgo; sin embargo, no garantizan la seguridad de todas las ejecuciones posibles. Tampoco el hecho de encontrar C o C++ en un producto demuestra que este sea vulnerable. Las preguntas clave se refieren al código específico que maneja la entrada relevante, qué comprobaciones o protecciones utiliza y qué capacidad tiene dicho código en caso de error.
Las funcionalidades de seguridad de memoria en los lenguajes trasladan parte de la responsabilidad a reglas impuestas por el lenguaje o su entorno de ejecución. Rust, en su versión segura, rechaza muchas referencias no válidas antes de que se ejecute un programa y verifica los accesos indexados según sea necesario. Las funcionalidades de seguridad habituales de Swift imponen límites y restricciones de tiempo de vida gestionado. El código de las aplicaciones Python suele operar con objetos gestionados en lugar de realizar aritmética de punteros sin procesar. Estos lenguajes no eliminan la necesidad de tomar decisiones de seguridad correctas, y sus protecciones no necesariamente se extienden a todos los componentes nativos. Rust tiene regiones explícitamente inseguras; Swift puede llamar a bibliotecas de C o usar punteros inseguros; Python puede cargar extensiones nativas. Una aplicación segura en memoria que pasa datos a código inseguro en memoria hereda la necesidad de examinar ese límite y el código que se encuentra más allá. La elección del lenguaje modifica clases importantes de riesgo, pero un producto debe evaluarse por las operaciones que realmente realiza. [17] [18] [19]
El artículo de Szekeres, Payer, Wei y Song de 2013, titulado "SoK", examinó cómo se desarrollan las vulnerabilidades de corrupción de memoria y qué medidas de defensa intentan contrarrestar. Su análisis distingue entre prevenir operaciones de memoria no válidas, detectar la corrupción y dificultar la explotación una vez que se produce un defecto. Estas son garantías sustancialmente diferentes. El artículo es anterior a las nuevas medidas de mitigación de compiladores y hardware, pero su clasificación explica por qué bloquear una técnica de explotación no demuestra que se haya eliminado el defecto de memoria subyacente. [20]
Los lenguajes más seguros son útiles, pero los sistemas existentes no pueden reemplazarse de la noche a la mañana. C y C++ están profundamente integrados en sistemas operativos, firmware y bibliotecas especializadas, muchas de las cuales presentan limitaciones de rendimiento, hardware o compatibilidad. Reescribirlos puede introducir sus propios defectos, y los equipos necesitan las habilidades y herramientas necesarias para validar los reemplazos. Esto no justifica aceptar indefinidamente un manejo de memoria inseguro. La evaluación práctica consiste en determinar dónde los datos no confiables llegan a operaciones no verificadas, qué dependencias nativas persisten, qué privilegios tienen esos componentes y cómo las pruebas, las medidas de mitigación y el mantenimiento abordan el riesgo. Una etiqueta de lenguaje por sí sola no puede responder a estas preguntas. [2]
Cuando el diseño es vulnerable
Las vulnerabilidades de diseño pueden ser tan graves como los defectos en la gestión de memoria o la aplicación de entornos aislados. Surgen cuando las reglas o flujos de trabajo previstos de un sistema permiten un resultado perjudicial, incluso cuando el software sigue correctamente dichas reglas. El código con seguridad de memoria, los componentes cuidadosamente restringidos y el cifrado robusto no compensan un diseño que otorga acceso a una operación protegida a una persona no autorizada.
Imaginemos un servicio ficticio de copias de seguridad cifradas. Su función de recuperación requiere que los usuarios inicien sesión, pero luego devuelve la clave de recuperación para cualquier identificador de copia de seguridad que proporcionen, sin comprobar si la copia de seguridad les pertenece. Un atacante con una cuenta ordinaria que conozca el identificador de otro cliente puede obtener la clave de ese cliente. No se vulnera el cifrado, no se corrompe la memoria ni se escapa del entorno aislado. El sistema entrega el secreto porque su diseño nunca requirió la verificación de autorización necesaria.
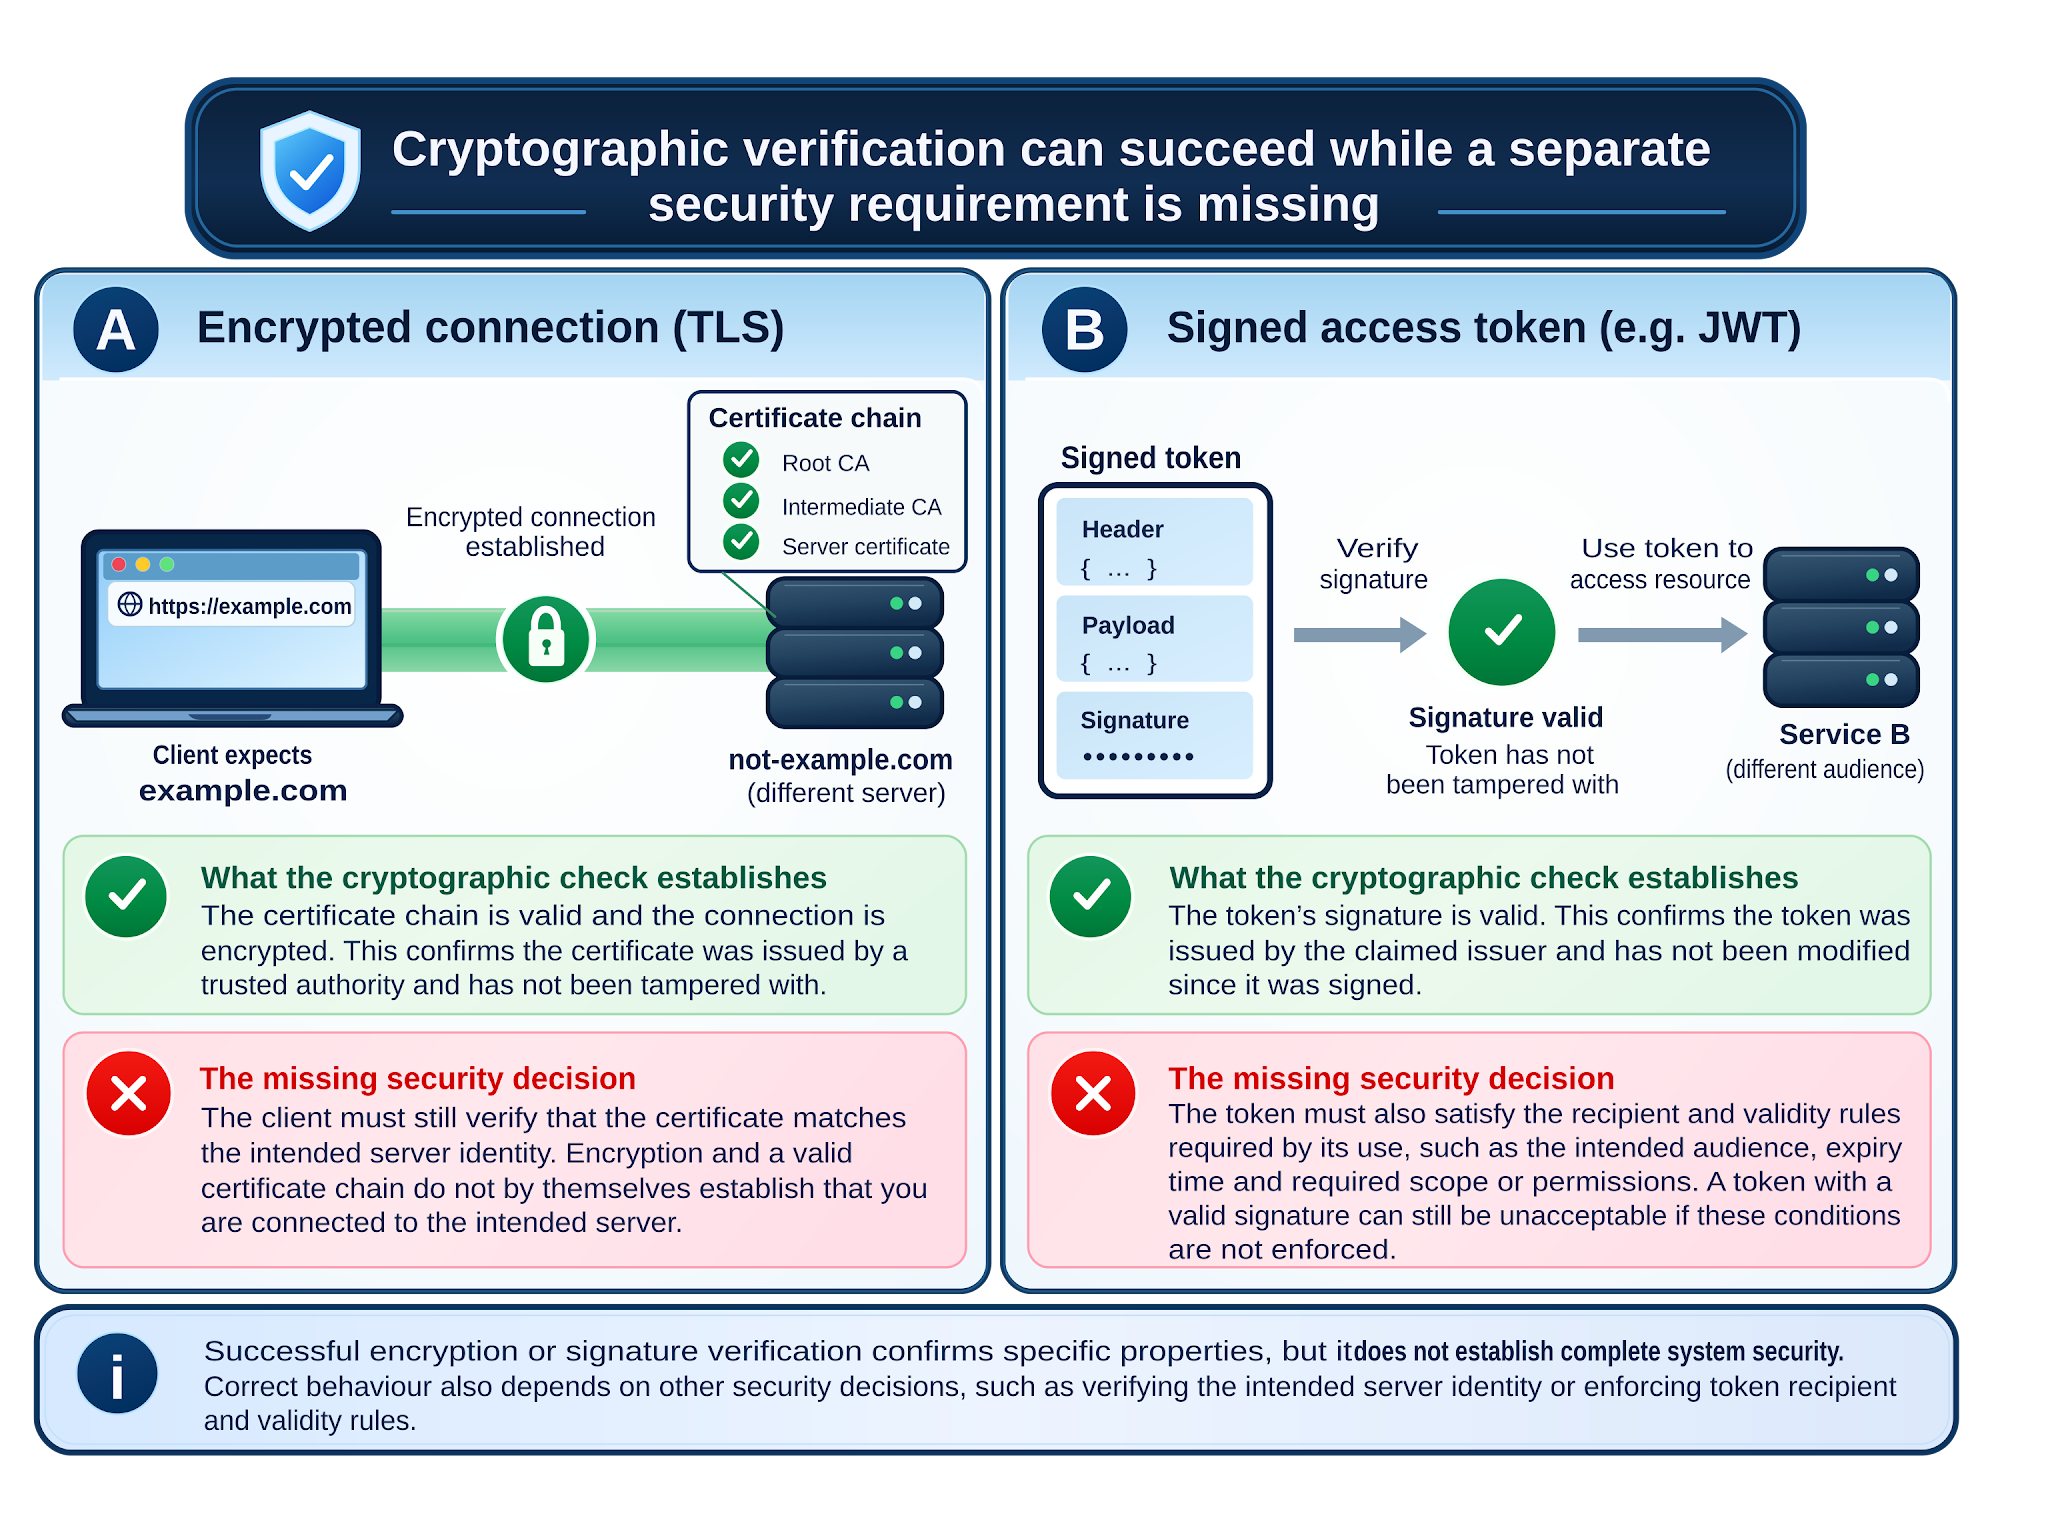
La criptografía ofrece otro ejemplo de una salvaguarda correcta aplicada a una decisión de seguridad incompleta. El cifrado puede proteger la información que viaja entre ordenadores sin necesidad de determinar qué servicio se encuentra en el otro extremo ni si se debe aceptar una solicitud. Estos aspectos requieren comprobaciones independientes. Un protocolo establece los mensajes y las comprobaciones que se espera que utilicen los sistemas de comunicación; la implementación es el software que sigue esas reglas. Una implementación puede omitir una comprobación necesaria, mientras que un protocolo puede, a su vez, omitir un requisito esencial. Por lo tanto, el correcto funcionamiento de una salvaguarda no garantiza la seguridad de la operación completa. [21]
Consideremos un programa que se conecta a un sitio web. Puede establecer una conexión cifrada y aceptar un certificado de un emisor de confianza sin comprobar si dicho certificado identifica el sitio web al que pretende acceder. El cifrado funciona, pero el programa podría estar comunicándose con un impostor. Un error similar ocurre con los tokens de acceso firmados, credenciales digitales que algunos servicios utilizan para decidir si aceptan o no las solicitudes. Un programa podría verificar la firma del token, pero no comprobar si proviene de un emisor aceptado, si estaba destinado a ese servicio o si aún es válido. En ambos casos, una verificación correcta deja otra decisión necesaria sin resolver. Ninguno de estos fallos requiere un cifrado vulnerado o una firma falsificada. El libro de Ross Anderson, *Why Cryptosystems Fail*, examina la brecha más amplia entre las protecciones criptográficas y los fallos de los sistemas reales. [22] [23] [24]
El informe SoK de Clark y van Oorschot de 2013 sobre SSL y HTTPS analizó cómo la emisión de certificados, las decisiones de confianza del navegador y las prácticas de infraestructura afectaban la seguridad de las conexiones cifradas. Su estudio situó la identidad y la confianza en los certificados dentro del sistema general, en lugar de considerar el cifrado como suficiente por sí solo. Examinó los mecanismos de su época, no las implementaciones actuales de TLS ni las protecciones introducidas posteriormente; las implementaciones actuales requieren una evaluación conforme a los estándares vigentes. [25]
Los secretos también pueden filtrarse mediante comportamientos que nunca se concibieron como respuesta. Diferentes mensajes de error pueden revelar si una cuenta existe. Una comprobación que tarda diferentes cantidades de tiempo según el secreto puede, si esa diferencia se puede observar de forma fiable, filtrar información a través de un canal lateral de temporización. Estas filtraciones pueden ocurrir sin una solicitud directa del secreto o un algoritmo de cifrado vulnerado. No todas las diferencias medibles son explotables; la señal, las condiciones y lo que se puede inferir son factores importantes. [26]
La seguridad se diferencia del manejo de fallos habitual porque un atacante puede crear deliberadamente condiciones que el diseñador consideró improbables. Se puede intentar repetidamente una entrada mal formada, una secuencia inusual de solicitudes o una dependencia comprometida hasta que una ruta produzca el efecto deseado. Las pruebas rutinarias muestran cómo se comportan los casos conocidos; no garantizan que se hayan excluido todas las combinaciones maliciosas. La cuestión es qué medidas de seguridad siguen siendo efectivas cuando falla una suposición.
También puede incorporarse una vulnerabilidad de diseño a un protocolo: una implementación puede seguir fielmente sus reglas incluso si estas dejan una forma de reproducir, redirigir o hacer un mal uso de un mensaje que, de otro modo, sería válido. Ross Anderson y Roger Needham exploraron esta perspectiva adversaria en Programming Satan’s Computer. [27] Incluso el software correctamente especificado e implementado depende de que el hardware preserve los límites que espera.
Cuando el propio hardware es vulnerable
El software depende del hardware para imponer restricciones básicas. Un programa no debería poder modificar la memoria protegida de otro, la información restringida por el procesador debería permanecer inaccesible y un dispositivo debería arrancar desde un estado fiable. Sin embargo, los procesadores, los chips de memoria y el código de bajo nivel que inicia un dispositivo son, en sí mismos, sistemas complejos diseñados con precisión. Su comportamiento puede vulnerar una norma de seguridad incluso cuando la aplicación que los ejecuta está correctamente escrita.
⚠️ Rowhammer demuestra una debilidad física inesperada. En algunos chips de memoria, el acceso repetido a ubicaciones de memoria específicas puede perturbar eléctricamente las celdas vecinas hasta que cambian los bits almacenados. El software no solicitó esos cambios. Los investigadores han demostrado que, en sistemas susceptibles y bajo ciertas condiciones, este efecto puede explotarse para eludir las protecciones de memoria y obtener privilegios superiores. Un programa puede respetar las reglas sobre dónde se le permite escribir, pero la memoria física aún puede modificar la información fuera de esos límites. Rowhammer no afecta a todos los diseños de memoria por igual, y su explotación práctica y las medidas de mitigación dependen del hardware y del sistema. [28] [29]
⚠️ Otras vulnerabilidades de hardware pueden revelar información sin modificarla. Los procesadores modernos a veces realizan trabajo por adelantado, prediciendo qué instrucciones serán necesarias para ahorrar tiempo. Esto se denomina ejecución especulativa. Si la predicción resulta errónea, el resultado tentativo se descarta, pero pueden quedar rastros de ese trabajo en una caché, un pequeño almacén que ayuda al procesador a recuperar rápidamente la información utilizada recientemente. La medición de esos rastros a veces puede revelar secretos que el programa no tenía permiso para leer. Spectre explotó predicciones manipuladas para inducir tales revelaciones; Meltdown explotó una vulnerabilidad diferente en la forma en que algunos procesadores manejaban los datos protegidos antes de que se produjera una violación de acceso. Estos son canales laterales del procesador, relacionados con las fugas de tiempo descritas anteriormente. Se refieren a cómo un procesador ejecuta internamente las instrucciones, no simplemente al conjunto de instrucciones publicado que describe qué operaciones puede solicitar el software. Los procesadores afectados, las condiciones y las contramedidas difieren. [30] [31] [32]
La seguridad también puede fallar antes de que se inicie un sistema operativo. El arranque seguro establece una cadena de confianza al verificar que las etapas sucesivas del inicio estén autorizadas antes de su ejecución. Algunos dispositivos almacenan el código de arranque inicial en memoria de solo lectura (ROM), que normalmente no se puede reescribir después de su fabricación. Esto dificulta la manipulación posterior, pero también significa que un defecto en la rutina de verificación o recuperación original puede ser imposible de reparar en la ROM.
⚠️ La divulgación en 2018 de la vulnerabilidad Fusée Gelée en el modo de recuperación del Tegra X1 ilustra una falla accesible mediante acceso físico USB, no mediante un servicio de red remoto. Los cambios de software y las restricciones operativas pueden reducir la exposición, pero no pueden reescribir la ROM de arranque, que es realmente inmutable. El arranque seguro sigue siendo valioso dentro de las garantías de su raíz de confianza y las condiciones de ataque que cubre. [33] [34] [35]
⚠️ El informe SoK de Glosner y Machiry de 2026 examinó 43 gestores de arranque en la cadena de arranque del software tras la transferencia de la raíz del hardware. Su conjunto de datos BOOTBENCH recopila 3658 vulnerabilidades reportadas y cambios asociados, y los autores identificaron limitaciones en las técnicas de detección y endurecimiento existentes. Estas cifras no establecen que todos los gestores de arranque sean explotables ni que algún dispositivo en particular sea vulnerable. Muestran por qué verificar que el software de arranque provenga de una fuente autorizada es diferente de establecer que la implementación autorizada no tenga defectos explotables. [36]
El hardware ilustra las limitaciones de la seguridad de una sola capa. La seguridad de las aplicaciones depende, en parte, de la gestión de la memoria del procesador, su cadena de arranque y la implementación de las protecciones de hardware declaradas. Estas dependencias no invalidan las defensas de hardware; definen las condiciones bajo las cuales el software puede confiar en ellas.
Contener un fallo antes de que se propague
La ingeniería de seguridad también limita las consecuencias de un defecto que no se haya prevenido. Un programa que maneja un formato de archivo desconocido no debería recibir automáticamente el mismo acceso a registros privados, servicios de red y operaciones potentes que la aplicación que lo llamó. Los sistemas operativos pueden establecer límites entre los procesos en ejecución y restringir sus permisos. Un entorno aislado (sandbox) es un conjunto de dichos límites. La pregunta relevante es qué componente en ejecución tiene restringido el acceso a qué recursos. Colocar archivos en carpetas de origen separadas, llamar a una función mediante un lenguaje de programación diferente o describir una biblioteca como aislada no establece por sí solo un límite del sistema operativo. [10]
Un decodificador nativo cargado en la aplicación principal suele compartir el proceso, la memoria y gran parte de la autoridad de dicha aplicación. Trasladar la decodificación a un proceso independiente otorga al trabajador un espacio de direcciones distinto. Aplicar restricciones adicionales, adecuadamente limitadas, a ese trabajador puede reducir el alcance directo de un defecto o una vulnerabilidad. Ambas versiones pueden residir dentro del mismo entorno aislado de la aplicación; la protección adicional proviene del propio límite y los permisos del trabajador. Esta configuración conlleva costes en términos de comunicación, tiempos de espera y recuperación, y el host aún debe inspeccionar los resultados del trabajador. Un trabajador restringido que pueda solicitar operaciones de archivos privilegiadas arbitrarias a su host podría simplemente recrear el problema del agente confuso a través del límite del proceso.
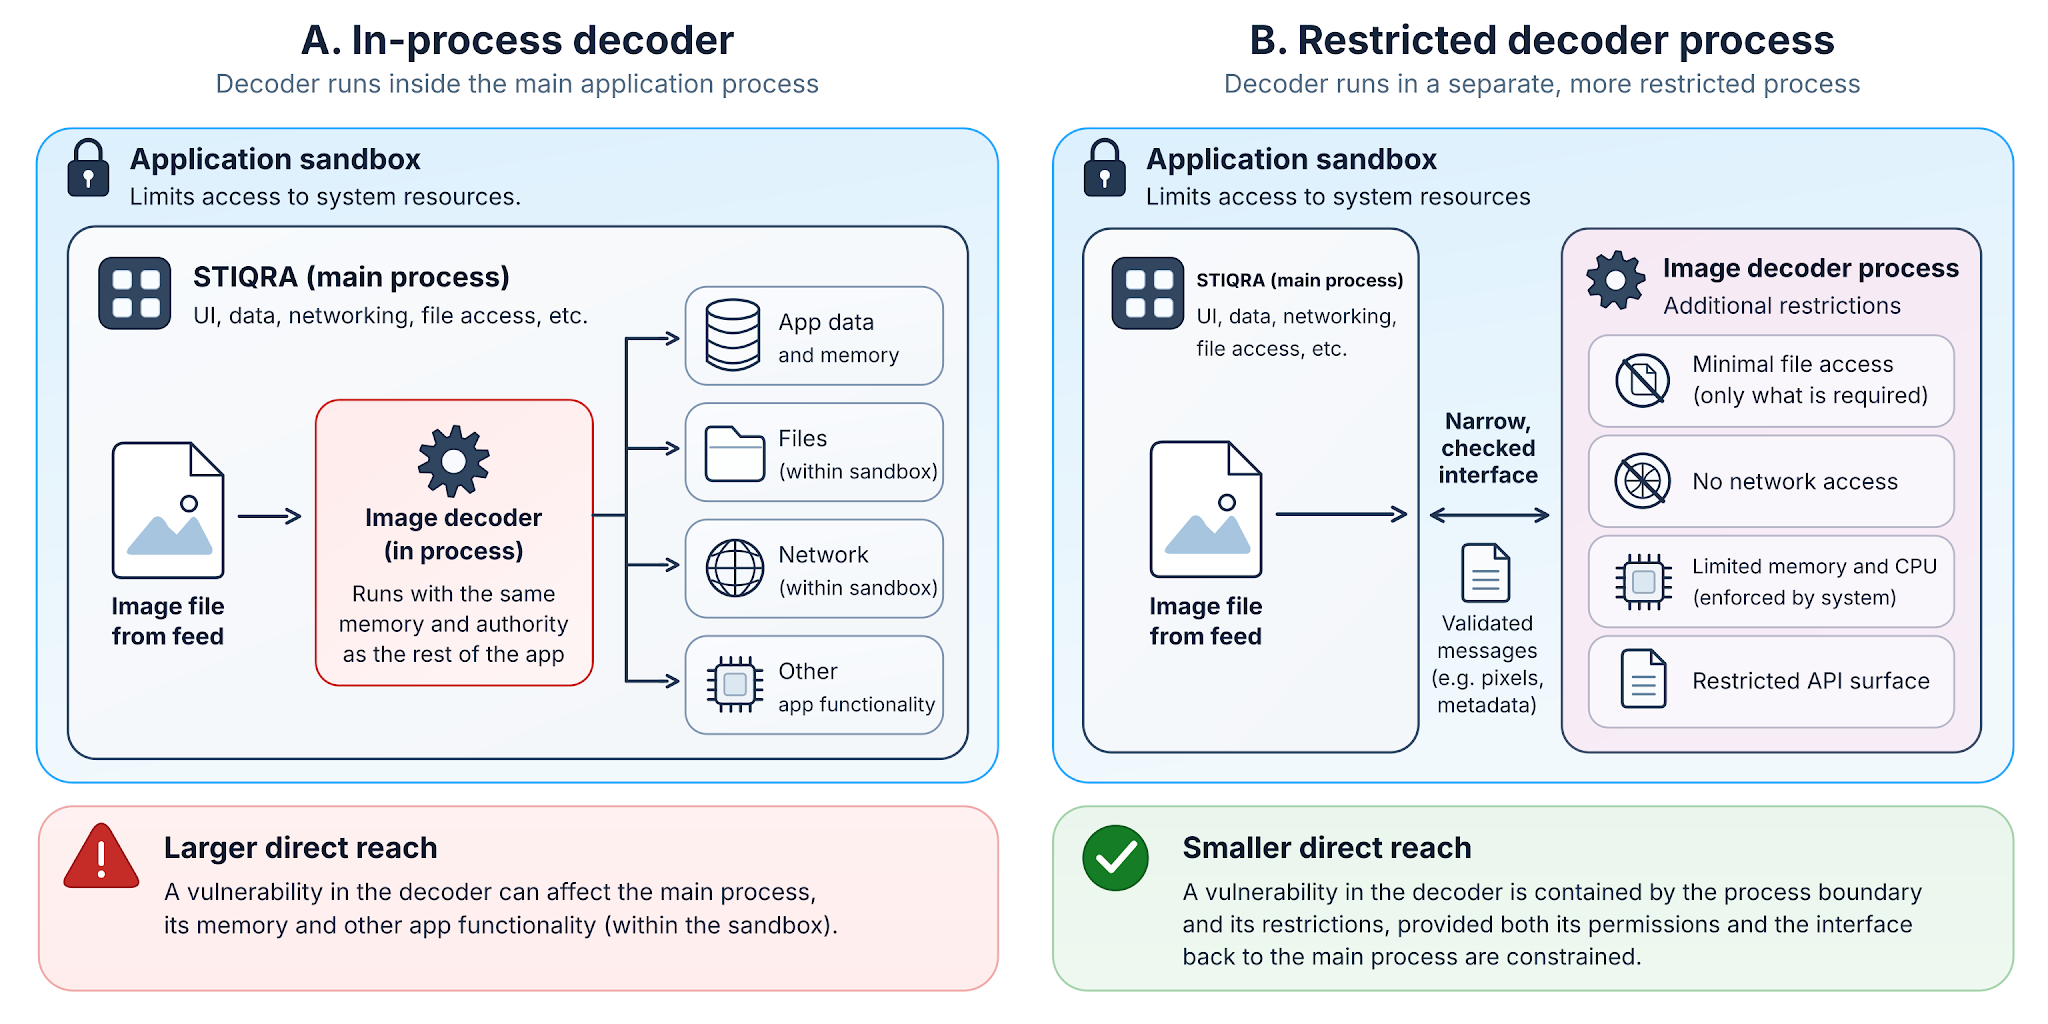
Existe una amplia investigación sobre cómo funcionan o fracasan estos límites en la práctica. El informe SoK de 2025 de Lefeuvre y sus colegas analizó 211 proyectos de investigación y 61 sistemas compartimentados convencionales. Identificó dificultades persistentes para definir políticas de aislamiento utilizables, trasladar la investigación a la producción y evaluar amenazas que involucran agentes confusos y limitaciones de hardware. Un proceso separado no es prueba de una contención efectiva si sus permisos son excesivos o si un host privilegiado actúa sobre solicitudes sin restricciones. La tarea de ingeniería relevante consiste en definir la autoridad disponible en ambos lados de una interfaz y demostrar que los límites impuestos coinciden con ese diseño. [37]
La contención ilustra un principio general: la prevención y la limitación de daños tienen funciones distintas. Las comprobaciones de entrada buscan rechazar una operación dañina antes de que comience. Las reglas de seguridad de la memoria impiden ciertos accesos no válidos. El aislamiento de procesos (sandboxing) restringe los recursos a los que puede acceder el código defectuoso. La monitorización y la recuperación ayudan a un servicio a reconocer y responder a los fallos que aún son posibles. Varias protecciones pueden reducir las consecuencias de un error, pero su independencia debe establecerse, no darse por sentada. Por lo tanto, un defecto explotado con éxito puede permanecer confinado a un componente restringido; no otorga automáticamente acceso a todas las partes del sistema. Una declaración de seguridad honesta identifica el efecto prohibido y los mecanismos que imponen los límites pertinentes, en lugar de enumerar tecnologías o publicitar la palabra "seguro". [38]
⚠️ Los límites de la contención y la protección del hardware
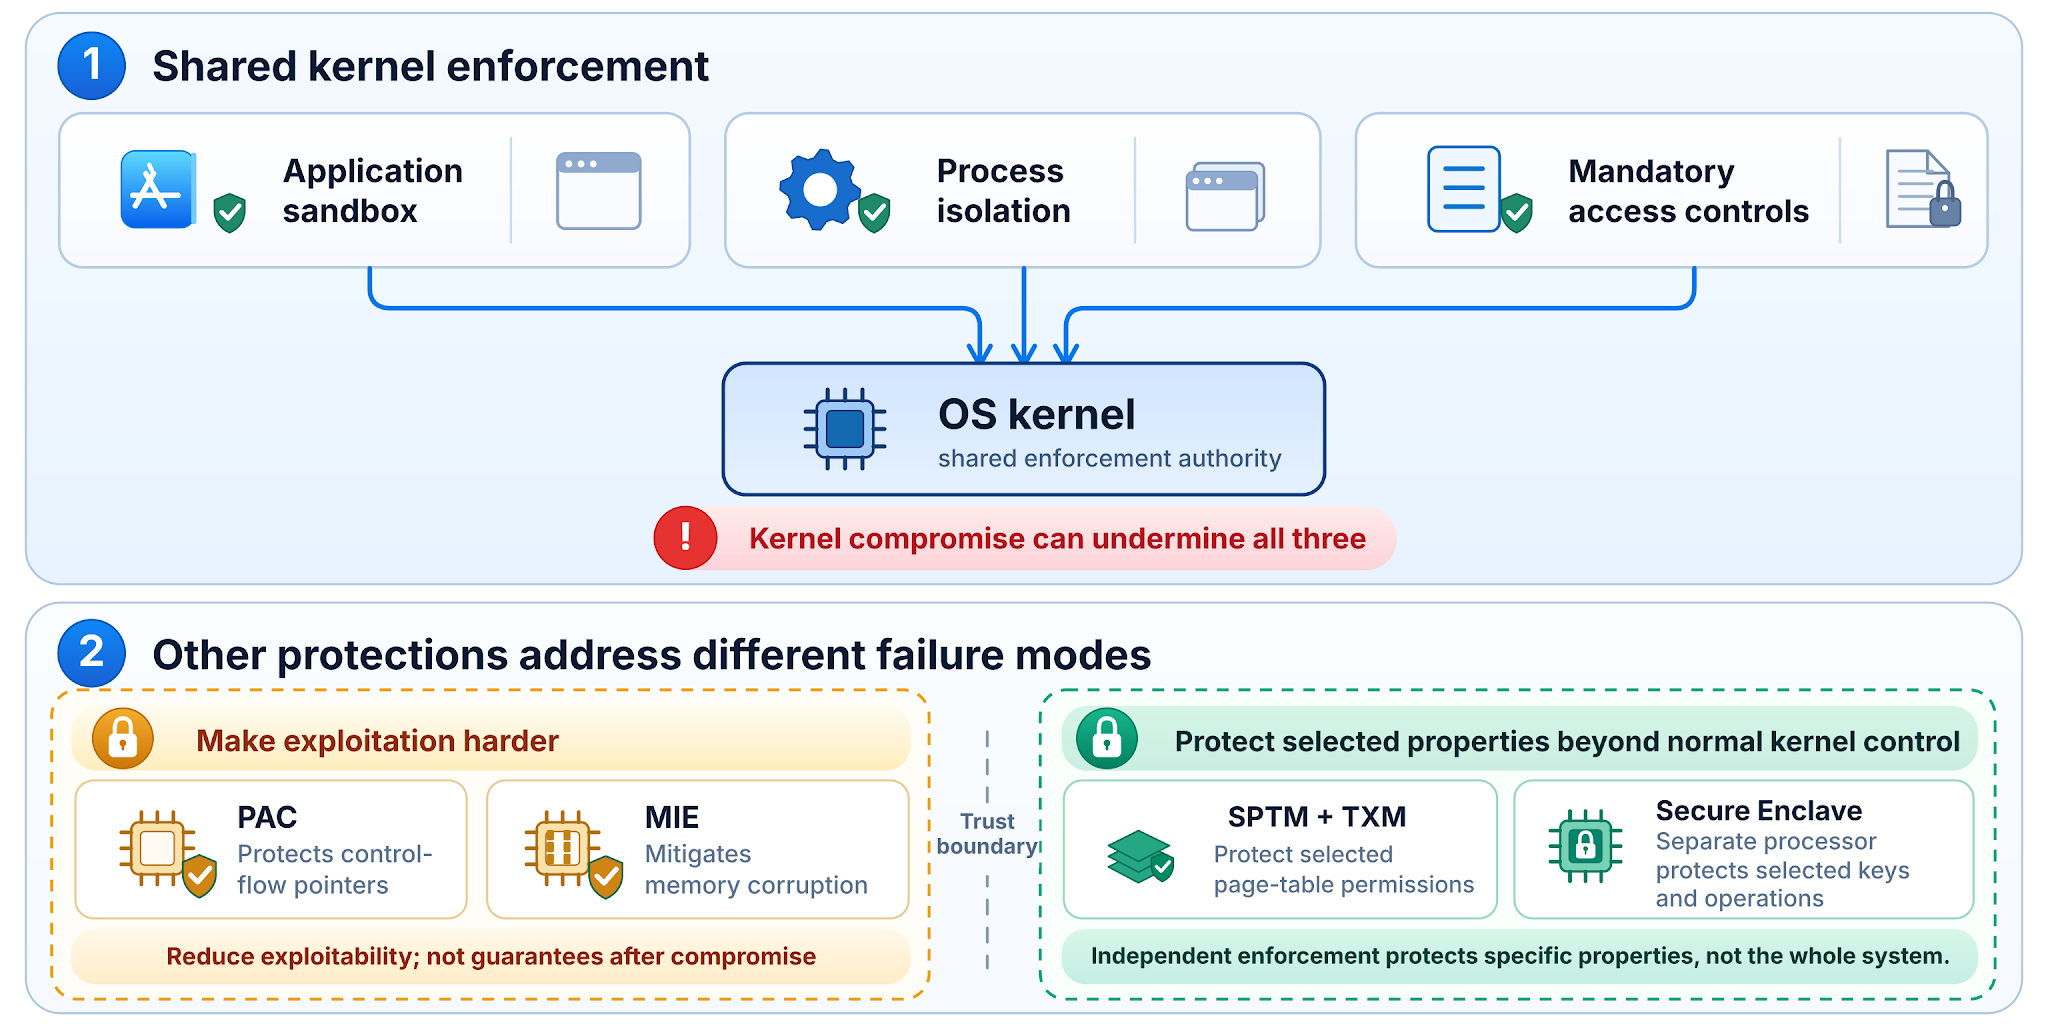
Algunas protecciones parecen independientes porque tienen nombres y configuraciones diferentes, pero dependen de la misma autoridad. Los entornos aislados de aplicaciones, el aislamiento de procesos y los controles de acceso obligatorios suelen depender del núcleo del sistema operativo para aplicar sus restricciones. El núcleo es el componente central que gestiona los programas, la memoria y los permisos. Si un atacante obtiene suficiente control sobre el núcleo, podría modificar o ignorar las reglas de las que dependen dichas protecciones. Varias capas de protección no son necesariamente varias líneas de defensa independientes. [39]
Las medidas de mitigación basadas en hardware pueden dificultar la vulneración del kernel. La autenticación de punteros (PAC) firma y autentica punteros específicos, lo que frustra algunos ataques de flujo de control que se basan en su corrupción. En los sistemas Apple compatibles con Memory Integrity Enforcement (MIE), el etiquetado de memoria por hardware, la asignación tipada y las restricciones del sistema operativo asociadas obstaculizan ciertas clases de explotación de corrupción de memoria, incluidos los ataques contra el código del sistema protegido. Ninguno de estos mecanismos constituye una autoridad independiente capaz de mantener la política de entorno aislado de la aplicación una vez que el atacante ha obtenido el control suficiente del kernel. [40]
Algunas protecciones operan fuera del control habitual del núcleo. En los sistemas Apple compatibles, el Monitor de Tabla de Páginas Seguras (SPTM), que funciona con un monitor de ejecución de confianza, restringe ciertas modificaciones de la tabla de páginas incluso cuando un atacante ha obtenido capacidad de escritura en el núcleo. Se trata de restricciones de integridad de memoria y código limitadas y compatibles con el hardware, no de una confianza continua en las decisiones del núcleo sobre usuarios, archivos o acceso a la red. Las propiedades que persisten dependen de la plataforma y de las capacidades del atacante. [39]
El Secure Enclave es un ejemplo de límite de seguridad independiente. En los dispositivos Apple compatibles, se trata de un procesador de seguridad con su propio arranque seguro, memoria protegida y microkernel. Está diseñado para proteger información confidencial seleccionada incluso si el núcleo principal del sistema operativo se ve comprometido. Una aplicación puede generar una clave privada para las operaciones gestionadas por el Secure Enclave y solicitar el trabajo criptográfico autorizado sin recibir la clave en sí. Lo que permanece protegido depende de la política de acceso a la clave y de las operaciones que el Enclave se encarga de garantizar, no simplemente de la presencia del chip. [41] [42]
Otros sistemas utilizan límites diferentes impuestos por hardware. Un Módulo de Plataforma Segura (TPM), implementado como un dispositivo independiente o dentro de un procesador, protege claves criptográficas específicas y puede vincular su uso a mediciones de cómo se inició el sistema; no es un entorno de propósito general para ejecutar código de aplicación. Arm TrustZone separa los estados de ejecución segura y normal en los procesadores compatibles, de modo que el software y los recursos designados pueden permanecer inaccesibles para el sistema operativo normal cuando el sistema está correctamente diseñado. Intel Software Guard Extensions (SGX), en procesadores compatibles, aísla el código y los datos de aplicaciones seleccionados en enclaves del software privilegiado, incluido el núcleo del sistema operativo. A diferencia de Secure Enclave de Apple, TrustZone y SGX no requieren un procesador de seguridad independiente. También protegen recursos diferentes y no pueden tratarse como intercambiables. [43] [44] [45]
Mantener cierta autoridad de seguridad independiente del núcleo principal también puede ayudar a restaurar la confianza en la plataforma tras una vulneración del núcleo. Una ruta de inicio o recuperación de confianza, anclada más allá del control de dicho núcleo, puede verificar el firmware y el software del sistema operativo autorizados antes de que el dispositivo vuelva a estar operativo. Las claves protegidas y las mediciones del proceso de arranque pueden respaldar estas verificaciones. El NIST distingue raíces de confianza para detectar cambios no autorizados, aprobar actualizaciones y recuperar el firmware de la plataforma dañado. Estos elementos deben integrarse en un proceso de recuperación funcional: un TPM, un Secure Enclave, un entorno TrustZone o un enclave SGX no restauran por sí solos un sistema operativo comprometido. [35] [38]
Dicha recuperación solo es posible dentro de un modelo de amenazas definido. El firmware de recuperación, la raíz de confianza del hardware y el software de reemplazo deben seguir siendo confiables. Hasta que se reemplace el kernel comprometido, un atacante aún puede manipular las solicitudes para proteger componentes, denegar el servicio o inspeccionar información antes de la protección o después de la liberación, incluso si algunas claves o la memoria del enclave permanecen inaccesibles. La recuperación no puede revertir la información ya divulgada. La diferencia radica entre proteger el estado seleccionado durante una vulneración y restablecer el funcionamiento confiable posteriormente.
El SoK de Zinkus, Jois y Green de 2022 examinó la confidencialidad de los datos en dispositivos móviles frente a adversarios con gran capacidad de extracción, incluidos aquellos con acceso físico al dispositivo o a servicios en la nube relacionados. Su alcance va más allá de la protección de una clave: la información también puede quedar expuesta antes de ser protegida, tras el descifrado o a través de servicios dependientes. Este análisis histórico no valida el comportamiento actual de SPTM ni de Secure Enclave. Refuerza la necesidad de especificar qué información permanece protegida, frente a qué capacidades y dónde se sale de un límite de confianza. [46]
Los límites de las protecciones dependientes del núcleo
| Mecanismo | Lo que realmente protege | Tras la vulneración del núcleo principal |
|---|---|---|
| Sandbox, aislamiento de procesos y MAC | El núcleo impone estos límites; un atacante que lo controle puede eludirlos. | ✕ No es fiable |
| Autenticación de punteros (PAC) | Dificulta algunos ataques que aprovechan la corrupción de punteros; no impone las políticas del núcleo después de que este sea controlado por un atacante. | ✕ No es independiente |
| Aplicación de la integridad de la memoria (MIE) | Comprueba los accesos a la memoria protegida; no puede hacer que un núcleo comprometido sea fiable. | ✕ Sin garantía general |
| Monitor de tabla de páginas seguras (SPTM) | Con TXM, se imponen restricciones de tabla de páginas seleccionadas que quedan fuera del control habitual del núcleo. | ⚠ Restricciones seleccionadas |
| Secure Enclave | Un procesador y un microkernel independientes protegen determinadas claves y operaciones. | ✓ Dentro de sus límites |
SPTM puede preservar ciertas restricciones de memoria tras una posible vulneración del núcleo, y Secure Enclave puede proteger las claves designadas. Ninguno de estos sistemas restablece la confianza en el sistema operativo por sí solo.
Un iPhone puede ser compatible con MIE y PAC, pero eso no significa que todas las aplicaciones que se ejecutan en él utilicen ambas protecciones. Apple implementa MIE automáticamente en determinadas superficies de ataque del sistema, incluido el kernel. Esta cobertura no se extiende automáticamente a todas las aplicaciones, extensiones, procesos auxiliares o bibliotecas de terceros. Por lo tanto, dos aplicaciones en el mismo iPhone compatible pueden tener protecciones diferentes. MIE combina hardware diseñado por Apple, asignadores de memoria seguros y controles del sistema operativo; no es simplemente la extensión de etiquetado de memoria (MTE) general de Arm.
Para usar el etiquetado de memoria por hardware en sus propias aplicaciones, los desarrolladores deben habilitarlo para los destinos de Xcode correspondientes y confirmar que el hardware lo admite. Los permisos y la configuración de tiempo de ejecución también son importantes: un modo de diagnóstico que informa fallos simulados no es lo mismo que aplicar las comprobaciones. PAC es una mitigación independiente. El hardware compatible por sí solo no significa que cada binario de la aplicación use PAC; el código correspondiente debe compilarse para la arquitectura arm64e adecuada, y las bibliotecas nativas externas necesitan compilaciones compatibles. Los desarrolladores deben verificar qué protecciones están habilitadas en la versión actual, incluidos sus componentes y dependencias, y realizar pruebas en dispositivos físicos compatibles. Una especificación de dispositivo no es prueba de que las protecciones funcionen en una aplicación en particular. [47] [48] [49]
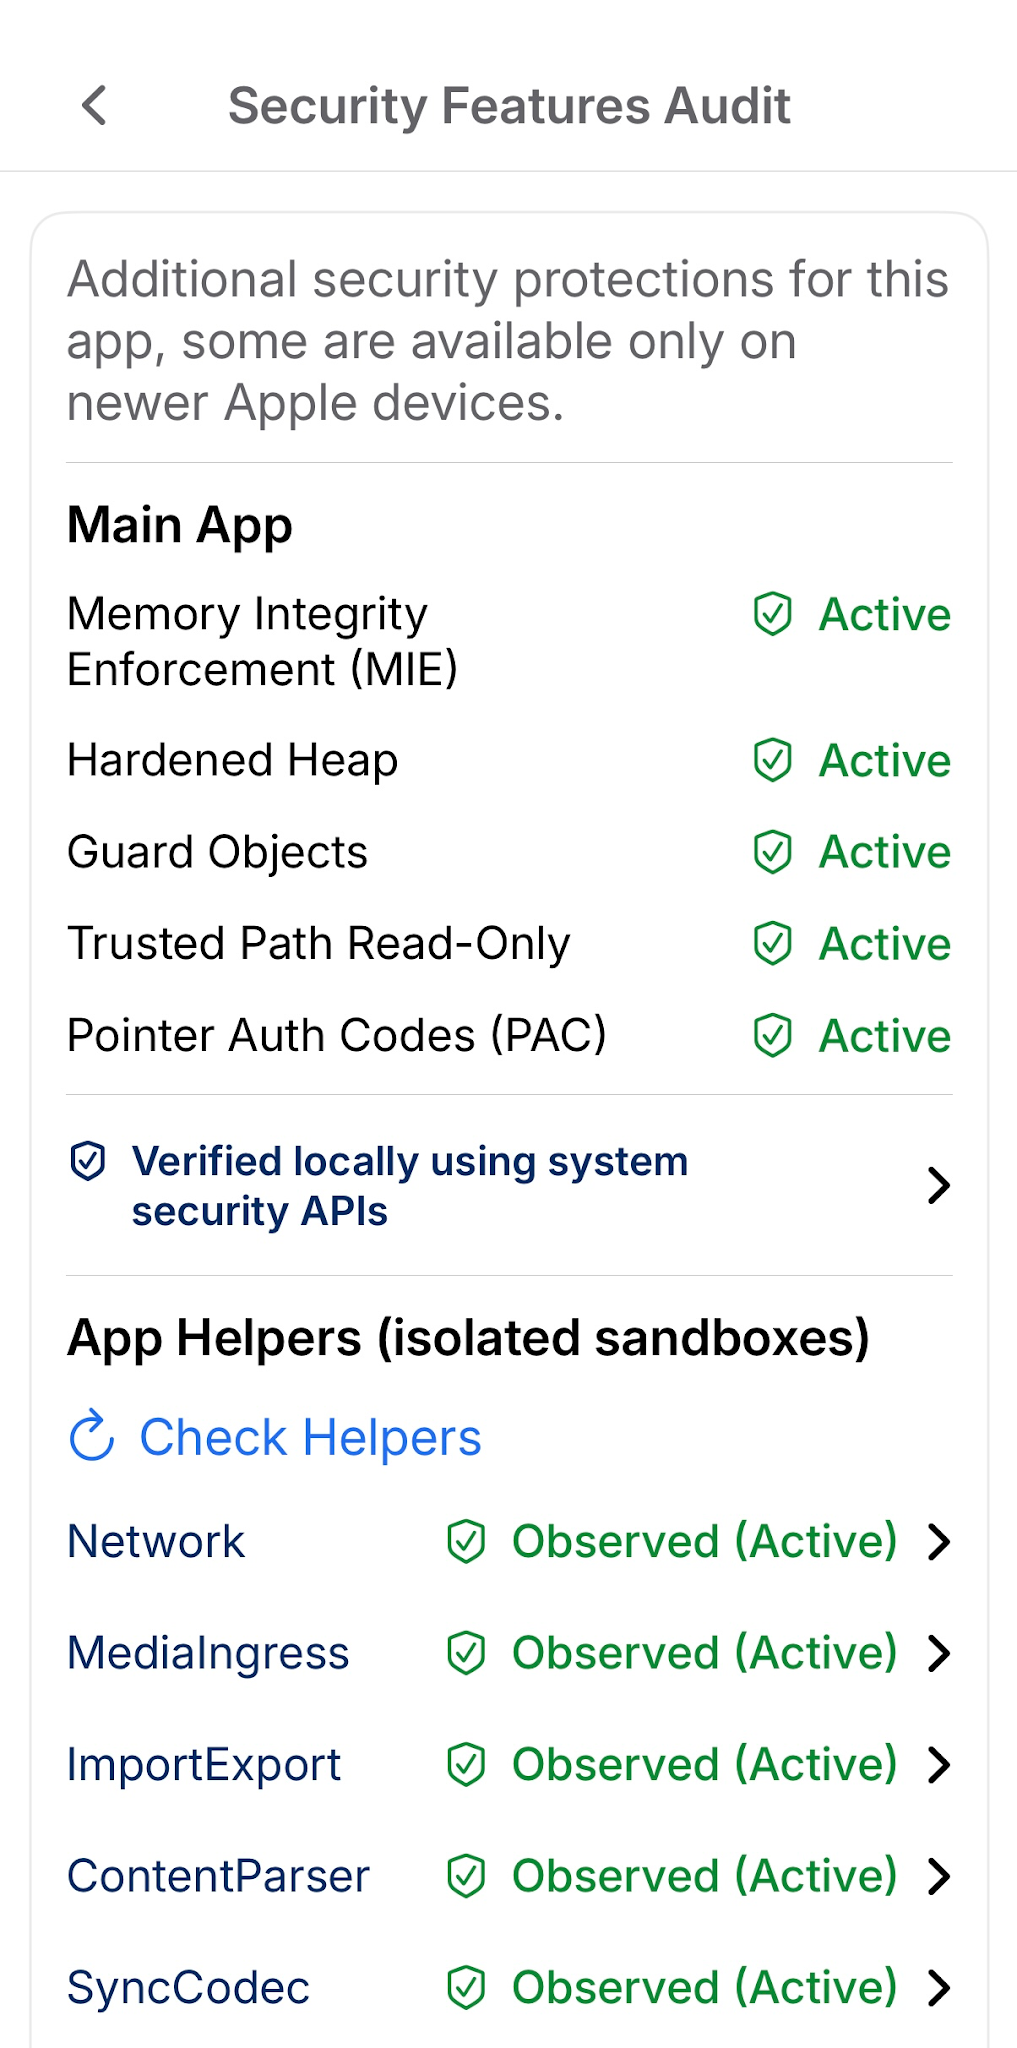
Un diagrama de arquitectura o una lista de características no permiten determinar qué medidas de seguridad son efectivas en el producto final. La información relevante reside en qué procesos están realmente protegidos, qué autoridad aplica cada restricción y qué permanece protegido ante las condiciones de fallo consideradas.
Cuando fallan las medidas de seguridad
Las restricciones de seguridad deben mantenerse incluso cuando falla una verificación u operación requerida. Si un servicio de autorización no está disponible, la falta de una decisión no otorga permiso para continuar. Si un cambio de varios pasos se interrumpe a la mitad, los registros parcialmente actualizados pueden infringir las reglas que la operación pretendía preservar. La respuesta debe estar definida para la tarea específica: rechazar o aplazar una acción no verificada, preservar un estado coherente y permitir la recuperación del trabajo interrumpido. Tratar un error como una aprobación es un defecto de fallo abierto; tampoco es un diseño adecuado tratar cada error como una interrupción permanente. [50]
Una vulneración no necesariamente se detiene en la primera cuenta o proceso alcanzado. Un atacante puede usar ese punto de acceso para obtener permisos superiores, lo que se denomina escalada de privilegios, o para acceder a sistemas adicionales, lo que se denomina movimiento lateral. Cada paso posterior depende de otra vulnerabilidad aprovechable, credencial o relación de confianza; el control de un servicio no implica automáticamente el control de los demás. Por ello, la autoridad disponible en el punto de acceso inicial, la separación entre sistemas y las comprobaciones de las solicitudes privilegiadas determinan hasta dónde puede propagarse un ataque. La contención puede interrumpir la progresión incluso después de que el primer componente se haya visto comprometido. [51] [52]
La recuperación operativa es crucial cuando la prevención y la contención no son suficientes. Un atacante que obtiene el control administrativo puede modificar registros, borrar archivos o implementar ransomware que inutilice los datos. Una copia de seguridad puede reducir el daño causado por la destrucción o la corrupción, pero no revierte la información ya robada. Una copia de seguridad almacenada con los mismos permisos comprometidos también puede ser alterada o borrada por el atacante. Por lo tanto, las copias recuperables y debidamente protegidas, así como los procedimientos que verifican la restauración, son importantes junto con los parches de seguridad. La monitorización puede detectar actividad inusual y preservar evidencia; los procedimientos de incidentes definen quién puede aislar los sistemas afectados, revocar credenciales y restaurar un servicio confiable. Estas medidas no implican admitir que el diseño seguro haya fallado. Reconocen que proteger un sistema incluye limitar el daño de las fallas que aún son posibles y devolver el trabajo legítimo a un estado correcto conocido. [38]
Cuando la cadena de suministro compromete la seguridad
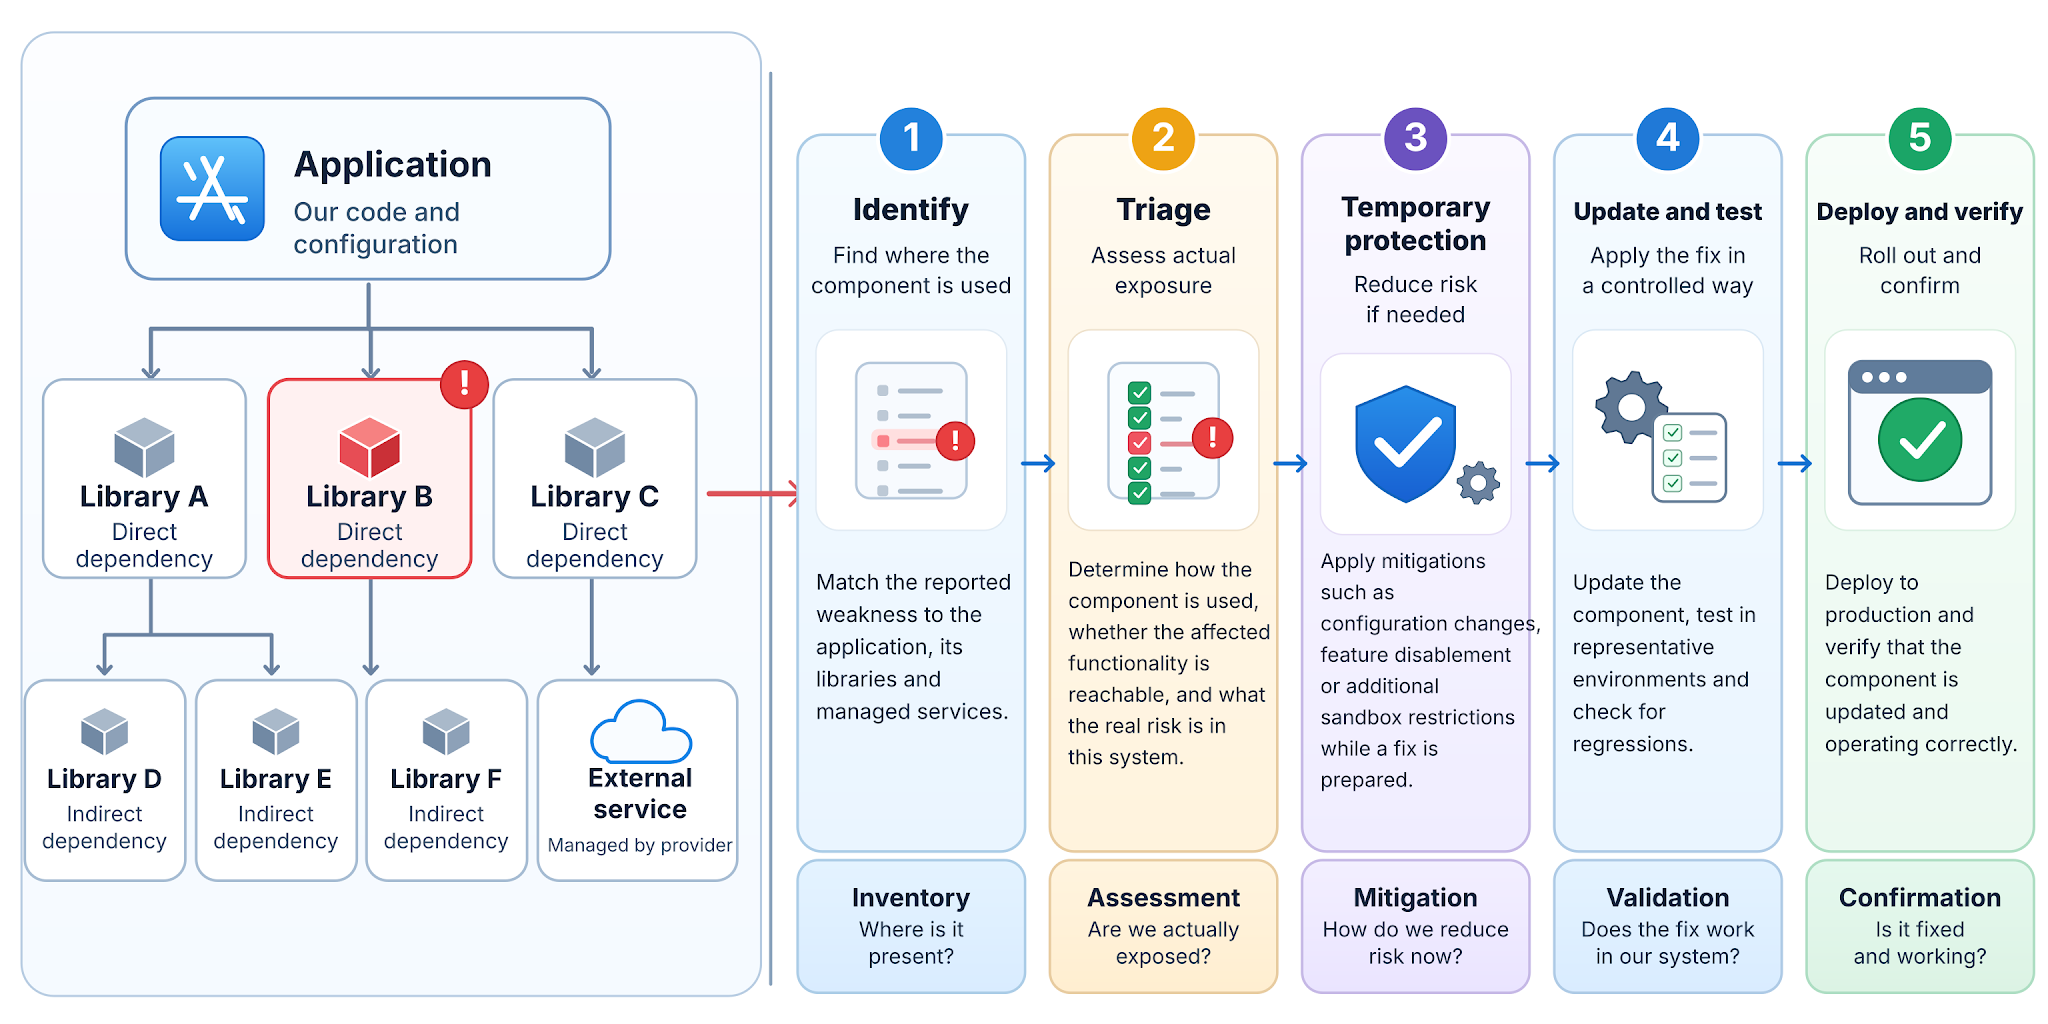
Incluso una aplicación pequeña depende de software escrito, desarrollado y mantenido por terceros: componentes del sistema operativo, bibliotecas, herramientas de desarrollo y servicios externos. Un fallo reportado puede ser relevante solo si existe una versión afectada y se expone una operación pertinente, pero determinarlo puede resultar difícil debido a dependencias mantenidas con diferentes plazos. Por lo tanto, el nombre de un producto dice poco sobre los componentes y servicios realmente involucrados en su funcionamiento. [53]
Una comparación útil es la lista de ingredientes. Un fabricante que no puede identificar los ingredientes de un producto no puede determinar fácilmente si un problema recién descubierto afecta a dicho producto. El software presenta la misma dificultad. Una lista de materiales de software (SBOM, por sus siglas en inglés) registra los componentes y las versiones para mejorar la visibilidad, incluyendo las dependencias obtenidas a través de otras dependencias. Ayuda a una organización a determinar si existe una biblioteca vulnerable reportada, pero no constituye un certificado de seguridad. El inventario puede estar incompleto, el código vulnerable puede ser inaccesible o un componente ausente en una versión puede aparecer en la siguiente. El inventario resulta útil cuando se mantiene actualizado, se conecta con lo que realmente se ha implementado y se complementa con un proceso para evaluar y reparar los sistemas afectados. [54]
El SoK 2026 de Abu Ishgair y sus colegas utiliza el modelo AStRA para examinar los actores, pasos, recursos y artefactos involucrados en la producción y distribución de software. Distingue las preguntas que un SBOM puede responder de aquellas que requieren evidencia sobre cambios en el código fuente, integridad de la compilación, autoridad de lanzamiento y entrega. Un inventario completo no establece que una compilación sea confiable, y la procedencia no establece que el programa resultante esté libre de defectos. La evidencia debe coincidir con el riesgo específico de la cadena de suministro que se está evaluando. [55]
Saber qué componentes están presentes no garantiza que su contenido o distribución sean confiables. Un atacante puede introducir comportamiento malicioso en una dependencia, repositorio de código fuente, proceso de compilación o actualización de software, de modo que los usuarios reciban código dañino como parte de una versión aparentemente legítima. Esto constituye una vulneración de la cadena de suministro de software, distinta del descubrimiento de una vulnerabilidad accidental en un componente. Verificar el origen y la integridad de un paquete puede ayudar a detectar sustituciones no autorizadas, pero incluso una versión firmada correctamente puede ser maliciosa si el proveedor o su proceso de compilación se vieron comprometidos. Por lo tanto, proteger la entrega de software también requiere controles sobre quién puede modificar el código y las versiones, cómo se manejan las credenciales de compilación y qué evidencia vincula un artefacto entregado con su origen previsto. Un SBOM identifica los componentes; no certifica que su contenido o ruta de entrega sean seguros. [53]
El software no viaja directamente del editor del programador al dispositivo del usuario. El código pasa por mantenedores, repositorios, herramientas de compilación, servicios automatizados, claves de firma, aprobadores de versiones y canales de distribución. Un revisor puede examinar el código fuente y aun así pasar por alto un cambio malicioso introducido durante el empaquetado; un compilador estrictamente controlado ofrece poca protección si un intruso puede autorizar lo que compila. Separar y verificar estas responsabilidades es importante porque una versión aparentemente legítima puede haber sido alterada en una etapa invisible para el usuario final. [56]
La puerta trasera de xz Utils de 2024 expuso este problema con una claridad inusual. El material malicioso se ocultó en los archivos de lanzamiento y se configuró para afectar ciertas compilaciones de paquetes de Linux, lo que podría comprometer la autenticación de inicio de sesión remoto en sistemas con dependencias específicas. El archivo de lanzamiento distribuido no era simplemente equivalente al código fuente que un revisor podría inspeccionar en el repositorio público: el proceso de compilación determinaba qué terminaba en el software. El ataque se detectó antes de que las versiones afectadas se generalizaran en las distribuciones estables de Linux, pero demostró que un lanzamiento aparentemente autorizado podía introducir deliberadamente funcionalidades maliciosas en los paquetes derivados. Por eso, confiar en un proyecto conocido o en su ruta de descarga oficial no es suficiente. Se trató de una vulneración de la cadena de suministro, no de un defecto de programación accidental. [57] [58]
La procedencia de la compilación intenta vincular un ejecutable entregado con el código fuente, las herramientas, la configuración y el servicio que lo produjeron. Las compilaciones reproducibles pueden proporcionar evidencia adicional cuando partes independientes obtienen resultados coincidentes a partir del mismo código fuente. Marcos como SLSA describen formas de registrar y verificar este historial. Sin embargo, un registro es tan confiable como los sistemas que lo producen y las expectativas independientes con las que se compara. Un código fuente comprometido puede compilarse de forma reproducible; un servicio de compilación corrupto puede generar falsas garantías; una declaración firmada que nadie verifica tiene poca validez. La procedencia puede establecer partes de una cadena de custodia, pero no si el software subyacente se comporta de forma segura. [59] [60]
La firma y distribución de versiones presentan un límite distinto. Una firma digital válida puede demostrar que un artefacto se firmó con una clave específica y que no ha cambiado posteriormente. Sin embargo, no puede establecer que el firmante fuera de confianza, que la clave no fuera robada ni que el programa firmado sea seguro. Una versión firmada es prueba de autorización mediante una clave, no un certificado de inocuidad. HTTPS protege la conexión a un sitio web de descarga; no garantiza que el sitio web, su cuenta de editor o la descarga en sí no se hayan visto comprometidos. Una suma de verificación mostrada en esa misma página comprometida ofrece poca seguridad independiente. Por lo tanto, los sistemas de actualización segura también verifican el editor esperado, los metadatos de confianza, las versiones y las autoridades de firma permitidas, con protecciones contra la reversión a versiones antiguas vulnerables. Estas comprobaciones reducen ciertos ataques sin eliminar la necesidad de confiar en el proceso de publicación y protegerlo. [61]
La cadena de suministro de hardware introduce un problema relacionado que resulta más difícil de inspeccionar. Un chip puede comenzar con un diseño cuidadosamente revisado, incorporar circuitos o componentes de diseño de otros proveedores y pasar por las fases de fabricación, prueba, empaquetado, transporte e integración. El diseño teórico puede ser sólido, pero eso no garantiza que el silicio enviado al cliente sea fiel a él. Un adversario con acceso a las etapas relevantes podría, en principio, modificar los circuitos, insertar un troyano de hardware oculto, sustituir componentes o alterar el firmware asociado durante la fabricación o la entrega. Estas son amenazas reconocidas que deben evaluarse, pero no constituyen prueba de que un fabricante o dispositivo en particular haya sido comprometido. [62] [63]
Un plano verificado no es un chip verificado. Comprobar el funcionamiento normal, probar muestras, examinar los registros de producción, utilizar proveedores de confianza, mantener registros de custodia y autenticar componentes pueden reforzar la seguridad del hardware. Sin embargo, un comportamiento del circuito poco frecuente o deliberadamente oculto puede escapar a las pruebas rutinarias, y la propia identidad o mecanismo de certificación de un dispositivo depende del hardware y las claves cuyo origen también debe ser fiable. El arranque seguro solo puede verificar el software posterior en la medida en que el punto de partida de fabricación de dicha verificación sea fiable. Ningún certificado o inspección por sí solo demuestra la ausencia de una modificación maliciosa en toda la cadena. [62] [63]
Mantenimiento y la carrera por corregir fallos
Las actualizaciones merecen especial atención porque a menudo corrigen defectos que ya se conocen lo suficientemente bien como para ser reparados. Una vez que se hacen públicos los detalles de una vulnerabilidad, los atacantes pueden buscar sistemas que aún ejecuten la versión afectada. Algunas vulnerabilidades ya se están explotando antes de que haya una solución disponible. Por lo tanto, retrasar las actualizaciones puede dejar un sistema expuesto a métodos que ya no requieren una investigación original por parte del atacante. El trabajo necesario va más allá de hacer clic en un botón de actualización: una organización debe saber qué computadoras y servicios posee, qué versiones ejecutan, si existe una solución del proveedor, si alguna función afectada está expuesta y si el cambio se ha implementado correctamente. Los dispositivos y servicios que han llegado al final del soporte del proveedor presentan un problema diferente, ya que es posible que ya no se proporcionen correcciones de seguridad. [64]
La responsabilidad de actualizar abarca más allá de las aplicaciones visibles, incluyendo sistemas operativos, navegadores, enrutadores, complementos, software de servidor y firmware. Si bien los dispositivos de consumo pueden actualizarse automáticamente, las organizaciones también gestionan equipos poco utilizados, servicios heredados y sistemas de terceros cuyas versiones no son evidentes. Estos se pasan por alto fácilmente precisamente porque parecen funcionar correctamente. Un inventario preciso, un responsable identificado y la evidencia de que la actualización llegó al sistema en funcionamiento permiten distinguir un proceso de parcheo de una simple lista de correcciones publicadas.
Informar sobre una vulnerabilidad no es lo mismo que repararla. Una parte esencial de la respuesta es la evaluación inicial de seguridad: determinar si el software afectado está presente, si se puede acceder a la parte vulnerable, qué podría hacer un atacante con ella y si alguien ya la está explotando. Esto establece la urgencia del problema, quién debe actuar y qué evidencia aún debe verificarse. Una puntuación de gravedad puede ser útil, pero no puede determinar por sí sola el peligro para un producto en particular. La decisión de evaluación inicial debe revisarse cuando surjan nuevos datos o cambios en el software. Si la explotación está en curso, puede ser necesario comenzar a tomar medidas de protección antes de que se complete la evaluación. [65]
En ocasiones, aún no existe una solución. Incluso cuando se publica rápidamente, debe compararse con el producto, probarse para evitar que afecte a funciones importantes, distribuirse y verificarse en la versión que los usuarios realmente utilizan. Durante este período, una vulnerabilidad conocida aún puede ser explotable. Puede ser necesario restringir el acceso, deshabilitar una función afectada, aislar un servicio o, si es preciso, desconectarlo. Estas medidas temporales deben supervisarse y revisarse hasta que se corrija el defecto. La instalación de un parche tampoco deshace un ataque que ya se haya producido. [65]
Los atacantes pueden actuar más rápido de lo que las soluciones llegan a quienes las necesitan. En estudios sobre vulnerabilidades que se observaron explotadas, Mandiant informó un tiempo promedio de explotación de 63 días para 2018-2019, 32 días para 2021-2022 y cinco días para 2023. Su informe de 2026 estimó para 2025 un tiempo medio de menos siete días (−7 días), lo que significa que la primera explotación observada precedió, en promedio, a la disponibilidad de parches en los casos estudiados. Estas son mediciones de vulnerabilidades explotadas seleccionadas, no cronogramas para cada fallo ni mediciones de la rapidez con la que los clientes instalan las actualizaciones. Los ataques de día cero afectan los promedios. La aceleración también comenzó antes de los sistemas de IA generativa actuales. [66] [67] [68]
El análisis asistido por IA añade presión a esta carrera ya de por sí difícil. Un parche publicado o un cambio en el código fuente puede revelar qué distingue una versión vulnerable de su reemplazo. Las herramientas automatizadas pueden ayudar a comparar las versiones, desarrollar pruebas candidatas e identificar sistemas expuestos, reduciendo el trabajo necesario para aprovechar una vulnerabilidad conocida. Una investigación de 2024 demostró que un agente basado en LLM podía explotar varias vulnerabilidades previamente divulgadas en condiciones controladas al proporcionarle sus descripciones. En septiembre de 2026, Google Threat Intelligence informó de un aumento observado en la explotación de vulnerabilidades de alto riesgo previamente divulgadas e identificó el análisis asistido por IA como un posible factor contribuyente, no como prueba de que la IA causara todos los incidentes. [69] [70]
Esta capacidad no se limita a los servicios de modelos cuyos operadores pueden supervisar o restringir las solicitudes. Algunos modelos de lenguaje potentes se publican con ponderaciones descargables y pueden ejecutarse o modificarse fuera del control de sus creadores; sus medidas de seguridad pueden estar ausentes, alteradas o eliminadas. Las evaluaciones públicas de 2026 revelaron modelos de ponderación abierta cada vez más capaces en tareas de ciberseguridad. Esto no convierte a todos los modelos en atacantes eficaces, ni facilita la explotación de todas las vulnerabilidades conocidas. La IA también ayuda a los defensores a revisar el código, descubrir defectos y preparar respuestas. Lo que cambia es el coste y la velocidad potencial de la búsqueda de debilidades, incluso por parte de actores que no necesitan respetar las restricciones del proveedor del modelo. [71] [72]
Publicar una solución no significa que los usuarios la hayan recibido. Los responsables de mantenimiento, distribuidores y operadores aún podrían necesitar integrar, probar, aprobar e implementar el cambio. Los atacantes pueden buscar instalaciones que hayan quedado sin corregir, mientras que una implementación apresurada puede generar nuevos fallos. Por lo tanto, la evaluación rápida, la protección temporal y la implementación verificada son responsabilidades complementarias, no sustitutas contrapuestas.
El diseño seguro es crucial precisamente porque no siempre es posible eliminar el período de exposición entre la detección de una vulnerabilidad y la aplicación de su corrección. El código seguro para la memoria puede prevenir algunos tipos de errores de memoria; los permisos estrictos y un entorno aislado pueden limitar el alcance de un componente comprometido; los límites de entrada y recursos pueden dificultar otros ataques. Estas protecciones son útiles tanto antes de que se descubra una vulnerabilidad como durante la preparación y prueba de una solución. La capacidad de soportar algunos fallos, limitar el daño y recuperarse forma parte de la resiliencia de seguridad; un sistema diseñado para tales condiciones también se describe como capaz de seguir prestando servicio y recuperarse ante ciertos fallos. Esto no prueba que el software vulnerable sea seguro, y nunca reemplaza el trabajo de corregir y verificar un defecto. [38]
La externalización no elimina estas responsabilidades. Un proveedor puede desarrollar una aplicación, operar un servicio en la nube, administrar dispositivos de oficina o mantener un sitio web, mientras que la organización que contrata el servicio sigue siendo responsable de decidir qué nivel de riesgo está dispuesta a asumir. Algunos proveedores son altamente competentes y disciplinados; otros distribuyen su atención de forma limitada entre demasiados clientes o proporcionan escasa evidencia de mantenimiento más allá de la entrega inicial. La debilidad relevante no reside en la mera presencia de un contratista externo, sino en un acuerdo en el que nadie puede identificar claramente las dependencias del sistema, aprobar el acceso, detectar defectos, aplicar cambios, validar las versiones o responder cuando algo falla. Los contratos, las descripciones de los servicios y las insignias pueden ayudar a definir las expectativas, pero un mantenimiento observable y una responsabilidad clara son más importantes que un lenguaje tranquilizador. [2]
El software de código abierto ofrece una valiosa forma de escrutinio, ya que su código puede ser inspeccionado y cuestionado más allá del equipo de desarrollo original. Sin embargo, el argumento habitual de que muchas personas pueden examinar el código no garantiza que suficientes personas cualificadas lo hagan, ni que los defectos reportados se resuelvan con prontitud. Los proyectos de código abierto abarcan desde organizaciones con gran financiación hasta pequeños equipos que mantienen componentes ampliamente utilizados; el software propietario también varía enormemente en cuanto a su revisión y mantenimiento. La actualización de seguridad de PHP de octubre de 2026 ilustra esta distinción. Tras corregir dos vulnerabilidades críticas, la Fundación PHP describió cómo las difíciles decisiones técnicas, la escasez de mantenedores experimentados y su proceso de toma de decisiones habían retrasado el trabajo en un problema subyacente. También reconoció el papel de los ingenieros financiados y los investigadores externos en la realización de las reparaciones. Los fallos implicaban memoria corrupta tras el agotamiento de los recursos y un estado interno obsoleto entre solicitudes, lo que vincula los mecanismos de memoria y gestión de errores mencionados anteriormente con el mantenimiento especializado necesario para reparar un entorno de ejecución ampliamente utilizado. La cuestión no es que el código abierto sea inherentemente más débil, ni que un producto cerrado sea más seguro. Es que la disponibilidad del código fuente crea una oportunidad para el escrutinio, mientras que la experiencia sostenida, la responsabilidad clara y el mantenimiento efectivo convierten los hallazgos en protección. [73]
El software también debe probarse en las condiciones en las que se utilizará. Una demostración exitosa de la función principal no revela mucho sobre lo que sucede cuando una cuenta incorrecta solicita un registro, dos operaciones entran en conflicto, un archivo está mal formado o un asistente con privilegios recibe un comando inesperado. La validación de seguridad comprueba si los requisitos definidos se cumplen en la versión y configuración implementadas. Puede combinar la revisión del código y las dependencias con pruebas de operaciones prohibidas y legítimas, así como la recuperación ante fallos. Las pruebas no pueden demostrar que no exista ninguna vulnerabilidad, y el resultado de una prueba realizada en el ordenador de un desarrollador puede no establecer las restricciones de un producto publicado. Por el contrario, la ausencia de una auditoría pública no prueba que un servicio sea inseguro. La evidencia creíble especifica qué se examinó, qué versión y configuración se utilizaron, qué se encontró y qué permanece incierto. [2]
Cómo evaluar una advertencia de seguridad
Los informes de noticias suelen condensar varios estados diferentes en un mismo vocabulario alarmante. Una debilidad es un defecto o condición insegura que podría causar daños en determinadas circunstancias. Una vulnerabilidad es una debilidad que puede utilizarse para socavar una propiedad de seguridad; un exploit es un método para explotarla. Afirmar que un fallo permite la ejecución remota de código significa que, bajo ciertas condiciones, un atacante puede hacer que un software ejecute código. Esto no demuestra, por sí solo, que una organización en particular haya sido atacada o que se hayan robado todos sus datos. Una brecha confirmada es evidencia de que se produjo un acceso no autorizado u otro evento que comprometa la seguridad, aunque el alcance total puede seguir bajo investigación. Las etiquetas de gravedad, las demostraciones de exploits y los hallazgos de incidentes responden a preguntas diferentes y no deben tratarse como sinónimos.
Un identificador público de vulnerabilidad, a menudo escrito como un número CVE, ayuda a diferentes organizaciones a debatir sobre la misma falla reportada. No es un registro de todas las instalaciones afectadas, ni prueba de una explotación exitosa. Una puntuación de gravedad estima las características de la falla utilizando un modelo de puntuación establecido; la urgencia operativa aún depende del entorno y de lo que un atacante pueda alcanzar. El término "día cero" se usa a menudo para una falla que se explota antes de que haya una solución efectiva disponible o antes de que su defensor la conozca, aunque las convenciones de reporte varían. Su importancia radica en la limitada oportunidad del defensor para reparar la debilidad con anticipación, no en el misticismo del nombre. Una vulnerabilidad de hace años con un parche publicado aún puede ser una emergencia inmediata si se está explotando contra máquinas expuestas que nunca se actualizaron. [74] [75]
El primer factor para evaluar la gravedad práctica es la accesibilidad. Un atacante que ya debe tener el control físico de una máquina bloqueada se enfrenta a condiciones diferentes a las de uno que puede enviar una solicitud a un servicio público. Una vulnerabilidad en una función opcional poco utilizada difiere de la misma vulnerabilidad en un servicio con acceso a internet, aunque ambas pueden requerir reparación. El segundo factor es la autoridad: las consecuencias dependen de si el código afectado puede leer información pública, acceder a registros privados, modificar cuentas, ejecutar comandos o influir en un administrador a través de un servicio delegado. El tercer factor es la exposición y la evidencia: la versión afectada debe estar presente físicamente, la ruta vulnerable debe ser utilizable en las condiciones pertinentes y los informes de explotación activa tienen una importancia más inmediata que una mera posibilidad teórica. [1]
La remediación es el cuarto factor. Un proveedor puede haber emitido ya una solución, un servicio puede haberla implementado o una organización puede estar investigando qué sistemas se ven afectados. Un parche puede eliminar el defecto inmediato sin demostrar que se hayan examinado todos los sistemas potencialmente comprometidos. Si la explotación pudo haber ocurrido antes de la solución, también pueden ser necesarias la investigación, los cambios de credenciales y la restauración de un estado confiable. Las declaraciones creíbles distinguen una vulnerabilidad encontrada, un intento de ataque bloqueado, un acceso no autorizado confirmado y un daño que se ha constatado. La incertidumbre es normal durante un incidente; la certeza sin fundamento no sustituye a la evidencia. [65]
Estas distinciones también facilitan la evaluación de las afirmaciones de seguridad de proveedores y contratistas. La evidencia de un inventario de componentes actualizado, la clara responsabilidad de los parches, pruebas de lanzamiento significativas, acceso privilegiado controlado y un proceso de respuesta a incidentes eficaz son más informativas que una promesa de seguridad total. Las mismas preguntas se aplican independientemente de si el trabajo lo realiza una gran empresa tecnológica, un pequeño equipo de desarrollo o una agencia externa. El tamaño de la organización no es prueba de competencia ni evidencia de negligencia. Lo que importa es la capacidad de identificar un problema, explicar su alcance, corregirlo y demostrar que la corrección está presente en el sistema del que realmente dependen las personas. [2]
En resumen
La seguridad del software es compleja porque una operación puede ser técnicamente válida y aun así ejecutarse en condiciones inadecuadas. Un sistema puede aceptar una contraseña presentada por un impostor, un servicio privilegiado puede actuar en nombre de un usuario no autorizado, una verificación puede quedar obsoleta, datos maliciosos pueden interpretarse como código o un fallo de memoria puede eludir una regla aplicada en otro lugar. Las dependencias, los procesos de compilación, el firmware y el mantenimiento añaden más posibilidades de que una medida de seguridad sea inexistente o ineficaz. Cada fallo tiene una causa diferente, por lo que para garantizar la seguridad es necesario comprender el proceso que va desde la influencia del atacante hasta la acción consecuente.
Las declaraciones de seguridad más útiles son específicas. Identifican qué debe permanecer protegido, qué capacidades del atacante se consideran, qué puede hacer el componente afectado, qué medidas de seguridad operan de forma independiente y qué evidencia proviene de las pruebas de la configuración publicada. También explican cómo se supervisan las dependencias, cómo se priorizan las vulnerabilidades reportadas, cómo se limita el riesgo durante la preparación de las actualizaciones y cómo se verifica la implementación. Los desarrolladores y operadores siguen siendo responsables de brindar estas protecciones. Quienes dependen del software no necesitan convertirse en investigadores de seguridad para exigir respuestas creíbles en lugar de aceptar una etiqueta, un certificado o una demostración exitosa como prueba.
Cosas que debes saber:
| N.º | Término | Significado |
|---|---|---|
| 1 | Superficie de ataque | Los puntos por donde un atacante podría entrar, proporcionar información, provocar un efecto o extraer información, incluidos los servicios e interfaces expuestos. |
| 2 | Autenticación | Verificar la identidad declarada dentro de las garantías del método utilizado. |
| 3 | Autorización | Comprobar si un actor puede realizar una acción determinada sobre un recurso determinado bajo las condiciones pertinentes. |
| 4 | Disponibilidad | Un servicio que siga siendo utilizable en las condiciones para las que fue diseñado. |
| 5 | Alcance del impacto | La información, las operaciones u otros recursos que un fallo o una vulneración puedan ver afectados, directamente o a través de otros componentes. |
| 6 | Fallo de lógica empresarial | El incumplimiento de la secuencia permitida, los requisitos previos o los límites de una operación, incluso cuando las solicitudes individuales están bien formuladas y autenticadas. |
| 7 | Confidencialidad | La información se divulgará únicamente a los destinatarios autorizados. |
| 8 | Problema del intermediario privilegiado (confused deputy) | Un componente más potente que actúa indebidamente en nombre de un solicitante que carece del permiso necesario. |
| 9 | Vulnerabilidad de diseño | Una debilidad en las reglas, permisos, protocolo o flujo de trabajo previstos de un sistema que permite que se infrinja un requisito de seguridad incluso cuando el software sigue ese diseño. |
| 10 | Permitir continuar si falla el control (fail-open) | Un fallo en el manejo de errores en el que una comprobación de seguridad no disponible o fallida se interpreta como una autorización para continuar. |
| 11 | Endurecimiento de sistemas | Reducir la exposición de un sistema desactivando servicios y funciones innecesarias, restringiendo el acceso y los permisos, y verificando la configuración implementada. |
| 12 | Implementación | El código y la configuración que ponen en práctica un diseño o protocolo; pueden faltar controles de seguridad incluso cuando el diseño es sólido. |
| 13 | Vulnerabilidad por inyección | Fallo que permite que datos externos alteren el significado de un comando, una consulta u otro contenido interpretado, en vez de tratarse únicamente como datos. |
| 14 | Uso indebido de accesos internos | Uso perjudicial del acceso concedido legítimamente a una persona, incluyendo la divulgación o acciones que excedan su propósito autorizado. |
| 15 | Integridad | Protección contra la alteración no autorizada o involuntaria de la información o del estado del sistema. |
| 16 | Movimiento lateral | Un atacante extiende el acceso desde un punto de entrada inicial a otras cuentas, servicios o sistemas. |
| 17 | Principio del mínimo privilegio | Restringir a cada persona o componente el acceso y las operaciones necesarias para su trabajo, incluidas las solicitudes a otros servicios. |
| 18 | Memory Integrity Enforcement (MIE) | Las protecciones de Apple en los dispositivos compatibles combinan comprobaciones de memoria de hardware con restricciones de software y del sistema operativo para impedir algunos ataques de corrupción de memoria. |
| 19 | Seguridad de memoria | Se evitan las operaciones de memoria no válidas, incluido el acceso fuera de los límites y el uso del almacenamiento fuera de su período de validez. Las reglas y comprobaciones del lenguaje seguro garantizan las protecciones definidas. |
| 20 | Configuración errónea | Una configuración que expone datos, servicios, permisos o capacidades más allá de lo que requiere el uso previsto del sistema, incluidos los servicios innecesarios que se dejan habilitados. |
| 21 | Autenticación de punteros (PAC) | Verifica punteros seleccionados para dificultar ciertos ataques de corrupción de memoria y de flujo de control; no aplica políticas del kernel de forma independiente. |
| 22 | Escalada de privilegios | Obtener mayores permisos o autoridad de ejecución tras explotar una vulnerabilidad, una credencial u otra debilidad. |
| 23 | Protocolo | Las reglas que rigen el intercambio de mensajes y las comprobaciones necesarias entre sistemas que interactúan entre sí, así como el diseño seguro de dichas reglas y su correcta implementación, son tareas independientes. |
| 24 | Posibilidad de acceso a la función afectada | Si un atacante puede acceder a una operación afectada en la configuración y las circunstancias de una implementación real. |
| 25 | Entorno aislado (sandbox) | El sistema operativo impone límites a los recursos a los que un proceso puede acceder directamente. El proceso aún puede causar efectos indirectos a través de otros servicios. |
| 26 | Arranque seguro | Cadena de comprobaciones de arranque que verifica la autorización de cada etapa posterior, partiendo de una raíz de confianza. |
| 27 | Secure Enclave | Un procesador de seguridad independiente de Apple con su propio microkernel que aplica reglas para determinados secretos y operaciones criptográficas. |
| 28 | Control de seguridad | Mecanismo o procedimiento aplicado para preservar una propiedad de seguridad o bloquear una vía que podría causar daños. |
| 29 | Resiliencia de seguridad | La capacidad de resistir, contener y recuperarse de fallos de seguridad, preservando o restableciendo al mismo tiempo los servicios necesarios. |
| 30 | Evaluación inicial y priorización de vulnerabilidades | Evaluar si una vulnerabilidad reportada afecta al software implementado, si es accesible, qué podría permitir y con qué urgencia se debe responder. |
| 31 | Secuestro de sesión | Utilizar un identificador de sesión o token comprometido para realizar solicitudes como una cuenta autenticada. |
| 32 | Ingeniería social | Utilizar el engaño o la manipulación para inducir la divulgación de información, conceder acceso u obtener acciones que sirvan a los propósitos del atacante. |
| 33 | Lista de materiales de software (SBOM) | Un inventario de componentes y versiones de software, incluidas las dependencias, utilizado para evaluar si puede existir un problema reportado. |
| 34 | Compromiso de la cadena de suministro de software | Alteración maliciosa de una dependencia, fuente, proceso de compilación, lanzamiento o distribución para que el código dañino pueda llegar a los usuarios finales. |
| 35 | Modelo de amenazas | Un análisis de lo que debe protegerse, cómo un adversario puede influir en el sistema, qué resultados importan y los supuestos en los que se basan las medidas de protección. |
| 36 | Intervalo entre comprobación y uso (TOCTOU) | Un lapso en el que el recurso o estado relevante puede cambiar entre el momento de la verificación y el momento de su uso, invalidando la decisión anterior. |
| 37 | Canal lateral basado en tiempos de ejecución | Fuga de información a través de diferencias medibles en la sincronización de las operaciones, en lugar de la salida prevista. |
| 38 | Entrada no fiable | Información cuyas propiedades relevantes no se han establecido para el uso previsto, ya sea que se haya proporcionado de forma maliciosa o inocente. |
| 39 | Uso de memoria después de liberarla (use-after-free) | Acceder al almacenamiento a través de una referencia después de que el objeto original haya sido liberado, a veces incluso después de que esa memoria haya sido reutilizada. |
| 40 | Validación | Verificar si una entrada, solicitud, operación o sistema cumple con los requisitos definidos bajo las condiciones evaluadas. |
Referencias
Las fuentes numeradas se citan en el texto. n.d. indica que no se ha indicado la fecha de publicación.
- National Institute of Standards and Technology (2012). Guide for Conducting Risk Assessments. NIST Special Publication 800-30 Rev. 1. DOI: 10.6028/NIST.SP.800-30r1.
- National Institute of Standards and Technology (2022). Secure Software Development Framework (SSDF) Version 1.1: Recommendations for Mitigating the Risk of Software Vulnerabilities. NIST Special Publication 800-218. DOI: 10.6028/NIST.SP.800-218.
- OWASP Foundation (n.d.). Authentication Cheat Sheet. OWASP Cheat Sheet Series.
- Cybersecurity and Infrastructure Security Agency and Federal Bureau of Investigation (2025). Product Security Bad Practices: Updated Guidance. CISA/FBI advisory, 17 January 2025.
- OWASP Foundation (n.d.). Session Management Cheat Sheet. OWASP Cheat Sheet Series.
- Zhuo, S., Biddle, R., Koh, Y. S., Lottridge, D. and Russello, G. (2023). SoK: Human-centered Phishing Susceptibility. ACM Transactions on Privacy and Security, 26(3), Article 24. DOI: 10.1145/3575797.
- OWASP Foundation (n.d.). Authorization Cheat Sheet. OWASP Cheat Sheet Series.
- Hardy, N. (1988). The Confused Deputy (or Why Capabilities Might Have Been Invented). ACM SIGOPS Operating Systems Review, 22(4), pp. 36–38. DOI: 10.1145/54289.871709.
- OWASP Foundation (n.d.). Authorization Patterns Cheat Sheet. OWASP Cheat Sheet Series.
- The Chromium Project (n.d.). Sandbox Design. Chromium design documentation.
- National Institute of Standards and Technology (n.d.). Insider Threat. NIST CSRC Glossary.
- OWASP Foundation (n.d.). Business Logic Security Cheat Sheet. OWASP Cheat Sheet Series.
- MITRE (n.d.). CWE-367: Time-of-check Time-of-use (TOCTOU) Race Condition. Common Weakness Enumeration.
- OWASP Foundation (n.d.). Input Validation Cheat Sheet. OWASP Cheat Sheet Series.
- OWASP Foundation (n.d.). SQL Injection Prevention Cheat Sheet. OWASP Cheat Sheet Series.
- OWASP Foundation (n.d.). Cross Site Scripting Prevention Cheat Sheet. OWASP Cheat Sheet Series.
- The Rust Project (n.d.). The Rust Programming Language: References and Borrowing; Unsafe Rust. Rust language documentation.
- The Swift Project (n.d.). Memory Safety. The Swift Programming Language, Swift.org.
- Python Software Foundation (n.d.). Extending and Embedding the Python Interpreter. Python 3 documentation.
- Szekeres, L., Payer, M., Wei, T. and Song, D. (2013). SoK: Eternal War in Memory. IEEE Symposium on Security and Privacy, pp. 48–62. DOI: 10.1109/SP.2013.13.
- Anderson, R. (1993). Why Cryptosystems Fail. Proceedings of the 1st ACM Conference on Computer and Communications Security, pp. 215–227. DOI: 10.1145/168588.168615.
- Internet Engineering Task Force (2023). Service Identity in TLS. RFC 9525.
- Internet Engineering Task Force (2020). JSON Web Token Best Current Practices. RFC 8725.
- Rescorla, E. (2018). The Transport Layer Security (TLS) Protocol Version 1.3. IETF RFC 8446. DOI: 10.17487/RFC8446.
- Clark, J. and van Oorschot, P. C. (2013). SoK: SSL and HTTPS: Revisiting Past Challenges and Evaluating Certificate Trust Model Enhancements. IEEE Symposium on Security and Privacy. DOI: 10.1109/SP.2013.41.
- National Institute of Standards and Technology (n.d.). Side Channel. NIST CSRC Glossary.
- Anderson, R. and Needham, R. (1995). Programming Satan's Computer. In Computer Science Today, pp. 426–440. DOI: 10.1007/BFB0015258.
- Kim, Y., et al. (2014). Flipping Bits in Memory Without Accessing Them: An Experimental Study of DRAM Disturbance Errors. Proceedings of the 41st International Symposium on Computer Architecture, pp. 361–372. DOI: 10.1109/ISCA.2014.6853210.
- Seaborn, M. and Dullien, T. (2015). Exploiting the DRAM Rowhammer Bug to Gain Kernel Privileges. Google Project Zero research, March 2015.
- Kocher, P., et al. (2018). Spectre Attacks: Exploiting Speculative Execution. arXiv:1801.01203, security research preprint.
- Lipp, M., et al. (2018). Meltdown: Reading Kernel Memory from User Space. 27th USENIX Security Symposium.
- Intel (n.d.). Analysis of Speculative Execution Side Channels. Intel Software Security Guidance.
- NVIDIA (2018). Security Notice: NVIDIA Tegra RCM Vulnerability. NVIDIA Product Security Notice, 24 April 2018.
- Temkin, K. and ReSwitched (2018). Fusée Gelée: Boot ROM Vulnerability Disclosure. Research disclosure.
- National Institute of Standards and Technology (2018). Platform Firmware Resiliency Guidelines. NIST Special Publication 800-193. DOI: 10.6028/NIST.SP.800-193.
- Glosner, C. and Machiry, A. (2026). SoK: All You Ever Wanted to Know About Bootloader Security but Were Afraid to Ask. IEEE Symposium on Security and Privacy. DOI: 10.1109/SP63933.2026.00163.
- Lefeuvre, H., Dautenhahn, N., Chisnall, D. and Olivier, P. (2025). SoK: Software Compartmentalization. IEEE Symposium on Security and Privacy. DOI: 10.1109/SP61157.2025.00075.
- Ross, R., Pillitteri, V., Graubart, R., Bodeau, D. and McQuaid, R. (2021). Developing Cyber-Resilient Systems: A Systems Security Engineering Approach. NIST Special Publication 800-160, Vol. 2 Rev. 1. DOI: 10.6028/NIST.SP.800-160v2r1.
- Apple (n.d.). Operating System Integrity. Apple Platform Security.
- Apple Security Research (2025). Memory Integrity Enforcement: A Complete Vision for Memory Safety in Apple Devices. Apple Security Research technical blog.
- Apple (n.d.). Secure Enclave. Apple Platform Security.
- Apple Developer (n.d.). Protecting Keys with the Secure Enclave. Apple Developer Documentation, Security.
- Microsoft (n.d.). Trusted Platform Module (TPM) fundamentals. Microsoft Learn.
- Arm (n.d.). TrustZone for Cortex-A. Arm Technologies.
- Intel (n.d.). Intel Software Guard Extensions SDK for Linux OS. Intel Developer Documentation.
- Zinkus, M., Jois, T. M. and Green, M. (2022). SoK: Cryptographic Confidentiality of Data on Mobile Devices. Proceedings on Privacy Enhancing Technologies, 2022(1), pp. 586–607. DOI: 10.2478/popets-2022-0029.
- Apple Developer (n.d.). Enabling Enhanced Security for Your App. Apple Developer Documentation, Xcode.
- Apple Developer (n.d.). Preparing Your App to Work with Pointer Authentication. Apple Developer Documentation, Security.
- LLVM Project (n.d.). Pointer Authentication. Clang Compiler Documentation.
- OWASP Foundation (2025). A10: Mishandling of Exceptional Conditions. OWASP Top 10: 2025.
- MITRE (n.d.). Privilege Escalation (TA0004). MITRE ATT&CK knowledge base.
- MITRE (n.d.). Lateral Movement (TA0008). MITRE ATT&CK knowledge base.
- OWASP Foundation (2025). A03: Software Supply Chain Failures. OWASP Top 10: 2025.
- Cybersecurity and Infrastructure Security Agency and international partners (2026). 2026 Minimum Elements for a Software Bill of Materials (SBOM). Joint government guidance.
- Abu Ishgair, E., Gomez, J., Melara, M. S., Cárdenas, A. A. and Torres-Arias, S. (2026). SoK: A Defense-Oriented Evaluation of Software Supply Chain Security. IEEE European Symposium on Security and Privacy, pp. 836–859. DOI: 10.1109/EuroSP68448.2026.00059.
- Boyens, J., et al. (2024). Cybersecurity Supply Chain Risk Management Practices for Systems and Organizations. NIST SP 800-161 Rev. 1, Update 1.
- Arasaratnam, O., et al. (2024). xz Backdoor CVE-2024-3094. Open Source Security Foundation, 30 March 2024.
- Cox, R. (2024). Timeline of the xz Open Source Attack. Research note, 2024.
- Supply-chain Levels for Software Artifacts (n.d.). Provenance. SLSA Specification, version 1.2.
- Supply-chain Levels for Software Artifacts (n.d.). Build: Verifying Artifacts. SLSA Specification, version 1.2.
- The Update Framework (2024). Overview. TUF Documentation, last updated October 2024.
- Rekhi, S., Amberiadis, K., Akib, A. A., and Srivastava, A. (2025). Analyzing Collusion Threats in the Semiconductor Supply Chain. NIST Cybersecurity White Paper 46. DOI: 10.6028/NIST.CSWP.46.
- National Institute of Standards and Technology (n.d.). Supply Chain. NIST Mobile Threat Catalogue.
- Cybersecurity and Infrastructure Security Agency (n.d.). Known Exploited Vulnerabilities Catalog. CISA vulnerability catalogue.
- UK National Cyber Security Centre (n.d.). Vulnerability Management: Carry Out Assessments. NCSC vulnerability management guidance.
- Charrier, C., and Semrau, J. (2023). Analysis of Time-to-Exploit Trends: 2021–2022. Mandiant / Google Threat Intelligence, 28 September 2023.
- Charrier, C., and Weiner, R. (2024). How Low Can You Go? An Analysis of 2023 Time-to-Exploit Trends. Mandiant / Google Threat Intelligence, 15 October 2024.
- Mandiant (2026). M-Trends 2026: Data, Insights, and Strategies From the Frontlines. Google Threat Intelligence.
- Fang, R., Bindu, R., Gupta, A., and Kang, D. (2024). LLM Agents Can Autonomously Exploit One-Day Vulnerabilities. arXiv preprint 2404.08144.
- Grunewald, R., Mazumdar, S., and Vanderlee, K. (2026). Vulnerability Discovery and Exploitation Trends in the AI Era. Google Threat Intelligence Group, 1 October 2026.
- UK AI Security Institute (2026). How Far Behind the Frontier Are Leading Open-Weight Models on Cyber? AISI Work.
- International AI Safety Report (2026). International AI Safety Report 2026. Section 3.4, Open-weight models.
- The PHP Foundation (2026). Today's PHP Security Release, and How We're Strengthening PHP Security. The PHP Foundation Blog, 21 October 2026.
- CVE Program (n.d.). Common Vulnerabilities and Exposures: CVE Program Mission and Records. CVE Program.
- FIRST (n.d.). Common Vulnerability Scoring System (CVSS) v4.0: User Guide. FIRST.org, document version 1.2.